一文讲透 Claude Code 的子代理到底有几种
我为什么要研究这个
我一直不太喜欢用子代理。
之前写《不要随便用子代理模式啊》和《Fable5.1太贵了,我不得不用子代理降本增效》,核心态度就一句话:子代理又贵效果又差,能不用就不用。这个态度至今没变。
但不得不用的时候,我发现了一些之前没注意到的东西。
我在用 Claude Code(Fable 5.1 做主模型)的过程中,注意到它派出来的子代理不太一样。有时候子代理好像带着"完整记忆"出生,知道我和主代理之前聊了什么;有时候又像一张白纸,只拿到了一份任务书就开始干活。有些子代理只搜文件不动代码,有些什么都能干。
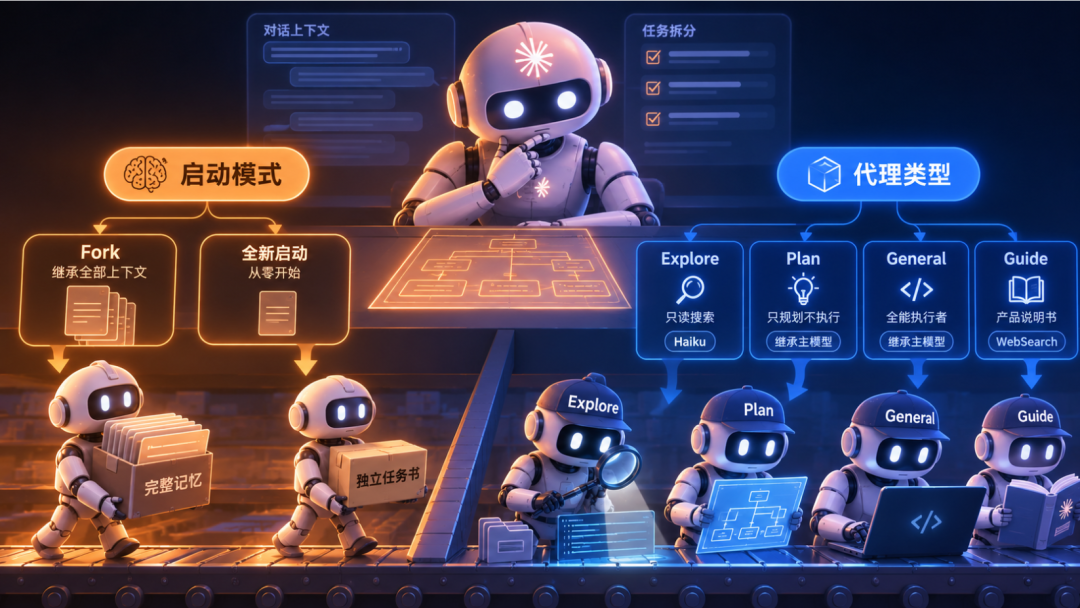
我去查了一下,发现子代理的启动分成了两种模式:fork(继承全部上下文)和全新启动(从零开始)。然后代理本身又分成了好几个类型,每个类型的工具权限、默认模型都不一样。
这让我意识到,"子代理"不是一个笼统的概念,它内部有清晰的分类。
我之前写过《别再只说"子Agent"了,Agent 之间的关系远比你想的复杂》,用"控制对称性 × 目标关系"两个维度穷举了 Agent 之间的 10 种关系类型。但那篇讨论的是 Agent 之间的"关系",相当于图里的"边"。子代理自身到底分哪些种类、每种有什么区别,相当于图里的"节点怎么配置",这块我一直没深入研究过。
这次索性一起搞清楚。
子代理有什么用
在展开分类之前,先回答一个前置问题:为什么主代理不自己把活干了,要派子代理出去?
并行加速。 主代理一个人做三件事只能串行,派出三个子代理可以同时做。这是最直观的理由。
减轻主对话的上下文负担。 子代理做事的中间过程(搜索了哪些文件、试了哪些方案、哪些失败了)不会回到主对话里,主代理只拿到最终结果。这样主对话的上下文不会因为子任务的执行细节而不断膨胀。对话越长,这个好处越明显。
安全试探。 这一点容易被忽略。你想试一个方向但不确定行不行,如果在主对话里直接试,试错过程中的中间状态、失败尝试、错误推理都会留在上下文里,变成噪声,影响模型后续的判断质量。派一个子代理出去试,成功了把结果带回来,失败了直接丢弃,主对话的上下文完全不受污染。就像 git 的分支:在分支上怎么折腾都行,搞砸了删掉分支,主干始终干净。
不过话说回来,这三个好处都是工程妥协。子代理的隐性成本是真实的:系统提示词要重复加载、工具定义要重新发送、上下文要复制或重建,这些都是钱。而且子代理做出来的效果通常不如主代理亲自做,因为信息在传递过程中不可避免地会损耗。
两个正交维度
创建一个子代理时,实际上有两个独立的决策在同时发生。
第一个决策:启动模式。它出生时带不带记忆?
第二个决策:代理类型。它能干什么、用什么模型、扮演什么角色?
这两个决策互不干扰。启动模式决定"信息量",代理类型决定"能力范围"。你可以有一个带着完整记忆出生的只读搜索代理,也可以有一个从零开始的全能执行代理。排列组合就描述了一个子代理实例的完整配置。
下面分别展开。
启动模式:出生时带不带记忆
这个维度只有两个选项。
全新启动,就是给子代理一份独立的任务书,它从零开始工作。它不知道你和主代理之前聊了什么、做了什么决定、踩过什么坑。所有它需要知道的信息,都必须写在任务书里。
这份任务书是主代理自己撰写的,不需要你来写。你给主代理一个目标,主代理自己决定怎么拆分、每个子任务的 prompt 怎么组织。你作为用户通常看不到也不需要关心这些 prompt 的具体内容。
全新启动适合任务规格能脱离对话历史独立成立的场景。比如"搜索项目里所有调用了某个函数的文件",这个目标一句话就能说清楚,不需要子代理知道你花了一个小时讨论架构的全过程。
Fork,就是把主对话的全部历史复制一份带走。子代理"知道"你们之前讨论了什么、否定了哪些方案、确定了什么约束。它带着完整的记忆出生。
Fork 适合任务规格没法脱离对话历史独立成立的场景。有些任务的约束散落在对话的各个角落里,有些是隐含的(比如你否决了方案 B,但没有显式写下"不要用方案 B"这条规则),很难浓缩成一段独立的 prompt。Fork 让子代理直接继承这一切,省去了手动浓缩上下文的麻烦。
代价也很直接:上下文有多大,它就要把多大的输入重新发一遍。
选择标准就一句话:任务规格能不能脱离对话历史独立成立?能,全新启动;不能,fork。 大多数执行类任务全新启动就够了。
关于 fork 的成本,有一个技术细节值得知道。Anthropic 的 prompt cache 是基于前缀精确匹配的,从请求的第一个字节开始比对,前缀完全一致才能命中缓存。而主代理请求的头部(系统提示词 + 工具定义)跟子代理请求的头部不一样,哪怕对话历史部分完全相同,因为头部对不上,主代理的缓存无法被 fork 子代理复用。所以第一次 fork 必然全量重发整个上下文。第二次以及之后的同类型 fork,因为跟第一次的请求前缀一致,才能复用缓存。
这意味着什么?如果你只 fork 一次(大多数情况),缓存优化帮不到你。Fork 的缓存优势只在"批量 fork 同类型子代理"时才生效,而这个场景其实很窄。
还有一个容易踩的坑:Claude Code 从 v2.1.232 开始,在交互式会话中默认开启 fork。也就是说,很多本来全新启动就够了的任务,也会被 fork,造成不必要的 token 消耗。(我在《Fable5.1太贵了,我不得不用子代理降本增效》里详细讲过这个教训,三十五万 token 就是这么烧掉的。)
代理类型:能干什么、用什么模型
启动模式解决的是"信息量"问题,代理类型解决的是"能力范围"问题。
一个代理类型同时打包定义了三件事:
工具权限,这个代理被允许调用哪些工具。能不能编辑文件?能不能执行命令?能不能搜索网页?工具权限划定了它的能力边界。
默认模型,用哪个 LLM 来驱动它。Haiku 便宜快速但推理能力弱一些,Opus 能力更强但消耗更多额度,还是直接继承主模型?
角色定位,它被设计来做什么类型的工作。是到处翻文件找信息的侦察兵,还是想方案但不动手的参谋,还是什么都能干的全能执行者?
这三件事合在一起,构成了一个"岗位模板"。
Claude Code 目前有四种内置类型。
Explore,侦察兵。
只读搜索代理。只能用 Glob、Grep、Read 这些只读工具,不能编辑任何文件。默认跑 Haiku,因为搜索任务不需要最强推理能力,便宜快速就够了。
什么时候被派出去?当主代理需要在大量文件里找某个信息的时候。比如"这个函数在哪些文件里被调用了""项目里有没有用到某个已弃用的依赖"。它的定位就是高频低复杂度的搜索,翻完文件汇报结果,任务结束。
Plan,参谋。
规划代理。也是只读工具,不能改代码。但跟 Explore 不一样的是,它继承主模型,因为规划需要跟主代理一样的思考深度。你可以通过 /plan 命令显式触发它,也可以在需要设计方案时被自动调用。
它跟 Explore 的区别在于:Explore 是在"找东西",Plan 是在"想方案"。Explore 回来告诉你"这个函数在这五个文件里被调用了",Plan 回来告诉你"我建议分三步重构,第一步先抽象接口……"。一个是信息收集,一个是方案设计。
general-purpose,全能执行者。
通用代理。拥有全部工具权限,能读能写能执行命令,是一个完整的"干活"代理。当主代理需要一个子代理但没有指定具体类型时,默认就是这种。
claude-code-guide,说明书。
帮助代理。只有 WebSearch 和 Read 权限。这个比较特殊,它的服务对象不是代码项目,而是你本人。当你问"Claude Code 怎么配置 hook""怎么用自定义代理"这类产品使用问题时,它会被调用。
它跟其他三种代理的最大区别在于:其他代理是帮你完成项目里的技术任务,它是帮你学会使用 Claude Code 这个工具本身。所以它只需要搜文档和读配置文件的能力,不需要碰代码。
讲完这四种内置类型,有一个关键洞察值得单独拿出来说。
注意看 Plan 代理的"不能改代码"。这不是因为它的系统提示词里写了"请不要改代码",而是它的工具列表里根本就没有编辑工具。它"做不到"修改代码,不是"被告知不要"修改代码。这是一道物理门禁。
对比一下:如果你让 general-purpose 代理"只做规划,不要修改任何文件",这是提示词约束。模型可能听,也可能不听。我在《Fable5.1太贵了》里用实际经历验证过这一点:Opus 4.6 作为主模型运行时,直接无视了 CLAUDE.md 里写的明确禁令,读了、理解了、事后也承认了,但执行时就是没当回事。
所以 Plan 代理的存在意义,本质上就是把"只规划不执行"这条规则从提示词约束升级成了机械约束。Explore 代理同理,它的只读权限也是工具列表层面的限制,不是靠提示词"请不要写文件"来保证的。
接下来要强调一点:上面讲的模型分配、工具权限,全是默认配置,不是硬性限制。你完全可以规定所有子代理一律用 Opus,不许用 Haiku。也可以给 Explore 加上写权限(虽然没什么必要)。内置类型提供的是一组合理的出厂设置,你根据自己的场景可以全部覆盖。
那四种内置类型不够用怎么办?
Claude Code 允许你自己定义新的代理类型。做法是在项目的 .claude/agents/ 目录下创建一个 Markdown 文件,用 YAML frontmatter 来声明配置。你可以指定:
专属系统提示词,告诉它应该以什么风格和原则工作允许的工具列表,精确控制它能做什么不能做什么默认模型,可以指定 Opus、Sonnet 或 Haiku权限模式专属 hooks
比如你可以定义一个叫 code-reviewer 的代理,给它只读工具权限、继承主模型、系统提示词里写明"你是一个代码审查者,只提出问题不直接修改代码"。这样你就得到了一个比内置的 Plan 代理更贴合你项目需求的自定义类型。
我在《Fable5.1太贵了》里提到的 opus48-worker、opus5-worker,就是用这个机制定义的自定义代理类型。每个自定义代理指定了自己用什么模型、有什么权限,从而实现了"Fable 负责设计审查,便宜模型负责执行"的分层架构。
这里要特别说清楚一件事:自定义代理跟内置类型不是两个维度的东西。它们都是"代理类型"这个维度上的取值,只是来源不同,一个产品自带,一个你自己写。就像编程语言里 int 和你自定义的 UserProfile 类都是"类型",不会因为来源不同就变成两个维度。
两个维度是正交的
前面分别讲了启动模式和代理类型,这里把它们拉通看一下。
这两个维度互不干扰。启动模式决定"带不带记忆出生",代理类型决定"出生后能干什么"。它们的排列组合就是一个子代理实例的完整配置。
举个具体的例子。假设你跟主代理讨论了一个小时的架构方案,现在要做两件事。
第一件,查一下项目里哪些文件还在用已弃用的 API。主代理会派出一个 Explore 代理,用全新启动模式。启动模式选全新,因为"搜索所有调用了 deprecated_api_v1 的文件"这个目标不需要任何背景就能执行。代理类型选 Explore,因为这个任务只需要读文件,不需要写。它用 Haiku 模型快速扫一遍项目,汇报结果,任务结束。
第二件,让另一个代理拿着全部架构讨论的背景去实现用户认证模块。主代理会派出一个 general-purpose 代理(或者你自定义的 opus5-worker),用 fork 模式。启动模式选 fork,因为认证模块的设计约束散落在一个小时的讨论中,没法独立写成一段 prompt。代理类型选 general-purpose,因为实现模块需要读写执行全部能力。
两个子代理,启动模式不同,代理类型不同。如果你不理解这两个维度,就只能笼统地说"用了两个子代理",搞不清楚为什么一个很便宜一个很贵,为什么一个只搜了搜文件另一个却在大刀阔斧地改代码。
为什么代理总喜欢把活分出去
理解了子代理的分类之后,聊一个实际使用中几乎所有人都会遇到的现象。
你有没有注意到,主代理特别喜欢派子代理出去干活,而不是自己干。更夸张的是,子代理接到任务之后,有时候还会继续往下派孙代理。明明自己做也就那么几步的事,它偏要层层分发。
第一反应你可能觉得它在偷懒。但仔细想想,这不是"偷懒",是好几层因素叠在一起的结果。
工具可用性偏差。 子代理调用本质上就是模型工具列表里的一个工具。模型在训练过程中学到了一个模式:当工具可用时,倾向于使用它。你给一个人一把锤子,他看什么都像钉子。子代理工具在列表里,模型遇到可以拆分的任务就想用它,哪怕自己直接做更高效。
分解问题的惯性。 LLM 被大量训练过"把复杂问题拆成小步骤"的思维方式。这个能力本身很有价值,但当子代理工具可用时,"拆解"容易滑向"分发"。模型跳过了一个关键判断:拆分了之后,应该自己按顺序做,还是分发出去?它擅长分解问题,但缺乏"分解了之后该不该分发"的元决策能力。
没有成本意识。 你知道每次子代理调用都有隐性开销(系统提示词重复加载、上下文复制、工具定义重发),但模型不"感受"这个成本。从模型的视角看,写一句"派一个子代理去搜索"跟自己写一段搜索逻辑,在生成层面差不多(都是生成几十个 token)。但在实际 token 消耗上,前者可能贵十倍。模型没有被训练过去优化 token 经济性,所以它会选择"看起来更结构化"的方案(分发),而不是"实际更便宜"的方案(自己做)。
系统提示词的隐含鼓励。 Claude Code 的系统提示词里描述了子代理的能力和使用场景,比如"可以用 Explore 代理来搜索文件""可以并行派发多个子任务来加速"。这些描述本身没错,但模型会把它们理解成一种隐含的鼓励。就像你在员工手册里写了"可以申请出差",有些员工就会把能线上解决的事情也申请出差来做。
子代理也有分发工具,递归就形成了。 子代理派孙代理的原因很简单:如果子代理的工具列表里也包含了"分发子任务"这个工具,它面对自己的任务时,会经历跟主代理完全一样的推理过程。遇到任务,觉得可以拆,发现自己有分发工具,于是继续派。这就形成了递归分发。
怎么治?核心原则跟《Fable5.1太贵了》里验证过的一样:不靠提示词约束,靠机械约束。你在 CLAUDE.md 里写"尽量自己做,少用子代理",模型对成本没有直觉,不知道"尽量"的阈值在哪里,这条约束基本形同虚设。要真正管住,得用工程手段:在工具调用层挂拦截器,不满足条件时直接拒绝子代理调用;限制递归深度,不让子代理再派孙代理;或者干脆在某些代理类型的工具列表里删掉分发功能。
跟我之前的研究怎么接上
写到这里,可以把这篇文章跟《别再只说"子Agent"了,Agent 之间的关系远比你想的复杂》接上了。
那篇文章研究的是 Agent 之间的"关系",是图里的"边"。用"控制对称性 × 目标关系"两个维度推导出了 10 种基本关系类型。这篇文章研究的是子代理"自身的属性",是图里的"节点怎么配置"。两者不在同一个分析层面,不冲突,互补。
在关系框架里,Claude Code 的所有子代理,不管启动模式是 fork 还是全新、不管代理类型是 Explore 还是 general-purpose,跟主代理的关系都落在同一个格子里:"控制不对称 + 目标派生"。主代理分配任务、能叫停、决定要不要接受结果。子代理的目标从主代理的任务中派生出来。
但在这个大类内部,不同的代理类型会偏向不同的子类型。Explore 代理更偏"父子控制型"(指哪打哪,做完就收),general-purpose 代理更偏"委托型"(主代理只说"实现认证模块",具体怎么做由它自己决定)。
结尾
子代理不是一个笼统的概念,它有两个正交的维度。
启动模式决定信息量:fork 带着完整记忆出生,全新启动从一张白纸开始。大多数执行类任务全新启动就够了。
代理类型决定能力范围:内置四种类型(Explore、Plan、general-purpose、claude-code-guide)提供了不同的工具权限、默认模型和角色定位,你还可以通过自定义代理添加新的类型。
搞清楚这两个维度,你就不再笼统地说"用了个子代理",而是知道它是怎么出生的、能干什么、为什么被这样配置。
当然,我的核心态度没变:子代理能不用就不用。但如果不得不用,至少要清楚自己在用的到底是什么。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。