如何从零做一个自己的网页版 AI
我们有一个 Max 账号,每周的 Opus 额度总是用不完,就想搞点有意思的事。于是想到一个念头:做一个自己的网页版 AI 工具,类似 claude.ai 那样的东西。
一开始觉得挺简单。模型的调用能力已经有了,套个前端页面,对话框加消息列表,接上去就行了。
我们真的这么做了,搞出来一个最简版本。能发消息,能收回复。但用了两天就发现,这个东西和 claude.ai 之间差得很远。
之前写《大模型的脑子本身也是个Agent吗?》的时候,我们拆过一个公式:
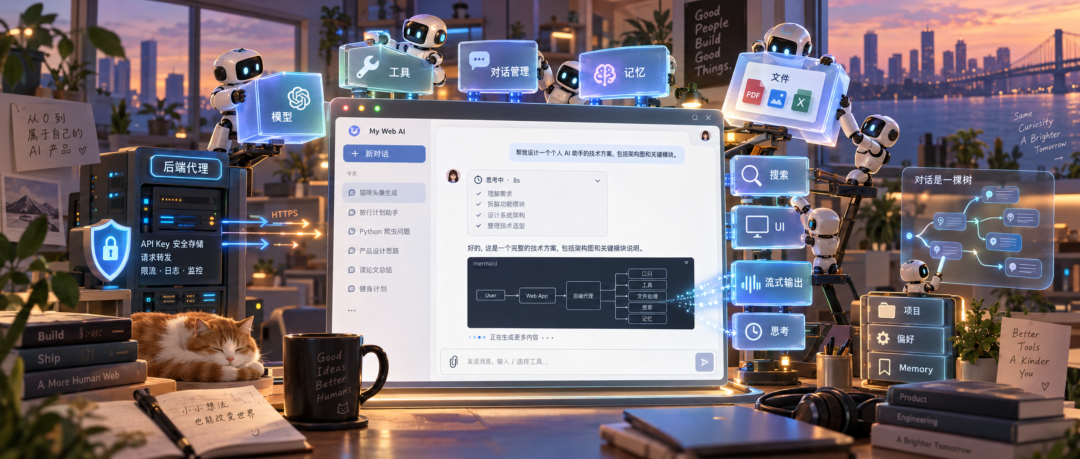
网页端 = 模型 + 工具 + 对话管理 + 记忆 + 文件处理 + UI那会儿是站在外面分析别人家的产品,这次是自己动手搭,才发现公式里的每一个加号,都不是摆设。
这篇把我们一个一个补零件的过程理一遍。
先得有个中间层
最先要解决的问题不在前端,在后端。
浏览器没法直接去调模型。一是跨域问题,二是调用凭证放在前端代码里等于公开。所以中间必须有一个自己的后端服务做代理:前端把消息发给自己的后端,后端去调模型,再把响应转发回来。
而且每次调用不是只发用户刚打的这一条消息。模型本身没有记忆,每一次收到的都是从头到尾完整的对话记录,靠这个来理解上下文。所以后端在转发之前,要把整个对话历史拼成一个消息数组,一起发过去。
对话的最前面还有一条用户看不到的消息,叫 System Prompt。它预先告诉模型应该遵守什么规则、用什么风格回答。这条消息是整个对话的"底色"。后面会讲到的 User Preferences 和 Projects,最终都是往这条 System Prompt 里注入内容。
这个后端代理层是整个架构的骨架,后面所有功能都长在它上面。
回复不能一口气吐出来
后端搭好之后,最先碰到的体验问题来自一个看似很小的细节:我们最初的版本等模型把整条回复全部生成完,再一次性显示出来。
短回答还好。稍微长一点的回复,用户盯着空白框等十几秒,不知道它是在想还是卡了。那种等待感非常难受。
claude.ai 的做法是流式输出,回复一个字一个字往外冒,用户马上就知道"它在说话"。技术上走的是 SSE(Server-Sent Events),模型把生成过程拆成一连串小事件推过来,后端代理层把这些事件原样转发给前端,前端收一个渲染一个。
但流式渲染不是把文字追加到页面上就完了。
回复里带着 Markdown 格式:代码块、表格、加粗。一个代码块可能写到一半,三个反引号还没闭合,这时候如果按纯文本渲染,页面上就会冒出一堆原始的 Markdown 符号,乱成一团。所以前端需要一套能处理"半成品 Markdown"的渲染逻辑,一边接收文本,一边做语法判断,等结构闭合了再渲染成最终样式。
流式输出解决之后,对话的基本循环才算真正跑通了。
围绕一条消息还能做什么
基本循环跑通了,但回复出来之后呢?
我们最初的版本里,一条消息生成完就定在那了。实际用起来很快碰到几个场景。
想把某条回复复制到别的地方用,没有复制按钮,手动选中文字经常选不准,尤其是代码块。加一个一键复制按钮,很小的事,但没有的话每次都要多操作好几步。
回复生成到一半发现方向不对,想打断,没有停止按钮,只能干等它说完。等它花了三十秒说完一大段你不想要的东西,然后再重新问一遍,浪费的不只是时间,还有配额。
这两个加上去都比较简单。真正需要想清楚的是下面两个功能:重新生成和消息编辑。
在《你和 AI 的对话,从来就不该是线性的》里我们聊过,对话的本质结构是一棵树,来回修改和分支探索才是使用大模型最高效的方式。
落到产品上就是两件事。
重新生成:对同一条提问,让 AI 重新回答一次。多次重新生成的版本不会互相覆盖,而是并列存在,用箭头在版本之间来回切换对比,挑最满意的那个。
消息编辑:回到之前某条消息修改措辞,修改之后从那个位置重新生成,后续的内容形成一条新的对话分支。原来的分支不会消失,随时可以切回去。
这两个功能看起来各自独立,但背后其实是同一个数据模型:对话不再是一个线性数组,而是一棵树。每条消息有一个 parent_id 指向它的上一条,编辑和重新生成都是在树上长出新的兄弟节点。界面上用箭头在兄弟节点之间切换,用户看到的始终是树上的一条路径。
这个数据模型一旦想明白,复制、停止、重新生成、编辑这几个功能就都顺理成章了。它们不是零散的小需求,是围绕"对话是一棵树"这个核心模型长出来的一组操作。
让 AI 碰到外面的东西
到这里,纯文本聊天的体验已经像模像样了。但一个根本的限制摆在那:AI 只能处理用户打字发过来的内容。
工作中最常见的场景呢?扔一个 PDF 让它总结,贴一张图让它看,问一个今天刚发生的事。全做不了。
起初我们觉得这些是锦上添花的功能,先搞个简陋版就行,把各种工具调用全关了,只保留最基本的对话。
结果发现不行。关了之后 AI 连搜索都做不了,碰到任何需要实时信息的问题只能说"我不知道"。用过 claude.ai 的人再来用这个,体验落差太大了。
所以工具调用不是可选项,是必须的基础设施。
工具的运作原理在《大模型的脑子本身也是个Agent吗?》里拆过了,这里不重复。说说具体要做哪些。
至少两件事。
联网搜索。给 AI 挂上搜索工具和网页读取工具,让它能自己决定搜什么关键词,读取搜索结果的全文,然后基于搜到的内容回答。这个搜索过程可能不止一轮,AI 搜完一次觉得信息不够,会自己再搜一次。
文件上传。图片走 base64 编码随消息一起发给模型。PDF、Word、Excel 这些没法直接塞进消息里,需要存到服务端的一个隔离目录,然后通过工具让 AI 去读取文件内容。
这两件事做完,AI 才算从一个只能打字聊天的工具,变成一个真正能干活的助手。
有些问题需要先想再答
工具加上之后 AI 能做的事多了很多。但碰到另一类问题:有些任务比较复杂,AI 直接给出的第一反应往往不够好。编程题、数学推理、需要多步分析的问题,一步到位给的答案经常有漏洞。
claude.ai 有一个叫 Extended Thinking 的功能。开启后,AI 不会直接给答案,而是先做一轮内部推理,想清楚了再给最终回答。
用户在界面上看到的是一个可折叠的块,显示"思考了多少秒"。具体的思考内容目前不对用户开放,用户看不到 AI 内部的推理过程,只能看到最终结论。但这一轮内部推理确实会显著提升复杂问题的回答质量。
前端的处理和普通回复不一样。API 推过来的事件流里,思考部分走的是 thinking_delta,正文走的是 text_delta,前端需要把这两种事件分开接收、分开渲染。思考部分在流式输出过程中显示为"正在思考...",完成后折叠成一个摘要块,下面才是正式回答。
用户还可以控制要不要开启思考,以及思考的投入程度(effort level)。简单问题关掉思考,响应更快;复杂问题拉高思考深度,答案更靠谱。
每次新对话都从零开始
对话内的体验到这里已经打磨得差不多了。但一个问题很明显:每开一个新对话,AI 就把你忘得干干净净。
上一轮对话里告诉过它项目背景、技术栈偏好、甚至名字,开一个新对话,全没了。又得从头说起。
这件事要从两个方向解决。
第一个方向是 Memory,自动的。AI 在对话过程中提取出值得记住的信息:用户的名字、工作背景、反复出现的偏好。这些信息存到一个独立的存储里,跟具体的对话记录分开。下次开新对话时,这些记忆作为上下文自动注入,AI 不用被重新介绍一遍就知道在跟谁说话。
关键是要给用户控制感。用户可以随时查看"AI 记住了我什么",可以逐条编辑,可以一键删除全部。记忆不是黑箱。
第二个方向是 User Preferences,手动的。用户在设置页面写一段全局指令,比如"回复用中文""我是后端开发,少解释基础概念""代码示例用 Python"。这段指令所有新对话自动带上,不用每次都叮嘱一遍。
一个被动收集,一个主动设定。它们看起来像两个功能,技术上其实是同一件事:往第一节讲的 System Prompt 里注入内容。Memory 是系统自动注入的,User Preferences 是用户手动写入的,最终都拼在模型每次收到的第一条消息里。
不同的活该用不同的模型
用了一段时间之后还有一个感受:不是所有问题都需要最强的模型。
随手问一个简单问题,用 Haiku 就够了,响应快,配额消耗也小。真正需要深度推理的复杂任务,再上 Opus。
所以理想情况下需要一个模型选择器,让用户在对话中随时切换。claude.ai 是在聊天框上方放了一个下拉选择器,而且支持中途切换,上下文保持连贯,不会因为换了模型就丢掉前面说的话。
这个道理我们想清楚了,但目前不准备做。
对话多了之后的管理
用了一段时间之后,侧边栏的对话列表会堆起来很多条。找之前某个对话全靠从上往下翻,翻到第三屏就开始崩溃。
首先要解决的是对话标题。最简版本里每个新对话都叫"New Chat",多了之后侧边栏里一排灰色的 New Chat,根本分不清谁是谁。claude.ai 的做法是在每个新对话的第一轮结束后,自动根据对话内容生成一个简短的标题显示在侧边栏。这个功能实现起来不难,额外调一次模型让它起个名字就行,但对日常使用的体验提升非常大。
然后是搜索、重命名、置顶、删除这些管理功能,对话一多就成了刚需。
再往前一步,有些工作是持续性的。一个项目要反复和 AI 讨论,每次开新对话都得重新交代一遍背景和规则。claude.ai 的 Projects 功能解决这个问题:给一组对话设定共享的系统指令和参考文件,相当于一个专属工作空间。同一个 Project 下的所有对话自动继承这些预设,不用每次都重复交代。
对话越来越长会撞墙
最后一个问题。
第一节讲过,每次调用模型要把整个对话历史拼成数组发过去。对话越长,这个数组越大。
但模型的上下文窗口是有上限的。撞到上限之后,模型要么报错,要么开始丢失早期的对话内容,回复里出现前后矛盾,或者重复问已经说过的事情。
解决办法是做上下文压缩:当对话接近上限时,对早期的消息做摘要,用更短的文字保留关键信息,然后替换掉原始的早期消息。这样对话可以一直持续下去,代价是早期的细节会被压缩成概要,具体的措辞和数字可能丢失。
claude.ai 把这个叫 Context Compaction,在长对话中自动触发,用户无感知。
最后
做这件事之前,我们以为最难的部分是模型本身。做了才知道,模型能力是地基,地基上面这些零件加起来的工作量,比预想的大很多。在《大模型的脑子本身也是个Agent吗?》里拆过那个公式,当时只是分析。自己搭一遍才有真正的感觉。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。