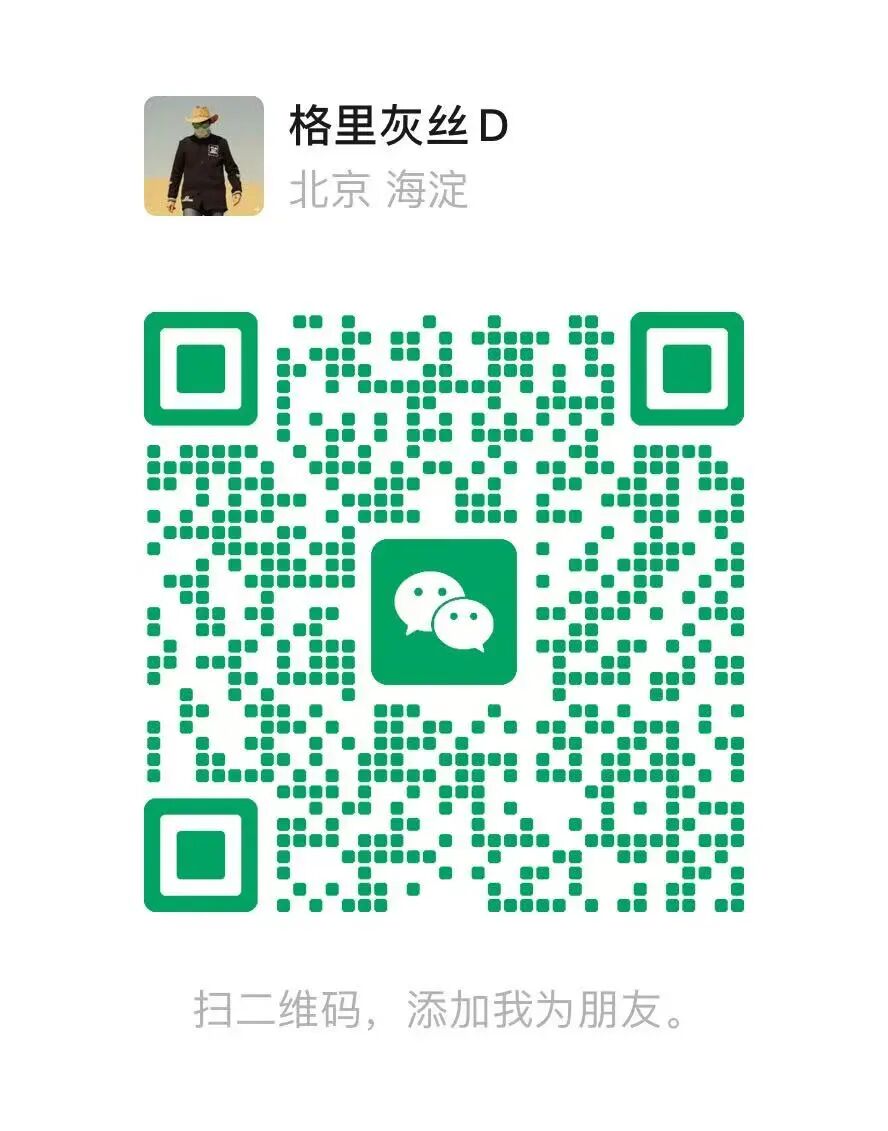
Fable 5.1 终于可以自由切换 effort 了
一、起因
今天凌晨,Claude Fable 5.1 终于发布了。
翻了一遍发布文档和迁移指南,大部分内容是意料之中的:cache read 降价、thinking block 的兼容性变化、forced tool use 不再支持。但有一条新功能让我停下来多看了几眼:
切换 effort 级别不再破坏提示缓存。
这个问题我之前在写《大模型缓存机制完全指南》和《一文讲透大模型对话的缓存计费机制》的时候就注意到了。在那两篇文章里我反复强调过一条核心规则:缓存的 key 是根据请求前缀的精确字节算出来的,任何改动都会导致缓存失效。切换模型是最贵的操作,切换 effort 也一样。所以当时的结论是:选定一个 effort 就别动了。
现在 Fable 5.1 说这个限制解除了,非常神奇,这是怎么做到的呢?
二、先说一下 effort 是什么
effort 是 Anthropic API 上的一个参数,控制模型"思考的深度"。Claude 的新模型都自带自适应思考(adaptive thinking),effort 参数决定模型在回答之前花多少力气去推理。
目前有五个级别:low、medium、high、xhigh、max。low 适合简单任务,模型几乎不怎么"想",直接给答案,速度快,token 消耗少。high 是 API 和 Claude Code 中的默认值,适合大多数编程和分析任务。xhigh 和 max 用于特别难的推理问题,模型会花大量 token 在内部思考链上。
一个直觉的用法是:在同一个 session 中,简单步骤降到 low 省钱省时间,难题拉到 xhigh 让模型多想想。这是 effort 参数设计的初衷。
但在 Fable 5.1 之前,这个用法有一个昂贵的副作用。
三、旧机制:为什么切换 effort 会打碎缓存
这里需要回忆一下 prompt cache 的工作原理。如果你读过我之前的《大模型缓存机制完全指南》,应该记得那条核心规则:
缓存的 key 是根据请求前缀的精确字节算出来的。从第一个 token 开始逐个比对,完全一致的部分直接复用,遇到第一个不同的 token 就停下,从这里开始往后全部重算。
在 Fable 5 以及之前所有支持 effort 参数的模型上,effort 被纳入了缓存 key 的计算。
effort 在 API 请求中长这样:
{"model": "claude-fable-5","output_config": { "effort": "high" },"system": [...],"messages": [...]}
output_config.effort 是一个请求级别的参数,和 model、max_tokens 同级。它不在消息序列里面,而是在消息序列外面,属于这次请求的"元数据"。
缓存系统在计算 key 的时候,把这个元数据也纳入了。所以同样的消息内容,effort=high 和 effort=low 算出来的缓存 key 不同,后者命中不了前者的缓存,整个前缀要全价重新处理。
这在逻辑上其实是不合理的。effort 控制的是模型的输出行为(思考多深),和输入内容的 KV 计算没有关系。它应该在模型开始生成输出时才起作用,不应该影响输入前缀的缓存匹配。但旧的实现把它当成了整个请求的全局属性,和输入内容绑在了一起,一改就得整体替换。
这个设计的实际后果是:如果你在 Claude Code 中途从 high 切到 low,下一次请求会把整个对话历史全价重新处理。Claude Code 甚至会弹一个确认对话框警告你:"This conversation is cached for the current effort level. Switching to xhigh means the full history gets re-read on your next message."(这个对话已经为当前 effort 级别建立了缓存。切换到 xhigh 意味着下一条消息会全价重读整个历史。)
如果你的对话已经积累了十万个 token 的历史,这一次切换就要多花相当于十万 token 的 cache write 费用。
所以大家的实际做法就变成了:选定一个 effort 就别动了。简单任务也用 high,认了。
四、Fable 5.1 的解法
Fable 5.1 引入了一个叫 per-message effort(逐消息 effort 控制)的新功能,目前处于 beta 阶段。
核心改动用一句话就能说清楚:effort 的控制粒度从"整个请求共用一个"变成了"每条消息可以有自己的"。
以前的做法,effort 是请求的全局设定:
{"model": "claude-fable-5-1","output_config": { "effort": "high" },"messages": [{"role": "user", "content": "分析一下这段代码的性能问题"},{"role": "assistant", "content": "...(详细分析)..."},{"role": "user", "content": "这个变量名起得好不好"}]}
第二个问题明显很简单,不需要 high effort。但你改不了,一改整个缓存就废了。
现在的做法,effort 可以作为一条消息插在对话流中间:
{"model": "claude-fable-5-1","messages": [{"role": "user", "content": "分析一下这段代码的性能问题"},{"role": "assistant", "content": "...(详细分析)..."},{"role": "system", "output_config": {"effort": "low"}},{"role": "user", "content": "这个变量名起得好不好"}]}
区别在哪?
在旧方式里,effort 在请求的元数据层,是缓存 key 的一部分。改了 effort,key 就变了,整个缓存失效。
在新方式里,effort 是消息流中的一条 system 消息,出现在已缓存前缀的后面。前面的所有内容(系统提示、工具定义、之前的对话轮次)字节完全没变,缓存 key 完全一致,照常命中。effort 指令只影响它后面的模型行为。
缓存不再失效的原因就是这样:不是缓存算法变了,而是 effort 信息的存放位置变了,从"请求元数据"搬到了"消息序列中",从缓存 key 的计算范围里移了出来。以前是整个请求共用一个 effort,改了就得整体替换。现在是每条消息可以有自己的 effort,改变后面的不影响前面的,前面的缓存自然不会失效。
使用这个功能需要加上 beta header mid-conversation-output-config-2026-07-01。设定的 effort 值会应用到紧跟其后的 user turn,并持续生效直到另一条 system 消息再次修改。Fable 5.1、Mythos 5.1 和 Opus 5 都支持。
五、一个更本质的理解角度
从设计思路的角度看,这个改动可以理解得更简洁。
以前,一个请求只有一个 effort,所有消息共用。现在,不同的消息可以用不同的 effort。粒度变细了,改变某一条消息的 effort 设定自然不需要动前面那些消息的任何东西。前面不变,缓存不失效。
这和我在《大模型缓存机制完全指南》里讲的设计原则完全一致:最不可能变的内容放最前面,最容易变的内容放最后面。 Claude Code 的请求结构把全局静态指令放最前面、消息历史放最后面,就是为了保护前缀。现在 effort 也遵循同样的思路:从全局设定变成插在消息尾部的局部指令,让它的变化只发生在序列尾部,不触及前面已缓存的长前缀。
六、同时生效的另一个改动:cache read 降价 75%
Fable 5.1 在发布的同时把 cache read 的价格从每百万 token $1.00 降到了 $0.25,降幅 75%。输入价和输出价完全没变($10/$50),只有 cache read 变便宜了。
在《一文讲透大模型对话的缓存计费机制》中我算过一个完整的计费实例,那个例子里 cache read 占总费用的 2%,看起来不多。但那是因为对话只有三轮。在真实的 agentic 场景下,一个任务可能涉及几十次 API 请求(模型反复调用工具),每一次请求中 cache read 的 token 量都很大。"低单价 × 巨大的量"最终也是一笔可观的开销。降价 75% 直接压缩了这部分成本。
Anthropic 用自己 2026 年 8 月四周的内部数据做了测算:典型工作负载有效成本降低约 25%,上下文密集的 agentic 工作负载最多降低约 45%。
这个降价和 per-message effort 是互相配合的。以前因为怕打碎缓存而不敢切 effort,只能全程 high,白白多花了很多 thinking token。现在可以自由切换,简单步骤用 low 省下大量输出 token,同时 cache read 又便宜了 75%。两个优化叠加,对于频繁调用工具的 Agent 场景,成本下降是实实在在的。
七、小结
回顾一下这个改动的完整脉络。
Fable 5 以及更早的模型上,effort 是请求级别的全局参数,被纳入缓存 key 的计算。切换 effort 导致整个对话前缀的缓存失效,全部内容全价重新处理。
Fable 5.1 把 effort 从"请求元数据"变成了"消息流中的内联指令",控制粒度从整个请求共用一个 effort 变成了每条消息可以用不同的 effort。effort 的变化只发生在消息序列的尾部,不影响前面已缓存的前缀,缓存自然不会失效。
effort 以前放错了位置,放在了全局元数据里,相当于放在了请求结构的"最前面"。现在放对了,放在了消息流的尾部,和其他每轮变化的内容在一起。
一个参数换了个位置,一个困扰所有人的限制就消失了。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。