Prompt Cache 最后的4朵小小乌云
一
上个月有一天,我正用 Fable 5 写一个比较复杂的后端服务。聊了大概十五轮,上下文已经积累了不少。模型对项目结构很熟悉了,改代码又快又准。
然后我注意到模型的回答风格突然变了。
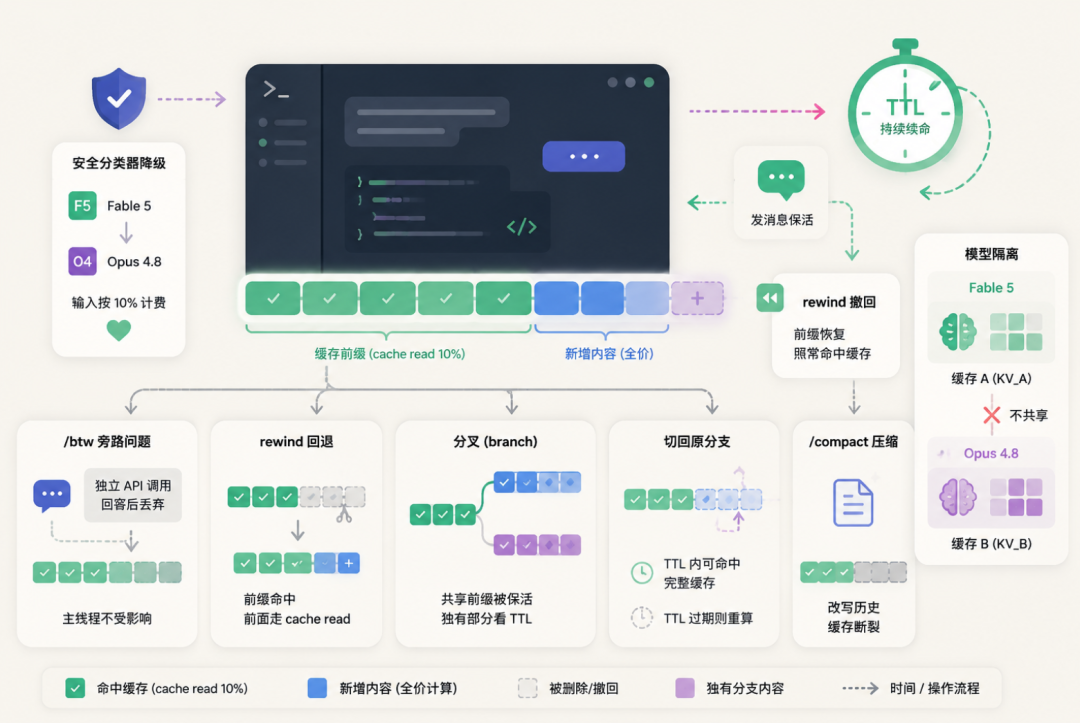
看了一眼状态栏,发现模型不知道什么时候从 Fable 5 变成了 Opus 4.8。不是我切的,是 Fable 5 的安全分类器觉得某个请求有风险,自动降级了。
我当时第一反应不是"为什么降级",而是"我的缓存还在吗"。
之前写《大模型缓存机制完全指南》的时候就知道,切模型是最贵的操作。每个模型有自己独立的缓存,Fable 5 的 KV 不能给 Opus 4.8 用。这意味着十五轮积累起来的缓存前缀,可能一瞬间全部作废。
但这不是我主动切的。是系统替我切的。那这笔重建缓存的费用,算谁的?
二
带着这个问题去翻文档,在 Anthropic 官方 Cookbook 里找到了答案。
结论比我预想的要好:安全分类器触发的降级,有专门的计费规则。
降级到 Opus 4.8 之后,回退请求的输入 token 按缓存读取价计费,按基础价的 10%,不是全价,也不是缓存写入价(1.25 倍或 2 倍)。如果请求在输出任何内容之前就被完全拦截,输入 token 干脆不计费。
也就是说,底层确实发生了一次完整的 KV 重算(Opus 4.8 的权重跟 Fable 5 不同,同样的文字必须重新算),但 Anthropic 在账单上替你承担了大部分。跟自己手动执行 /model 切换的代价完全不同。
手动切模型:整个上下文按 cache write(1.25x)重建 → 最贵分类器降级:整个上下文按 cache read(0.1x)计费 → 官方补贴
这件事让我踏实了一些。但也让我开始想另一个问题:既然切模型的代价这么大,那其他操作呢?我平时用的 /btw、rewind、分叉,这些到底碰没碰缓存?
三
先说 /btw,因为这个最容易搞混。
/btw 的卖点是"不污染主线程上下文"。问一个旁路问题,回答不追加到对话历史里。但"不污染上下文"和"不花钱"是两回事。我一直不确定它到底有没有消耗缓存。
去查了一下,答案是:花钱,但花得很少,而且不影响主线程。
/btw 本质上是一次独立的 API 调用。它把主对话的完整上下文作为输入发给模型,拿到回答后丢弃,不写回主线程。
主线程:Q1-A1 → Q2-A2 → Q3-A3 ← 缓存前缀/btw "这个函数为什么这样写?"↓独立 API 调用:输入 = [系统 + Q1-A1 + Q2-A2 + Q3-A3 + btw问题]←── cache read(10%)────────→ ← 全价 →回答完毕,丢弃,不写入主线程主线程依然是:Q1-A1 → Q2-A2 → Q3-A3 ← 前缀没变
社区有人用 statusline 跟踪过:一次 /btw 调用后成本增加约 $0.08。是真实的 API 调用,走的是缓存读取。但因为主线程前缀完全没变,下一个正式问题照常命中缓存,就像 /btw 从来没发生过一样。
消耗缓存但不污染缓存。知道了,踏实了。
四
接下来是一个我经常遇到的操作:rewind。
写代码经常会走弯路。聊了六轮,觉得第五轮问错了方向,想 rewind 回到第四轮重新来。
直觉上,前四轮没变,不应该重新全价计算。但直觉靠不靠得住?
靠得住。
原始: [系统][Q1-A1][Q2-A2][Q3-A3][Q4-A4][Q5-A5][Q6-A6]←────────────── 完整缓存前缀 ──────────────────→rewind 到第四轮:[系统][Q1-A1][Q2-A2][Q3-A3][Q4-A4]←── 跟原缓存前缀的前半段完全一致 ──→发修改后的 Q5':[系统][Q1-A1][Q2-A2][Q3-A3][Q4-A4][Q5']←──── cache read(10%)──────────→ ← 全价 →
前四轮走缓存读取,新的第五轮全价。这就是前缀匹配规则的直接推论:rewind 删掉了后面的轮次,剩余的前缀跟之前缓存的内容完全一致,当然命中。
但这里有一个细节我当时想了一会儿才想通。第四轮是可能很久以前说的,比如半小时前。缓存的 TTL 对订阅用户是 1 小时,对 API 用户是 5 分钟。半小时前的缓存,没过期吗?
没过期。因为从第四轮到第六轮,中间每一轮请求都在读取包含第四轮的前缀。每次读取都刷新了 TTL 计时器。即使第四轮本身是半小时前的,只要中间一直在持续对话,它的缓存就一直活着。
所以 rewind 对缓存是安全的。Claude Code 官方文档也确认了这一点,把它列在"不会破坏缓存的操作"里。
五
想通了 rewind 之后,我又想到一个骚操作。
有时候我正在写一段代码,上一个问题刚答完,下一个问题还没想好。但我知道缓存有 TTL,订阅用户是 1 小时,API 用户是 5 分钟。如果我想太久,缓存就过期了,下一个问题要全价重建整个上下文。
那能不能在缓存快过期的时候,先随便发条"你好",让模型回复一下,保住缓存?等想好了再 rewind 撤回"你好",发真正的问题?
想了一下,应该可以。
[系统][Q1-A1][Q2-A2] ← 缓存活着,TTL 在倒计时发"你好":[系统][Q1-A1][Q2-A2][你好] ← cache read 命中,TTL 重置 ✅Claude 回复之后 rewind 删掉"你好"这轮:[系统][Q1-A1][Q2-A2] ← 前缀恢复发真正的问题 Q3:[系统][Q1-A1][Q2-A2][Q3] ← cache read 命中 ✅
"你好"那轮虽然被撤回了,但它已经完成了使命:命中缓存并重置了 TTL。rewind 之后前缀恢复到"你好"之前的状态,跟缓存里的条目完全一致,所以下一个真正的问题照常命中。
唯一的前提是:发"你好"的时候缓存还没过期。如果已经超过了 TTL,那"你好"触发的就不是保活,而是缓存重建(cache write),性质完全不同。
后来发现社区早就有人想到了这个,甚至做了一个叫 cache-keepalive 的 Claude Code 插件,在 TTL 快过期时自动注入保活消息。原理完全一样,只是自动化了。
六
到这里,前面几个场景都搞清楚了。但有一个更复杂的情况我一直在想。
实际工作中我经常用分叉。问了六轮,觉得可能走了弯路,rewind 到第四轮分叉出一条新路径试试。在新路径上干了一会儿,发现还是原来的方向对,想切回原始的第六轮继续。
这时候原始第六轮的缓存还在吗?
这个问题用前面学到的规则可以自己推。
原始分支: [系统][Q1..Q4] → [Q5-A5][Q6-A6] ← 分叉后没人访问新分支: [系统][Q1..Q4] → [Q5'-A5'][Q6'-A6'] ← 活跃共享前缀: [系统][Q1..Q4] ← 被新分支持续保活独有前缀: [Q5-A5][Q6-A6] ← 只有原始分支访问过
两条线索交叉。
第一条:共享前缀(Q1 到 Q4)一定还活着。新分支的每次请求都在读它,TTL 持续刷新。
第二条:原始分支独有的 Q5 和 Q6,从分叉那一刻起就没有任何请求在读它了。如果从分叉到现在没有超过 TTL,缓存还在,切回后可以命中完整六轮。如果超过了 TTL,Q5-Q6 的缓存已经过期,切回后只有 Q1-Q4 走缓存,Q5-Q6 全价重算。
核心就一句话:缓存不关心你在哪个分支上工作,它只关心"这段前缀最后一次被任何请求读取是什么时候"。
七
到这一步,我对缓存的使用层面已经没什么疑问了。所有场景都可以用三条规则解释:前缀匹配、模型隔离、TTL 续命。
但有一个问题一直在脑子里转,之前几篇文章都没有彻底回答过。
前缀匹配规则说:中间改了一个 token,后面全部失效。
为什么?
后面的 token 本身没变啊。比如一段十万 token 的对话,我改了第五百个 token,第五百零一到第十万个 token 一个字都没动。为什么这九万九千五百个 token 的缓存不能继续用?
八
这个问题要到 Transformer 的 attention 机制里去找答案。
KV cache 存的不是 token 的文字,而是模型对这个 token 在当前上下文中的"理解"。这个理解是通过 self-attention 计算出来的:每个 token 会对它前面所有 token 做加权求和,提取信息,形成自己的内部表示。
用一个中文例子。
原始序列:我 喜欢 苹果 汁"汁"的 KV 是怎么算出来的:attention(汁→我)+ attention(汁→喜欢)+ attention(汁→苹果)+ attention(汁→汁)= "汁"的 hidden state= "汁"的 KV
"汁"的 KV 值不只取决于"汁"自己,还取决于前面每一个 token 贡献的信息。
现在把"喜欢"改成"讨厌":
修改后:我 讨厌 苹果 汁"汁"的 KV 重新计算:attention(汁→我)+ attention(汁→讨厌) ← 这里变了+ attention(汁→苹果)+ attention(汁→汁)= 不同的 hidden state= 不同的 KV
"汁"这个字本身没变,但它的含义变了。"喜欢苹果汁"里的"汁"和"讨厌苹果汁"里的"汁",在模型的内部表示中是不同的东西。模型可能在第一种情况下把"汁"理解为"一种令人愉悦的饮品",在第二种情况下理解为"一种令人厌恶的液体"。同一个字,不同的上下文,完全不同的内部状态。
同理,"苹果"的 KV 也变了:它前面的"喜欢"变成了"讨厌",它接收到的上下文信息不一样了。从修改点开始,后面每一个 token 的 KV 都像多米诺骨牌一样连锁变化。
原始: 我 喜欢 苹果 汁KV: KV1 KV2 KV3 KV4修改: 我 讨厌 苹果 汁KV: KV1 KV2' KV3' KV4'✅ ❌ ❌ ❌命中 ← 从这里开始全部重算 →
这就是"改一个字后面全部重算"的数学根源。不是缓存系统设计者偷懒只做了前缀匹配,而是 Transformer 的 attention 机制在数学上决定了:只有连续不变的前缀,其 KV 值才保证不变。
反过来也成立。在末尾追加新 token,比如用户发了一条新消息,前面的 KV 完全不受影响。因为因果掩码让每个 token 只看前面不看后面。后面来了什么新内容,跟前面的 KV 无关。
追加: 我 喜欢 苹果 汁 很好喝KV: KV1 KV2 KV3 KV4 KV5(新算)✅ ✅ ✅ ✅ ← 只算这一个
追加对话能命中缓存,修改历史不行。不是规则规定的,是数学决定的。
九
想通了"为什么改中间不行"之后,另一个"为什么"也顺着解开了。
为什么不同模型不能共享缓存?
因为 KV 值是 token 经过模型权重矩阵计算后的中间产物。不同模型的权重不同,同一段文字会产出完全不同的 KV。
同一段输入:"你好世界"Fable5:K = f(token, 权重_Fable5) → K_AV = g(token, 权重_Fable5) → V_AOpus4.8:K = f(token, 权重_Opus4.8) → K_BV = g(token, 权重_Opus4.8) → V_B权重_Fable5 ≠ 权重_Opus4.8→ K_A ≠ K_B→ V_A ≠ V_B
同一段中文经过两个不同翻译引擎,内部的中间表示完全不同。一个引擎的草稿纸不能给另一个引擎用。缓存系统按模型隔离不是人为的限制,是物理上不兼容。
这里有一个容易搞混的地方。"切模型导致缓存失效"不等于"旧模型的缓存被删除"。你从 Fable5 切到 Opus4.8,Fable5 的缓存还在(只要没超过 TTL)。只是 Opus4.8 用不了它。如果你在 TTL 内切回 Fable5,前缀又没变,Fable5 的旧缓存可以继续命中。
十
回头看这一路追下来的问题。
从"系统替我切了模型怎么办"开始,到"/btw 花不花钱",到"rewind 前面的轮次要不要重新付费",到"能不能发个你好续命",到"分叉后还能不能切回来",这些问题看起来五花八门,但答案全部来自同一套规则。
而那套规则本身,又来自 Transformer attention 机制的两个数学性质:每个 token 的 KV 依赖于它前面所有 token(所以改中间就全部重算),每个 token 的 KV 由模型权重算出(所以换模型就不能复用)。
最后整理一张速查表,方便随时对照。
以后遇到新的缓存问题,不用查表。画出前缀变化图,看模型有没有变,看 TTL 有没有过期。答案自己就出来了。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。