深度解读:GLM创始人唐杰眼中的Scaling Law与大模型变强的真正逻辑
引子
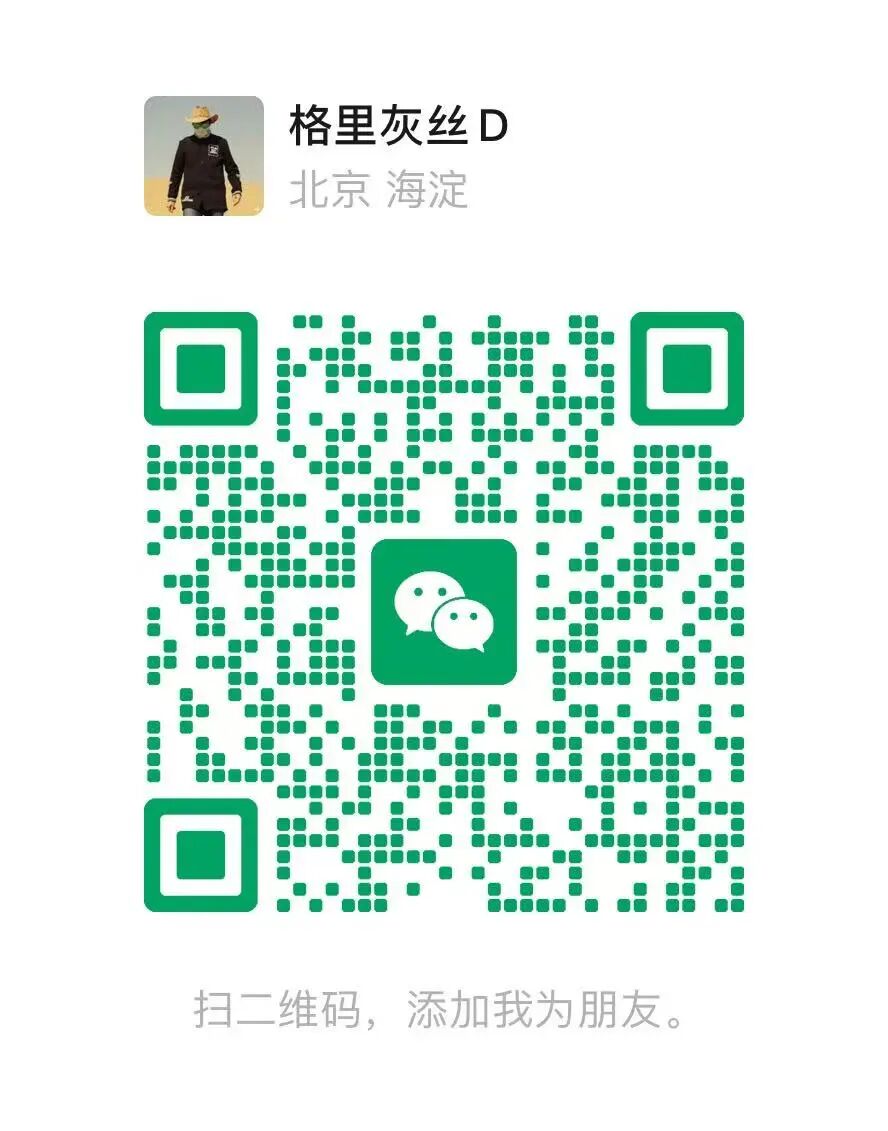
昨天,智谱AI首席科学家、清华大学教授唐杰发了一条推特,标题叫"Thoughts About Scaling Law"。文章不长,却浓缩了大模型领域过去六年最重要的一次认知转变。
他说的核心观点用一句话概括:
Scaling,不只是参数的Scaling。
大模型越来越强,但"强"这件事不再只是靠把模型做大。它背后有一套不断演化的资源分配逻辑。这篇文章要做的事情,就是把这套逻辑从头到尾拆开来看。
这不是一篇论文综述,而是一场持续追问。每回答一个问题,就自然引出下一个更深的问题。我们的目标是:读完之后,你再看到任何一次大模型发布,都不会只问"多少参数"了。
· · ·
一、训练大模型,到底在花什么钱?
在讨论所有问题之前,需要先建立一个最基础的认知。
训练一个大模型的总计算量,可以用一个非常粗略的公式概括:
C ≈ 6 × N × D
其中C是你的GPU总算力(可以理解成你有多少钱),N是模型的参数量,D是训练数据的token数。
这个公式揭示了一个关键事实:训练的过程,本质上是让每一个token流过整个模型的所有参数做一次计算。 参数越多,处理一个token就越慢;要看的token越多,就要重复这个过程越多次。总计算量等于两者相乘。
所以如果你的GPU总算力是固定的(比如你只有1万张A100跑3个月),那N和D就是此消彼长的关系。模型做大了,能看的数据就少了;想多看数据,模型就不能太大。
打个比方:你有固定的8小时。可以花6小时造一个超复杂的笔记系统,再用2小时读书。也可以花2小时造一个简单的笔记系统,然后用6小时读书。造脑子和读书用的是同一份时间。
这就是Scaling Law最初要解决的问题:
固定预算下,钱该怎么花?是造一个巨大的模型让它少读点书,还是造一个适中的模型让它多读点书?
这个问题,行业用了六年,给出了四代不同的答案。
· · ·
二、第一代答案:把脑子做大(2020年)
2020年,OpenAI的Kaplan等人发表了第一篇系统的Scaling Law研究。他们的结论是:当你有更多算力时,应该优先把模型做大,数据不用跟那么快。
整个行业照着做了。那个时代的代表作:
注意一个有意思的现象:这些模型参数量差了好几倍,但训练数据量几乎一样,都在3000亿token左右。
这就是Kaplan时代的信条:脑子越大越好,书读多少无所谓。
· · ·
三、第二代答案:脑子和读书量要匹配(2022年)
2022年,DeepMind做了一件非常扎实的事情:训练了400多个不同大小的模型,系统地测试各种参数量和数据量的组合。
结论是:之前的分配方式偏了。参数和数据应该以大致相同的比例增长。
最有名的对比实验:
| 更强 |
花同样的钱,参数少了4倍的Chinchilla反而明显更强。因为Gopher的"脑子太大、书读太少",大部分脑容量是浪费的。
由此得出了一个在业界流传很广的经验法则:每个参数大约配20个token的训练数据。
这就是所谓的"Chinchilla Scaling Law"。
但这里有一个重要的澄清
"20 tokens per parameter"不是一个物理常数,而是从一条经验曲线上近似读出来的值。后来Epoch AI的复现研究发现,Chinchilla原论文的参数拟合其实存在一些问题。其他研究在不同的数据条件下得到的最优值大约在10到25之间。
所以20是一个有历史意义的路标,但不是一个该死守的数字。更重要的是它代表的那次认知升级:
GPT-3时代:我有钱 → 做更大的脑子。
Chinchilla时代:我有钱 → 脑子大小和读书量一起增加。
唐杰在推特中说,那一代很多超大模型其实是under-trained(训练不足)。那一轮万亿参数竞赛,回头看是整个行业一起走的弯路。
· · ·
四、但Chinchilla回答的问题本身就不够好
到这里,故事还没有真正变得有意思。Chinchilla只是修正了一个分配比例。真正的认知升级发生在下一步。
Chinchilla优化的是什么?
"给我一笔训练预算,我怎样训练出loss最低的模型?"
问题在于:模型训完之后,要被调用多少次?
答案是:每天被调用几十亿次。
模型只训练一次,但要回答10亿次、100亿次、1000亿次的问题。训练成本是一次性的,推理成本是持续累积的。对于一个部署一年的模型来说,推理的总成本可能是训练成本的几十倍甚至上百倍。
这带来了一个完全不同的优化逻辑。
假设你有两个方案:
方案A:训练一个700亿参数的模型,达到Chinchilla最优
方案B:训练一个70亿参数的模型,给它灌远超"最优比例"的数据,让效果接近方案A
方案B的训练成本可能更低(因为模型小,即使多读数据,总计算量也更少),而且推理时每次调用的成本只有方案A的十分之一。如果模型要服务几十亿次调用,方案B的总花费远远更低。
这就是为什么你会看到这样的数字:
Llama和Gemma的tokens/参数比例远远超过Chinchilla建议的20。它们不是不知道"最优比例",而是它们优化的目标不同。
那"20:1"到底错没错?
在它回答的那个特定问题上(固定训练算力,怎么让训练loss最低),20:1大致是对的。但它回答的问题本身已经不是最重要的问题了。
实际上存在两条不同的最优曲线:
训练最优曲线(Chinchilla optimal):每一分训练算力的效果最大化。TPP约20。
全生命周期最优曲线(Inference-aware optimal):训练成本 + 所有推理成本的总和最小化。TPP可以高达数百甚至上千。
你的推理调用量越大,第二条曲线就离第一条越远,最优模型就越小。
所以所谓的"超过训练最优反而更好",不是在同一个评价标准下超过了最优点,而是评价标准本身变了,最优点随之移动了。
Meta在Llama 3论文里甚至明确说:他们的405B模型接近训练最优,而较小的8B/70B模型则故意训练得远超训练最优,因为这样可以在固定推理预算下得到更好的模型。
这是第二次认知升级:从优化训练效率,到优化全生命周期效率。
· · ·
五、MoE:让"多少参数"这个问题彻底变复杂
到目前为止,我们讨论的都是Dense模型,也就是模型里的所有参数每次都参与计算。但现在最前沿的模型很多采用了MoE(Mixture of Experts,混合专家)架构。
想象一个公司有600个专家,但每接到一个客户咨询,只派其中40个人去处理。
总参数(600个专家的总知识量):决定这个公司"什么领域都懂"
激活参数(每次实际派出的40个):决定每次处理一个问题时投入多少脑力
所以当你看到新闻说"某某模型有6000亿参数",你至少要追问:每次推理实际激活多少?
这就引出了一个非常有意思的研究发现。
记忆和推理遵循不同的规律
2025年的研究发现,不同能力对参数和数据的需求是不一样的:
记忆类能力(比如"法国首都是哪")更受益于总参数多。因为要记住的知识越多,需要的"存储空间"越大。
推理类能力(比如"这段代码有什么漏洞")更受益于激活参数多和训练数据多。因为推理需要的是深度计算,不是广度存储。
哈佛的一篇题为"Mixture of Parrots"的研究甚至发现:在MoE中,保持激活参数不变,只增加总专家数(增加总参数),记忆能力会持续提升,但推理能力到一定程度就饱和了。
为什么推理能力看的是激活参数?
这涉及一个更根本的原因。
推理需要在一次前向传播中完成足够复杂的计算链条。比如判断"A导致B,B导致C,C导致D,所以A导致D",模型需要在一次计算中把这条四步链完整地传递下去。这要求参与这次计算的神经元之间有足够的连接和宽度,能够承载信息的逐步变换。
这个能力的天花板由"这一次实际参与计算的参数量"决定,不由"仓库里总共有多少参数"决定。
哈佛的研究从数学上证明了:存在某些推理问题(比如图上的最短路径),无论你加多少个固定宽度的专家都解决不了,但一个宽度稍大一点的Dense模型就能解决。这是架构层面的硬限制,不是训练多少数据的问题。
用比喻来说:100个水平一般的人分在不同房间,每次叫2个出来讨论,不如10个水平很强的人在同一个房间一起讨论。复杂推理需要的是"同时在场的思维密度",不是"总共有多少人可以被叫到"。
但如果你增加每次激活的专家数量(从叫2个变成叫8个),推理能力确实会提升。因为这才是真正在增加"一次计算的宽度"。
唐杰在推特里有一句话说得很到位:发现安全漏洞不是一个检索问题,它不是靠记住更多CVE库来解决的,而是需要把一条二十步的推理链从头走到尾、不丢失线索。这种能力不在总参数量里。
这是第三次认知升级:从"模型有多大"到"模型每次能想多深"。
· · ·
六、现代大模型的训练不是一步完成的
到这里,我们已经把"参数"和"数据"这两个维度拆清楚了。但故事才讲了一半。因为现代大模型的训练远远不止"喂数据"这一步。
如果你把训练一个大模型比作培养一个人,完整的过程大概是这样的:
Pre-training(预训练)= 通识教育
让模型读遍互联网,形成对世界的基本理解。就像从小学读到大学,什么都学一点。训练目标很简单:给前面的文字,预测下一个字。
但这里有一个重要的新认识:数据的"量"只是一个维度。 用什么数据、按什么比例混合、以什么顺序喂、重复几次,这些都极大地影响效果。研究表明,数据过滤和数据设计本身就能产生巨大差异。
而且这些数据工程本身就消耗大量算力:跑分类器筛选、跑去重算法、用模型生成合成数据、跑配比实验找最优混合比例。高质量数据不是免费的,它本身就是一个算力密集型的工程。
Mid-training(中间训练)= 研究生阶段
这是最近两年出现的新概念。通识教育结束后,集中精力学习数学、代码、推理这些难的科目。
比如OLMo 2把约90%的算力用在通识预训练上,然后花5%到10%做中间训练,重点强化高质量网页、精选非网页数据和数学合成数据。Qwen3也采用多阶段训练,到2026年的Qwen3-Coder-Next,中间训练已经直接用于代码推理、代码仓库理解和Agent交互。
你可以把它理解成:预训练是读遍图书馆,中间训练是开始重点攻数学、代码和科研。
Post-training(后训练)= 实习和考核
这里面又分好几层:
SFT(监督微调):给模型看高质量的问答示范。就像实习第一天,师傅做一遍,你跟着学。
DPO / RLHF(偏好学习):给模型看两个回答,告诉它哪个更好。不再只是模仿,而是开始学习判断。
RLVR(可验证奖励的强化学习):这是近年来最重要的突破之一。让模型去做有明确对错反馈的任务。比如数学题,程序自动批改;写代码,跑测试看能不能通过;执行复杂任务,检查最终结果是否成功。
RLVR的关键突破是:不再需要人类写标准答案了。 只需要一个环境能告诉模型"成功还是失败",模型就能生成大量的尝试轨迹,自己练习。
DeepSeek-R1是这个方向非常有影响力的案例。它的R1-Zero版本直接通过大规模RL训练,出现了明显的推理行为,整个过程几乎没有人工编写的推理示范。
Test-time Compute(推理时计算)= 考试时给多少思考时间
以前模型看到问题直接输出答案,一次前向传播就结束。现在可以让模型"想一会儿":尝试、检查、回退、再想、搜索、验证,然后才给出最终答案。
研究表明,在特定推理任务上,小模型通过增加推理时的思考时间,可以超过参数量大很多的模型。也就是说:给一个聪明人10分钟思考,可能比给一个知识面更广的人10秒钟更好。
这意味着推理阶段的计算量本身也成了一个可以缩放的维度。Qwen3甚至提供了"thinking budget"的概念,让用户自己决定模型投入多少推理计算。
每一层解决的问题完全不同,每一层都可以独立加大投入。这就是为什么唐杰说"有多个旋钮可以拧"。
· · ·
七、异步Agent RL:让模型从经验中学习
在后训练的所有技术中,有一个方向特别值得展开讲,因为它代表了一个更深层的趋势。
什么是Agent RL?
普通的RL训练模型可能就是:给模型一道数学题,模型写答案,程序判断对不对,给奖励或惩罚。一个回合很短。
Agent RL不一样。它让模型像一个"智能体"一样在复杂环境中执行很长的任务链:
收到任务"修复这个代码仓库里的bug" → 阅读代码 → 定位问题 → 修改文件 → 编译 → 编译失败 → 阅读错误信息 → 再修改 → 再编译 → 跑测试 → 发现另一个问题 → 继续修 → 最终测试通过
这一整条链路可能有几十步甚至上百步,叫做一条"轨迹"(trajectory)。模型在这个过程中学到的不是"标准答案",而是如何在真实环境中规划、执行、犯错、恢复。
为什么需要"异步"?
Agent RL有一个巨大的效率问题。生成一条轨迹很慢(模型要在环境里一步步执行,等编译结果,等测试反馈),通常占了整个训练步骤50%到80%的时间。更麻烦的是,不同任务的轨迹长度差异很大:有的5分钟完成,有的要2小时。如果要等所有轨迹都跑完才统一更新模型(同步方式),做完快任务的GPU就在干等慢任务。
异步的做法是:把"生成经验"和"更新模型"拆开,让它们同时运行。 系统被分成生成器和训练器两个组件,中间用一个队列连接。做完任务的Agent立刻把经验提交上来,训练端不断从队列里取经验来更新模型。
这也是GLM-5论文特别强调的技术基础设施。没有高效的异步Agent RL系统,就无法支撑大规模、长周期的环境交互训练。
这背后有一个更大的趋势
以前模型从什么东西中学习?文本。 一篇网页教你怎么修一个bug,模型读这篇网页。
现在模型从什么东西中学习?经验。 模型自己去修bug,失败了再改,反复几十步,最终成功。这一整条经历才是它的学习材料。
这个变化意义深远。文本是有限的,互联网上高质量的文本终究会被读完。但经验是可以不断生成的,只要你有足够的环境和足够的算力。
未来模型之间真正巨大的差别,可能越来越不是"谁的参数多",而是"谁的模型经历过更多高质量的、可验证的、长周期的真实任务"。
· · ·
八、GLM-5.3到底想证明什么?
理解了上面所有背景之后,我们终于可以回到唐杰那条推特的落脚点。
GLM-5.3是一个非常干净的对照实验:
和GLM-5.2相比,架构不变、总参数不变、激活参数不变、预训练不变
唯一的区别:花了一个月在长周期环境中做Agent RL,加大了后训练投入
结果:性能大幅提升
有人可能会问:"多训练了当然会变好,这有什么稀奇的?"
问题不在于"变好了",而在于"同样的额外投入,花在哪里回报最高"。
假设智谱又拿到了一个月的额外算力,他们可以选择:
重新预训练一个更大的基座模型增加预训练数据量在现有基座上加强后训练(Agent RL)
三个选项都会"变好"。但GLM-5.3的实验结果是:在当前阶段,选项三的投入产出比最高。
这就是唐杰说的:"有多个旋钮可以拧,而上一次值得拧的旋钮,不一定是这一次值得拧的。"
他还补了一句:基座模型大小、预训练数据、每次前向传播的计算量,这些旋钮都还在桌上,将来都会回来继续拧。只是这一次,后训练的剩余空间最大,所以先拧它。
这其实是一种非常务实的工程思维:不追求一次性把所有方向都做到极致,而是每一步找到边际回报最高的方向。
· · ·
九、从"缩放参数"到"缩放经验":大模型的五次认知升级
回顾从2020年到今天的整条线索,可以看到五次清晰的认知升级:
第一阶段:Scaling Parameters(缩放参数)
信条:更大的模型更强。
代表:GPT-3、Gopher。
局限:参数堆太多,数据喂太少,大部分容量浪费。
第二阶段:Scaling Data × Parameters(缩放数据与参数的匹配)
信条:模型大小和训练数据量必须同步增长。
代表:Chinchilla(20 tokens/parameter)。
局限:只优化了训练效率,没有考虑推理成本。
第三阶段:Scaling Training Pipeline(缩放整条训练流水线)
信条:预训练只是起点。数据质量、中间训练、SFT、RL都是可以持续扩大投入的计算过程。
代表:Llama 3、Qwen3、OLMo 2。以及RLVR带来的突破:模型可以从环境反馈中自主学习。
第四阶段:Scaling Compute over Time(缩放推理时计算)
信条:不只是训练时花计算。模型回答一道难题时,也可以动态投入更多计算、搜索、工具调用和验证。
代表:DeepSeek-R1、Qwen3的thinking budget。
第五阶段:Scaling Experience(缩放经验)(正在发生)
信条:数据有限,经验无限。模型通过在真实环境中长周期交互,积累规划、执行、恢复和验证的能力。
代表:GLM-5的异步Agent RL、以及越来越多将Agent轨迹纳入训练的前沿模型。
如果用一个公式概括今天的理解:
能力 = f(总参数, 激活参数, 数据量, 数据质量, 架构, 预训练算力, 中间训练算力, 后训练算力, 推理时算力, 环境交互量, 目标任务)
这比六年前的"能力 ≈ f(参数量)"要复杂得多,但也真实得多。
· · ·
十、以后看到新模型发布,你该问什么?
下次看到一个新模型发布,先别急着看"多少参数"。试试这套问题:
架构层面:总参数和激活参数分别多少?Dense还是MoE?如果是MoE,每次激活多少专家?
数据层面:预训练用了多少token?数据构成是什么?网页、书籍、代码、论文各占多少?有没有合成数据?tokens/parameter是多少?
训练流程:有没有中间训练阶段?重点强化了什么能力?后训练做了什么?SFT、DPO、RLHF、RLVR分别用了什么数据和环境?
RL的深度:强化学习的环境是什么?是数学题的自动批改?还是代码的编译测试?还是真实软件仓库的长周期交互?
推理时能力:模型运行时允许"想"多久?有没有搜索、验证、工具调用、自我纠错?
经济目标:这个模型优化的是最高能力、最低推理成本、还是全生命周期效率?
能问出这些问题,你就已经不是在看热闹了。你看到"744B参数"也不会再特别兴奋。你会接着问:744B是总参数还是激活参数?训了多少token?什么数据配比?RL了多少条轨迹?每道题允许多少推理计算?
这是用研究者的方式在看模型。
而这一切,都从一个最朴素的问题开始:
同样的钱,到底该怎么花?
只不过,"花在哪里"的选项,比六年前多了太多。
· · ·
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。