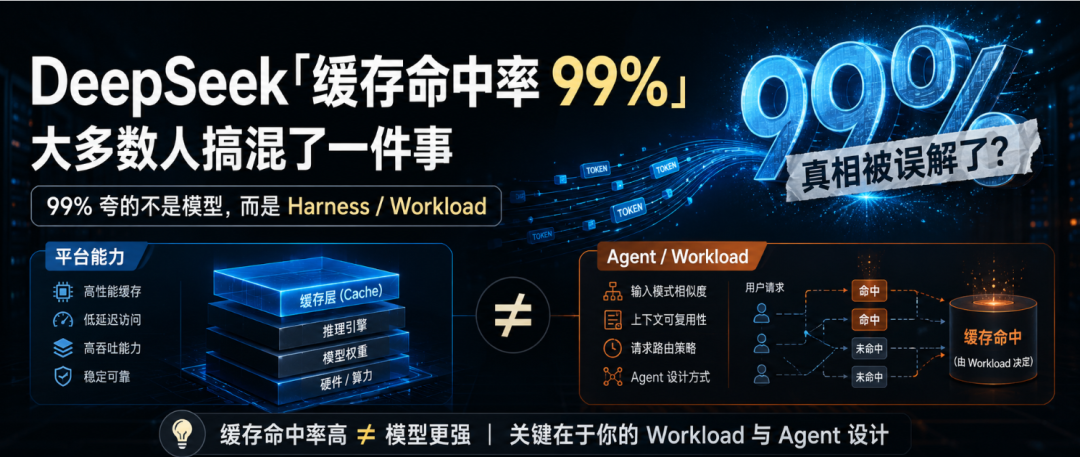
关于 DeepSeek"缓存命中率 99%",大部分人搞混了一件事
8 月 13 日凌晨,DeepSeek V4-Pro 正式版悄然上线,版本号 V4-Pro-0813,重点强化了 Agent 能力和工具调用,支持百万 token 上下文,在多个 Agent 基准上接近 Claude Fable 5。
第二天,我就听到身边有人聊起 DeepSeek 的缓存:"缓存命中率高达 99%,比 Claude 便宜太多了。"
我当时第一反应是觉得哪里不对。缓存命中率这个数字,不是取决于你怎么发请求吗?你的前缀稳不稳定、新内容占比多少,这些是用户端的事情,跟底层是 DeepSeek 还是 Claude 有什么关系?
带着这个疑问,我花了点时间把这件事从头到尾搞清楚了。结论比我预想的更有意思:不是"99% 这个数字有问题",而是"这个数字的功劳被记到了错误的人头上"。
一、缓存命中率到底在度量什么
先快速回顾一下前缀缓存的机制。你每次发请求给大模型 API,输入内容里有大量重复(system prompt、工具定义、历史对话)。如果这次请求的前缀跟上次逐字节完全一致,服务端就跳过重复的 KV 计算,直接复用上次的结果。所谓缓存命中率,就是所有输入 token 中,有多少比例走了缓存复用。
(关于 KV Cache 的原理、前缀匹配规则、请求结构设计,我在《大模型缓存机制完全指南》里有完整的解释,这里不重复。)
理解了这个定义,做一道简单的算术题就够了。
假设你在用编程 Agent,每次请求的结构是:固定前缀 100000 token + 你新写的内容 200 token。缓存命中率 = 100000 / 100200 ≈ 99.8%。
换个场景,你在做 RAG,每轮塞进不同的检索片段:固定的 system prompt 5000 token + 每次不同的输入 15000 token。缓存命中率 = 5000 / 20200 ≈ 25%。
同一个 DeepSeek,同一套缓存基础设施。一个 99%,一个 25%。区别不在模型,完全在于请求怎么构造。
到这一步,我最初的直觉基本被验证了。但我还想知道:那个"99%"到底是从哪来的?
二、去找了一下 99% 的源头
搜了一圈发现,流传最广的数字是 99.82%。出处是一个叫 Reasonix 的编程 Agent 框架,它公布了一组真实用户数据:单日 4.35 亿输入 token,缓存命中 99.82%,花费 $1.38,不走缓存的话需要 $61。
但关键是 Reasonix 自己把原因说得很清楚:这个数字是它专门为最大化缓存命中设计客户端架构的结果。
它做了三件事:把 system prompt 和工具定义锁死,启动后一个字节不变;对话历史只追加、不重排、不修改已有内容;思维链等临时数据不塞回下次请求的前缀,放在缓存区之外。
也就是说,Reasonix 深刻理解前缀匹配的规则(这些规则我在《缓存机制完全指南》第四章讲过:从第一个 token 逐个比对,遇到第一个不同就停,后面全部重算),然后针对性地把客户端的请求结构改造成了"最不容易破坏前缀"的形态。
所以 99.82% 的真正主语是"Reasonix + 特定用户 + 编程工作负载 + DeepSeek API"这个组合,不是"DeepSeek"。
更有意思的是,我去查了 DeepSeek 官方文档,发现官方从来没有说过"缓存命中率 99%"。官方的原话是:根据历史数据,用户平均可节省超过 50%;针对缓存特性优化后,成本最多可节省 90%。并且明确标注了一句:缓存系统不保证 100% 命中。
事情到这里就很清楚了。在传播过程中,"Reasonix 在 DeepSeek 上跑出了 99%"逐渐变成了"DeepSeek 缓存命中率 99%"。功劳被记到了错误的人头上。
三、缓存在那里,就一定 100% 命中吗
搞清楚了"99% 不是 DeepSeek 的成绩"之后,我顺着又想了一个问题:假设 Reasonix 把前缀保持得完美稳定,那在缓存没过期的情况下,前缀完全一致的部分命中率到底是多少?是 99%?95%?还是 100%?
答案是 100%。
前缀缓存的匹配是确定性的,不是概率性的。缓存条目还在、前缀逐字节一致,就一定命中。不存在"缓存明明在、前缀也对、但随机只给你命中 90%"的情况。这一点 Claude 是这样,DeepSeek 也是这样,所有基于前缀匹配的缓存系统都是这样。
那为什么实际中会出现"不到 100%"的情况?只有两种可能:要么你的前缀变了(哪怕差一个字节),要么缓存已经不在了(过期、被淘汰、请求被路由到另一台没有你缓存的服务器)。
这引出了一个重要的推论:平台能力的差异,体现在缓存能活多久、能存多少,而不是在有效期内"偷工减料"。 如果一家厂商的硬件能力不够,它会缩短缓存的保留时间,或者让缓存更容易被别人的挤掉。但它不会在缓存还活着的时候故意不给你命中。
理解了这一点,就可以问出真正有意义的问题了:既然缓存命中率不是 DeepSeek 的功劳,那 DeepSeek 的缓存到底强在哪?
四、DeepSeek 缓存真正强的地方
DeepSeek 在缓存上确实有值得说的东西,只不过跟"99%"是完全不同的维度。
第一,缓存存活时间长。 大多数厂商把 KV Cache 存在 GPU 显存里,容量小、过期快。Claude 的默认缓存 TTL 是 5 分钟(Max 订阅可延长到 1 小时)。DeepSeek 用硬盘缓存,有开发者做了严格测试:32K、64K、128K 三种前缀长度,分别在 8 小时、12 小时、16 小时、24 小时间隔下测试,全部 12 条测试线在整个周期内出现 0 次真实 cache miss。也就是说实测缓存可以存活超过 24 小时。
这个差距是数量级的:Claude 默认 5 分钟(你去喝杯咖啡回来缓存可能就没了),DeepSeek 超过 24 小时。
第二,缓存写入免费。 Claude 的缓存写入要额外加价:5 分钟 TTL 加价 25%,1 小时 TTL 加价 100%。DeepSeek 的缓存写入没有任何溢价。(关于 cache write 和 cache read 的计费区别,我在《一文讲透大模型对话的缓存计费机制》里有详细讲解。)
第三,缓存容量大。 DeepSeek 利用 MLA 架构将 KV Cache 体积压缩到前代的 10%,再加上硬盘存储天然比 GPU 显存便宜得多,能缓存的总量远超纯显存方案。这意味着你的缓存更不容易因为别人的请求太多而被挤掉。
这三条才是可以归属于 DeepSeek 平台能力的指标。它们回答的问题是:"对于用户已经构造好的可重复前缀,DeepSeek 能多久、多可靠、多便宜地保住它?"
而"99%"回答的是一个完全不同的问题:"用户构造的请求中有多少比例的 token 恰好是可重复的?"前者是平台能力,后者是工作负载特征。
五、如果真要比较各家缓存能力,应该怎么比
理解了上面的区分之后,很容易看出为什么下面这种比较没有价值:
这三个数字可能来自完全不同的用户、不同的使用场景、不同的请求构造方式。拿来横向对比,逻辑上不成立。
正确的做法是:固定完全相同的请求序列(相同的 token、相同的时间间隔、相同的并发量),然后比较各家在这组请求上的实际表现,包括缓存存活时间、缓存容量上限、写入成本、读取折扣、首 token 延迟改善等。
这其实可以拆成一个公式来理解。实际命中率大致等于两个因素相乘:用户端的可重复前缀比例 × 平台端的缓存兑现能力。 第一项取决于你怎么构造请求,第二项取决于平台的基础设施。只有第二项是平台之间可以横向比较的。
还有一点值得提:缓存命中率高不等于 Agent 设计得好。一个优秀的 RAG Agent 每轮动态选择最相关的文档片段,命中率可能只有 25%,但它在做更智能的上下文选择。反过来,一个笨 Agent 每轮把 50 万 token 的完整历史原封不动重发,命中率 99.9%,但它可能在浪费大量的缓存读取费用(走缓存也是要收费的),同时让模型淹没在无关信息中,降低回答质量。
缓存命中率只描述一件事:你送进去的 token 中,有多少恰好已经以相同前缀出现过并且仍可取回。不多,也不少。
结尾
写完这篇,回头看最开始的问题:"DeepSeek 缓存命中率 99%,很厉害。"
现在可以准确地说:99% 是 Reasonix 这个 Agent 框架在 DeepSeek 上跑出来的工作负载统计,不是 DeepSeek 的固有性能参数。DeepSeek 官方从来没有这么宣传过。
DeepSeek 缓存真正厉害的地方是:存活超过 24 小时(Claude 默认 5/60 分钟)、写入便宜(Claude 加价 25% 起)、容量大不容易被挤掉。这些才是平台能力,跟"99%"是完全不同的东西。
下次再听到有人拿缓存命中率比较不同模型,可以直接问一句:这个数字的主语是谁?是平台,还是跑在上面的那个 Agent?
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。