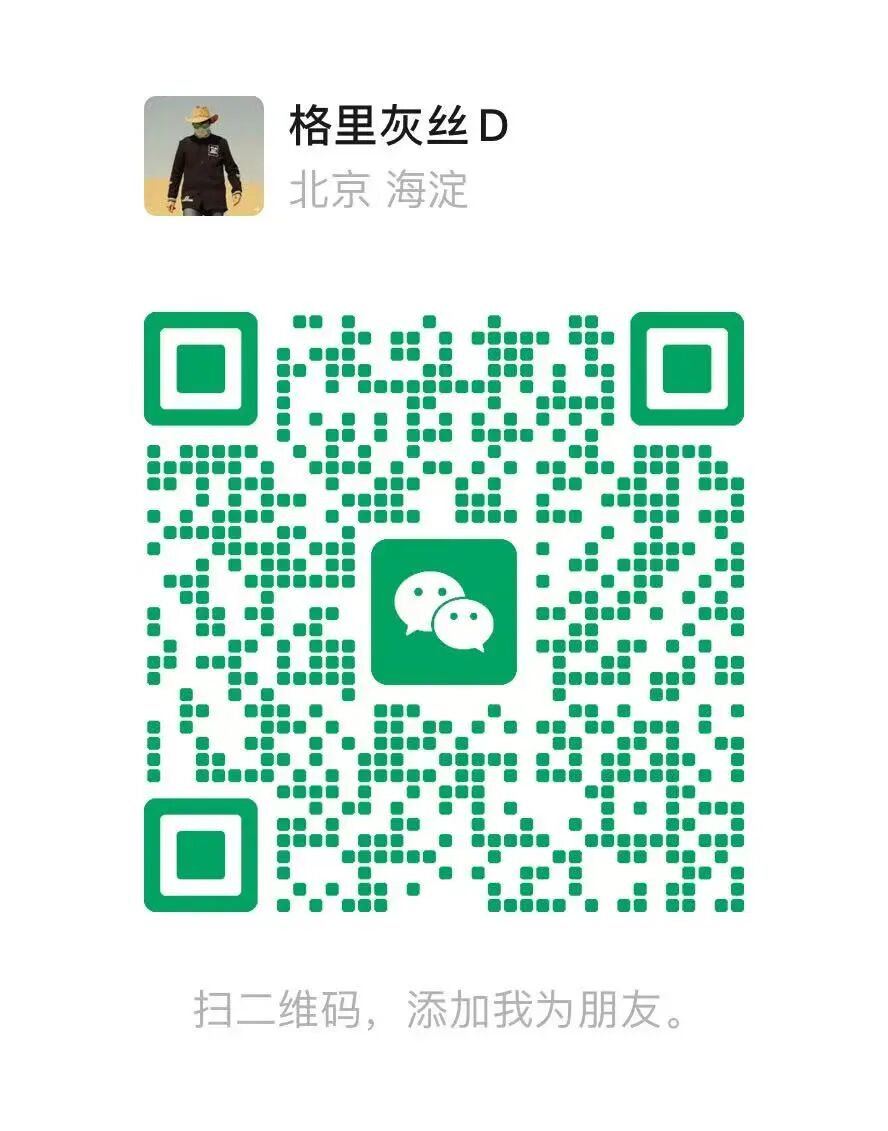
从对话到 Agent:缓存命中率的统一解释
《关于 DeepSeek"缓存命中率 99%",大部分人搞混了一件事》发出后,在"真搞AI"群里引起了一些讨论。
有一位做重度 Agent 任务的群友提出了不同看法。他说:同一个 harness,V3 缓存命中率只有 50%,V4 能到 96%。如果命中率真的跟模型无关,为什么换个模型就变了?
他还展示了一组让我意外的数据:一句提示词,中间没有任何人工交互,模型自己跑了 800 分钟、调用了 1900 次 API、消耗 1.5 亿 token,缓存命中 96%。
1.5 亿 token?上下文窗口才 100 万。而且"没有人工交互"的情况下,缓存命中率怎么理解?
这跟《关于 DeepSeek"缓存命中率 99%"》讨论的场景明显不同。往下挖了一下,发现那篇文章确实只覆盖了一半的情况。但最终我找到了一个统一的视角,可以把两种场景用同一套逻辑解释清楚。
一、先找到统一的视角
《关于 DeepSeek"缓存命中率 99%"》的核心结论是:缓存命中率取决于输入者怎么构造请求,而不是缓存系统本身。
群友的场景看起来跟这个结论矛盾:用户只输入了一句话,后面 1900 次 API 调用全是模型自己在跑,用户什么都没做,怎么能说"取决于输入者"?
但仔细想一下,其实不矛盾。关键在于:在 Agent 自主循环中,"输入者"的角色从人变成了模型。
对话模式下,人类是输入者。你打一句话,模型回一句,你再打一句。每次请求里的新增部分是你写的。你改不改 system prompt、你一次输入多少新内容,这些决定了缓存命中率。
Agent 自主循环中,模型是输入者。模型输出 tool_call,工具返回结果,harness 把这些拼成下一轮的输入,模型再输出。每次请求里的新增部分是模型的上轮输出和工具返回的结果。模型每轮新增多少内容、会不会触发上下文压缩,这些决定了缓存命中率。
所以那篇文章的结论不需要修改,只需要把"输入者"这个概念扩展一下:不管是人还是 AI 在制造输入,缓存命中率都取决于输入模式,而不是缓存系统本身。 这就是两种场景的统一解释。
理解了这个之后,下面的问题就是:Agent 自主循环到底在发生什么,以及为什么不同模型跑出来的命中率会不一样。
二、Agent 自主循环到底在发生什么
我在《一文讲透大模型对话的缓存计费机制》里讲过:大模型 API 是无状态的,模型没有"暂停推理、等工具执行完、继续推理"的能力。每次工具调用结束后,客户端必须把工具返回的结果追加到对话历史末尾,向模型发起一次全新的 API 请求。
在对话模式下,这个过程很直观:你说一句话,模型可能调一两次工具,然后回复你。一个来回大概 2 到 5 次 API 调用。
但在 Agent 自主循环中,整个过程会变成这样:
调用 1: 发送 system prompt(2 万 token)+ 工具定义(8000 token)+ 用户任务(500 token)。模型决定先读一下接口文档,输出一个 tool_call。
调用 2: 发送上一轮全部内容(28500 token)+ 模型上轮的 tool_call(100 token)+ 工具返回的文档内容(5000 token)。模型看了文档,决定写一段代码,输出代码和另一个 tool_call 去执行。
调用 3: 发送上面所有内容(33600 token)+ 模型的代码输出(2000 token)+ 执行结果(500 token)。模型看到报错,决定改代码。
调用 4: 发送全部历史(36100 token)+ 新的修改和执行……
到了调用 50,单次请求可能已经有 8 万 token 的输入。到了调用 200,上下文快满了,harness 做一次压缩(compact),把历史摘要成几千 token,然后继续。如此循环:增长、压缩、再增长、再压缩。
全程没有任何用户输入。模型自己在不断制造新的 API 请求。
所以那"1900 次 API 调用"就是这么来的。而且除了主线程的调用,模型还可能启动子代理(比如一个负责搜索代码、一个负责做规划),每个子代理又是一条独立的调用链,有自己的上下文。子代理几乎无法复用主线程的缓存(工具集不同、消息历史独立),基本等于迷你冷启动。这些全部累加到总 token 消耗中。
三、1.5 亿 token 到底是什么
搞清楚了 Agent 循环的过程,就可以回答"1.5 亿 token 怎么可能"这个问题了。
这里其实是统计口径的问题。上下文窗口是单次请求的上限。而"消耗 1.5 亿"是 1900 次请求中所有输入输出 token 的累加总和。每次请求平均 8 万 token,没有任何一次超过窗口限制,但 1900 次加在一起就是 1.5 亿。
关键在于:这 1.5 亿里绝大部分是同一批内容被重复发送。每次新请求都要把之前的完整历史重发一遍(因为 API 是无状态的),所以同一段 system prompt 可能被发送了 1900 次,同一段早期的对话历史可能被发送了上千次。
群友的 DeepSeek 后台截图印证了这一点:8 月 14 日总计 1.64 亿 token,其中缓存命中 1.58 亿(96.5%),未命中输入 413 万,输出 155 万。
换一个口径来看这组数据,会更直观。把重复发送的缓存 token 全部剥掉,只看真正新产生的内容:未命中输入 413 万 + 输出 155 万 ≈ 568 万 token。这才是 1900 次 API 调用中模型真正在思考和产出的部分。剩下的 1.58 亿全是"因为 API 无状态所以必须重发"的结构性开销。
用这个口径反过来看缓存命中率,会发现一个有意思的事实:Agent 循环中命中率天然就会很高,这不是任何人的功劳,而是无状态 API 这个架构的数学必然。 你循环 1900 次,每次重发历史,重发的部分越来越大,新增的部分始终很小。轮次越多,命中率越接近 100%。就像你每天把整本书重抄一遍只在末尾加一句话,"重复率"当然是 99% 以上,这不能说明你的抄写技术有多好。
当然,缓存命中的 token 虽然不是"新内容",但也不是完全免费的(DeepSeek 收 2%,Claude 收 10%)。1.58 亿 × 2% 的费用仍然是真实成本。所以从省钱角度看,命中率高确实有实际意义。只是不应该把它当作模型能力或平台能力的评价指标。
四、为什么同一个 harness、不同模型,命中率会不同
回到群友最初的问题:同一个 harness,V3 命中率 50%,V4 命中率 96%,为什么?
回到第一章的统一视角:在 Agent 自主循环中,模型是输入者。不同模型的"输入风格"不同,产生的请求序列就不同。
一种模型倾向于小步迭代:读一小段文档、写一小段代码、立刻测试、看到报错、微调、再测试。每轮只新增少量内容(一个 tool_call 加一小段输出),前缀高度重复。如果每次请求 8 万 token 里只有 2000 是新增的,命中率自然是 97.5%。
另一种模型倾向于大刀阔斧:一次性读取整个大文件(tool_result 返回 3 万 token),然后输出一个完整的重构方案(输出 1 万 token),再一口气调五个工具。每轮新增内容占比大得多,命中率可能只有 60%。如果它的输出还触发了上下文压缩(compact),压缩会改写历史内容,从变化点开始整个缓存断裂,命中率进一步暴跌。
Harness 完全一样,但两个模型产生了完全不同的请求序列。缓存系统的匹配规则没变(还是从头逐字节比对),变的是被匹配的内容本身。
回到第一章的类比:对话模式下,一个用户每次只追加一句话(命中率高),另一个用户每次都大改 system prompt(命中率低)。我们不会说"这两个用户证明了不同的缓存系统有不同的命中能力"。Agent 自主循环中也一样,两个模型只是扮演了两种不同风格的"输入者"。
五、但命中率高不等于效率高
理解了上面的机制之后,一个很自然的推论是:那我应该选命中率最高的模型?
不一定。
小步迭代的模型命中率高,但可能效率低。同样一个任务,它需要 500 轮调用才能完成,每轮新增很少,命中率 98%。大刀阔斧的模型命中率低,但可能 50 轮就搞定了,每轮新增较多,命中率 60%。
算一笔账。假设 DeepSeek 缓存命中 token 按 2% 收费,未命中按全价:
小步模型:500 轮 × 8 万 token,命中率 98%。缓存读取 500 × 78400 × 0.02 = 78.4 万等价 token。新增计算 500 × 1600 = 80 万 token。总等价消耗约 158 万 token。但跑了 500 轮,耗时可能很长。
大刀模型:50 轮 × 10 万 token,命中率 60%。缓存读取 50 × 60000 × 0.02 = 6 万等价 token。新增计算 50 × 40000 = 200 万 token。总等价消耗约 206 万 token。贵了 30%,但轮次少了 10 倍,完成速度可能快得多。
而且这里还没算任务完成质量。大刀模型如果因为"看得更全"而一次做对,省掉了小步模型反复试错的 300 轮,总成本可能反而更低。
所以缓存命中率只是成本的一个因子,不是唯一因子,甚至不一定是最重要的因子。《关于 DeepSeek"缓存命中率 99%"》说过"缓存命中率高不等于 Agent 设计得好",在 Agent 自主循环的语境下同样成立:缓存命中率高也不等于模型效率高。
六、那"模型因素排第一"这个说法对吗
群友的观察是真实的:V3 命中 50%,V4 命中 96%。但从这个观察直接推出"模型因素排第一",推论太快了。
至少有三种因素混在一起:
第一,模型行为不同。 V4 可能工具调用更规整、输出更稳定、更倾向小步迭代,天然产生更高的可重复前缀比例。这是模型能力影响了工作负载,不是缓存机制本身的差异。
第二,基础设施升级了。 V3 和 V4 不是同一时期的后端。V4 时代有 MLA 压缩(KV Cache 体积降到前代的 10%)和硬盘缓存,缓存容量和存活时间都远超 V3 时代。同样的请求序列放在 V3 时代的后端上,可能因为缓存被挤掉而 miss,放在 V4 时代就能保住。
第三,API 协议也在变。 比如 V4 的 thinking mode 对 reasoning_content 的处理方式跟 V3 不同。这些协议层面的变化会直接改变 harness 组装下一轮请求时的 token 序列,影响前缀是否一致。
三种因素混在一起,没法从最终的命中率数字里分离出"模型"的独立贡献。要真正证明"模型机制决定命中上限",应该把完全相同的请求序列录制下来,分别回放给不同版本的缓存后端。目前群友的对比没有控制这些变量,所以不能直接下这个结论。
七、把公式补完整
《关于 DeepSeek"缓存命中率 99%"》给了一个公式:实际命中率 ≈ 可重复前缀比例 × 平台缓存兑现能力。
这个公式本身没问题,但"可重复前缀比例"这个因子需要进一步拆开。在对话模式下,它主要由用户行为和 harness 设计决定。在 Agent 自主循环中,还要加上模型行为。
完整的图景是四层:
用户行为。 是否改 system prompt、是否切模型、是否开新 session、是否 rollback。在对话模式下这是主要因素,在 Agent 自主循环中影响很小(因为用户几乎不参与)。
模型行为。 工具调用模式、单次输出长度、任务规划方式、是否触发上下文压缩。主要在 Agent 自主循环中起作用。本质上就是"AI 作为输入者"的输入风格。
Harness 设计。 历史怎么拼接、前缀是否保持稳定、思维链是否塞回前缀、压缩策略怎么设计。这是 Reasonix 做到 99.82% 的关键所在。
平台缓存基础设施。 缓存存活时间、容量、匹配规则、读写价格。这是《关于 DeepSeek"缓存命中率 99%"》第四章讲的 DeepSeek 真正强的地方。
命中率是这四层共同产生的运行结果,不是其中任何一层的固有参数。
《关于 DeepSeek"缓存命中率 99%"》侧重讲了第一层和第四层(用户行为和平台能力),这篇补上了第二层和第三层(模型行为和 harness 设计)。四层合在一起,才是完整的理解。
结尾
回到最开始的问题:《关于 DeepSeek"缓存命中率 99%"》的结论需要修改吗?
不需要。那篇文章的核心判断仍然成立:缓存命中率不是模型的固有性能参数。
这一篇做的事情是把视角扩展了一步。对话模式下人类是输入者,Agent 自主循环下模型是输入者,但底层的规则只有一条:缓存命中率取决于输入模式,不取决于缓存系统。 不管谁在输入,这条规则都不变。
如果你要优化缓存命中率,应该根据自己的场景选择优化哪一层。在对话模式下,保持前缀稳定,别频繁切模型。在做 Agent 开发,更重要的是 harness 层的设计,以及理解不同模型的行为风格对请求序列的影响。在评估不同平台的缓存能力,别看命中率数字,看基础设施的硬指标:存活时间、容量、读写价格。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。