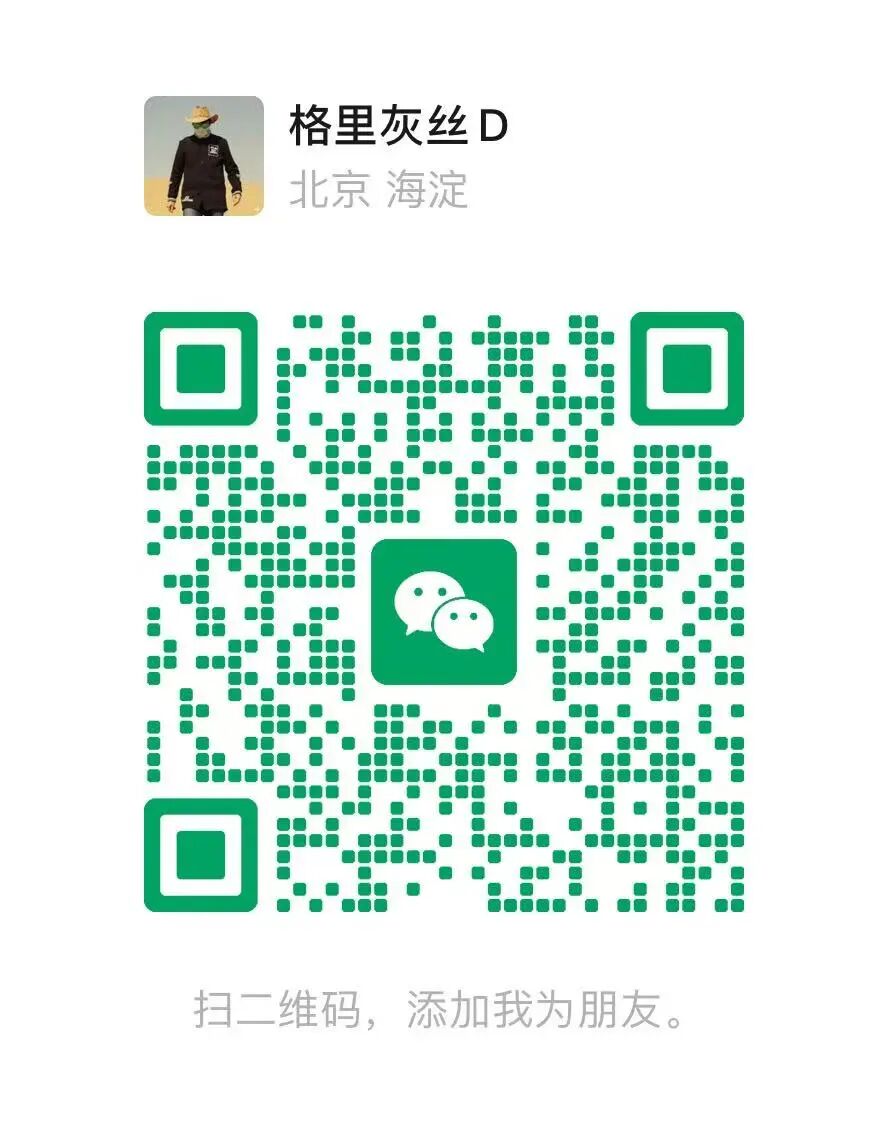
子代理没返回结果,我的Token白浪费了吗?
翻车现场
前几天用 Claude Code 排查代码问题,Claude Code 自己派了 5 个子代理(subagent)出去,从不同角度并行检查我的代码。说实话我是不太希望它这样干的,因为太费 token 了(关于这一点可以看我之前写的《不要随便用子代理(subagent)模式啊》)。但它已经派出去了,我就让它跑着吧。
跑了很久,token 消耗飞快,5 小时限制到了,全部中断。
限制重置后继续工作,3 个子代理的检查结果找回来了,另外 2 个什么都没有。彻底消失了。
几万 token 烧进去,2 个子代理的全部工作归零。这让我非常不解:同样是被中断,为什么有的能找回来、有的就不行?那些检查了一半的分析到底去哪了?
我花了不少时间研究这个问题,把子代理的工作原理、数据保存机制、API 的流式传输逻辑都翻了一遍。下面是我搞清楚的东西。
子代理不是"一口气干完"的
搞清楚这个问题之前,得先纠正一个很普遍的误解:子代理并不是"一口气生成几万 token 的长文本"然后一次性返回。
如果是那样的话,中断了确实就全丢了,没什么好讨论的。
但实际上,子代理的工作方式是一个由多轮 API 调用组成的循环:
第 1 轮 API 调用 → 模型说"我要读一下 auth.ts" → 本地执行读取 → 记录到 transcript第 2 轮 API 调用 → 模型说"这里有个可疑的调用,看看相关的测试文件" → 本地读取 → 记录到 transcript第 3 轮 API 调用 → 模型说"再看看这个模块的依赖关系" → 本地执行搜索 → 记录到 transcript第 4 轮 API 调用 → 模型说"问题找到了" → 生成最终分析报告 → 返回给主 agent
每一轮都是一次独立的 API 请求,每一轮都消耗 token。你看到的"消耗了大量 token",其实是几十轮甚至上百轮 API 调用累积起来的结果。
这个工作模式意味着什么?意味着子代理的工作过程中,有两类完全不同性质的产出:
已经落盘的产出:每一轮的工具操作(读文件、改文件、执行命令)是实时执行的。如果子代理在第 30 轮调用时被中断,前 29 轮执行过的文件修改、命令结果都已经真实发生了,不会因为中断而回滚。
只存在于上下文中的产出:模型在这几十轮里"读了什么、想了什么、得出了什么中间结论",这些只存在于 API 调用的上下文窗口里。子代理被终止的那一刻,这个上下文就没了。
这个区别非常关键,直接决定了你的成果到底能不能找回来。
为什么 3 个有结果、2 个没有
这是最让我困惑的部分。后来在 Anthropic 的官方文档里找到了明确的说明,它区分了两种情况:
第一种:子代理在被中断时已经生成了文本输出。也就是说它至少已经开始写最终的分析报告了,哪怕只写了一半。这种情况下,Claude Code 会拿到那个部分输出,标注为"不完整",返回给主 agent。虽然不完整,但至少有东西。
第二种:子代理在被中断时还处于工具调用阶段——还在读文件、搜索代码、分析依赖——尚未生成任何文本。这种情况下,直接终止,什么内容都不返回。
所以不是随机的,而是取决于中断那一刻子代理恰好走到了哪一步:
子代理 A ✅ → 中断时已经在写分析报告了 → 部分结果被保留子代理 B ✅ → 中断时已经在写分析报告了 → 部分结果被保留子代理 C ✅ → 中断时已经在写分析报告了 → 部分结果被保留子代理 D ❌ → 中断时还在读代码文件 → 直接终止,啥也没有子代理 E ❌ → 中断时还在分析依赖关系 → 直接终止,啥也没有
这个问题在 GitHub 上被大量用户报告过。有开发者跑 3 个并行 agent,全部被 529 Overloaded 错误静默杀死,agent 报告"已完成"但结果只是一个错误字符串,所有工作上下文丢失。
API 层面到底发生了什么
要真正理解这个问题,得再往下挖一层:API 到底是怎么工作的。
Anthropic 的 Messages API 是无状态的。"无状态"这三个字在这里有非常具体的含义:每次 API 调用都是独立的一问一答,服务端不会帮你保存任何东西。你发消息过去,模型生成回复,通过流式传输(streaming)一个 token 一个 token 地推送给客户端,推完就结束了。
流式传输的关键特点是:token 生成一个就发一个,服务端不会把"模型说了什么"存下来等你来取。就像打电话,声音发出去了就发出去了,对方没听到就没了。
那 Claude Code 的子代理在这个机制上是怎么工作的呢?
子代理的每一轮"思考"都是一次独立的 API 调用。Claude Code 本地的 agent 循环代码负责:把上一轮的对话历史和工具执行结果拼成一个完整的 messages 数组,发给 API,拿到回复,执行回复中的工具调用,再拼到历史里,发起下一轮。
所以子代理的"记忆"不在服务端,而在本地的 agent 循环代码维护的那个 messages 数组里。子代理被终止时,这个数组就被丢弃了。前面几十轮积累的"我读过什么文件、发现了什么问题、有什么初步判断",全部随着这个数组消失。
这就是为什么那两个子代理"什么都没返回"。它们不是"做完了没保存",而是还在循环的中间轮次,模型正在通过工具调用收集信息、尚未进入"生成最终报告"的阶段。一旦被掐,它们的全部思考过程就蒸发了。
服务端真的什么都没留吗
这是我研究过程中追问得最深的一个问题。答案比想象的微妙。
Anthropic 服务端确实保留了数据。根据官方数据保留政策,API 的输入和输出在服务端保留最多 30 天后自动删除。被标记为违规的内容可能保留最长 2 年。
但这些数据你拿不到。这 30 天的保留是为了合规和安全审计,不是给用户用的缓存。你没有任何 API 或接口可以说"把我昨天那个断掉的子代理的第 15 轮 API 调用的完整回复给我"。这些数据躺在 Anthropic 的后端日志里,对你来说等于不存在。
所以准确的说法是:服务端保存了,但对你不可用。你能恢复的东西,全部要靠本地。
本地到底保存了什么
Claude Code 在本地维护了两层记录:
Session transcript:路径是 ~/.claude/projects/<项目名>/。每一轮对话(包括子代理的每一步操作)都会追加写入这个文件。格式是 JSONL,不太友好,但信息都在。
子代理 output 文件:当子代理的输出超过内联大小限制时,Claude Code 会把结果保存到 /private/tmp/claude-。注意这个路径在 /tmp 下,macOS 重启后会被清空。
另外,所有已执行的工具操作(文件修改、命令执行)都是实时落盘的。如果子代理改了文件,那个文件就是改了,不管子代理后来怎么样。用 git diff 就能看到。
我那 3 个能找回结果的子代理,实际上是限制重置后模型自己去翻 transcript 和 output 文件找回来的。我并没有告诉它"去某某路径找",它自己就知道去哪里翻。这算 Claude Code 比较聪明的一点。
但那 2 个没返回的子代理,因为它们在中断前连文本输出都没生成过,transcript 里只有一堆工具调用记录("读了哪个文件""搜了什么关键词"),模型能从中恢复的有效信息非常有限。
子代理模式的根本矛盾
这次经历让我看到了子代理模式一个更深层的问题,在之前那篇文章里我只是从 token 成本的角度说"能不用就不用",现在我觉得问题不只是成本。
子代理模式有一个根本矛盾:它用并行换速度,但并行本身引入了不确定性。
串行工作时,每一步都有确定的结果。第一个任务做完了,你看到结果了,再开始第二个。如果中间出了问题,你最多损失当前这一步的工作量。
并行工作时,你同时把赌注押在了 N 个任务上。每一个都可能因为限制、超时、网络中断等原因失败。而且并行加速了 token 消耗,反过来提高了撞上限制的概率。你本来想用并行省时间,结果并行本身增加了翻车的风险。
更要命的是,子代理的中间思考过程不持久化。如果一个子代理跑了 50 轮 API 调用,读了 20 个文件,形成了一套完整的分析思路,但在第 51 轮(生成最终报告之前)被中断了,这 50 轮的全部思考过程就消失了。文件是读了,但"读完之后想到了什么"没有任何地方记录。
这不是 Claude Code 的 bug,而是当前 API 无状态架构下的必然结果。每次 API 调用结束后,服务端不保留上下文,子代理的"记忆"由本地的 agent 循环代码维护,子代理一旦终止,这份记忆就没了。
最后
我在《不要随便用子代理(subagent)模式啊》里的结论是:子代理模式能不用就不用。这次经历让我更加确信这一点。
上次是从经济账的角度算出来的,同样的任务,子代理的 token 消耗是直接做的 6 到 8 倍。
这次是从风险的角度体会到的,不光贵,而且可能白花。5 个子代理并行跑,2 个什么都没返回,60000 token 直接归零。这不是理论上的风险,是我实际遇到的情况。
贵,而且可能白花。这就是子代理模式的现实。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。
#AI #大模型 #大模型应用 #claude #chatgpt #fable #token #大模型开发 #多模态 #学AI