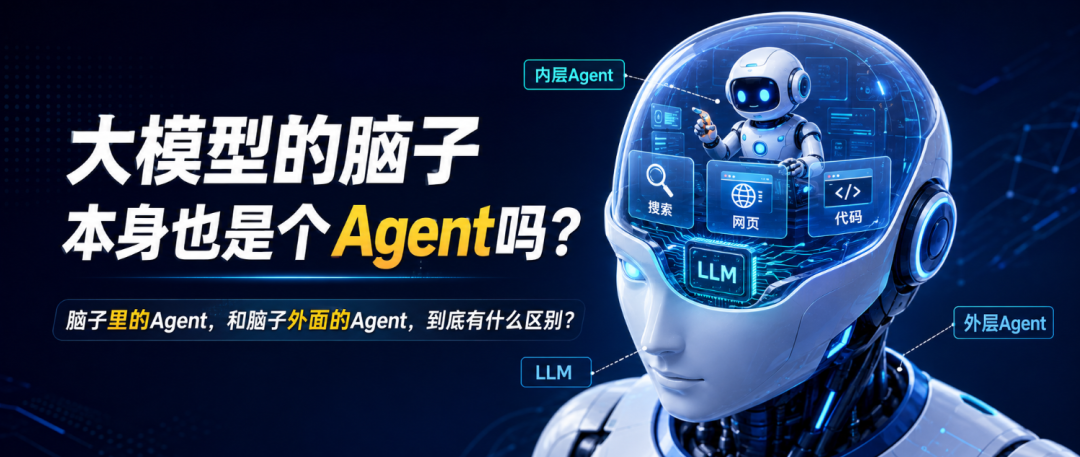
大模型的脑子本身也是个Agent吗?
一个让我困惑了很久的问题
前几天我在用ChatGPT网页版聊天,问了一个问题,它先回答了一部分,然后自己跑去搜索了一下,接着又回答了一些,觉得不够,又搜了一次,最后综合所有信息给了我一个完整的回复。
我当时的第一反应是:这不就是一个Agent吗?它自己判断需要搜索什么,自己去搜,自己整合结果。感知、决策、行动,标准的Agent循环。
然后我很自然地想到一个问题:网页版不就是在调API吗?那是不是说API本身就已经是一个Agent了?
如果是这样的话,事情就变得有点奇怪了。因为在我的理解中,API就是大模型的"脑子",是最核心的推理能力。而Claude Code、各种应用框架,是套在脑子外面的"身体",负责执行和编排。
那现在的情况岂不是变成了:脑子里有一个Agent在干活,脑子外面还套了一层Agent在指挥?
这两个Agent是同一个东西吗?它们各自在做什么?这个问题困扰了我很久。
先搞清楚大模型到底是什么
要回答这个问题,得先退一步,看看大模型最原始的状态。
大模型本质上就是一个函数。你给它一段文字,它续写下一段文字。就这样,没了。它没有"手",不能上网搜索,不能读你电脑上的文件,不能执行代码,不能操控浏览器。
在这个最纯粹的状态下,它显然不是Agent。Agent的核心是"感知→决策→行动"的循环,而纯模型只有"决策"这一步。它能"想",但不能"做"。就像一个被绑在椅子上的天才,脑子很好使,但什么都干不了。
那我在网页上明明看到它自己去搜索了啊?
网页端不等于API
这就触及了第一个认知盲区。
很多人(包括之前的我)都有一个隐含的假设:我在ChatGPT或Claude的网页上跟模型对话,这个网页就是API的界面,网页端的能力等于API的能力。
不对。
网页端是一个完整的产品。它在API之上加了一整套东西:对话历史管理(帮你存储和拼接多轮对话)、文件上传和处理、记忆系统(跨对话记住你的偏好)、UI界面,等等。你看到的"它自己去搜索了",是产品层的编排逻辑在驱动的。
那么问题来了:API到底能不能自己搜索?
转折:API确实可以自己搜索
这才是整个问题最关键的地方。答案是:能,但需要你主动打开一个开关。
现在的大模型API支持两种工具模式。
第一种:客户端工具(client tools)。 你在调API的时候告诉模型"你有一个叫search的工具可以用"。模型看了你的问题后,会说"我想调用search('2026年新能源汽车市场')"。但注意,它只是说出了这句话,然后就停了。什么都不会发生。API把这个"请求"返回给你的代码,你的代码去调搜索引擎,拿到结果,再把结果发回给API,模型基于结果继续回答。
在这个模式下,模型有"判断力"(它知道该搜什么),但没有"执行力"(它自己不搜)。就像一个指挥官说"去侦察那个山头",但他自己不去,得士兵去。
第二种:服务端工具(server tools)。 你在API请求中加一个参数,比如 tools: [web_search]。这时候Anthropic的服务器就会在云端帮你执行搜索。模型自己判断搜什么、搜几次,服务端自动执行搜索并把结果喂回模型,模型基于结果可能再次决定搜索其他关键词,最后综合所有结果给你一个完整回答。整个过程在一次API请求内部自动完成,你什么都不用管。
Anthropic官方文档的原话是:"API在服务端的agentic loop中执行工具调用。"
注意这个词:agentic loop。官方自己都说了,这是一个Agent循环。
而且不只是搜索。Anthropic目前提供的服务端工具还包括:
web_fetch:抓取指定网页和PDF的完整内容
code_execution:在沙箱容器中运行Python和Bash代码
tool_search:从大量工具中按需发现和加载
advisor:让当前模型在生成过程中咨询更高智能的顾问模型
computer use:浏览器和桌面自动化(beta阶段)
这些工具可以在一次API请求中组合使用。模型可能先搜索一个问题,觉得需要验证数据,自己写一段Python代码跑一下计算,然后基于计算结果再搜索更具体的信息。这整个过程全部在Anthropic的服务器上自动完成。
所以回到最初的问题:API到底能不能像Agent一样工作?
能。但前提是你得开启server tools。没开就是纯粹的"文字进文字出",开了就有了完整的"思考→行动→再思考"循环。
用一行代码说就是:
# 没有agent能力,纯文字对话response = client.messages.create(model="claude-sonnet-4-6",messages=[{"role": "user", "content": "调研一下2026年新能源汽车市场"}])# 模型只能说"我无法获取实时信息"# 有agent能力,服务端自动执行response = client.messages.create(model="claude-sonnet-4-6",messages=[{"role": "user", "content": "调研一下2026年新能源汽车市场"}],tools=[{"type": "web_search_20250305", "name": "web_search"}])# 模型自动搜索多次,综合结果,返回完整调研报告
一个参数的差别,就是"纯脑子"和"脑子+手脚"的区别。
那网页端到底用的是什么?
搞清楚了API的两种模式,回头再看网页端就很清晰了。
网页端(Claude.ai、ChatGPT等)底层调的就是同一个模型,搜索用的也是同一个server tool。网页端只是帮你默认开启了这些工具,再加上对话历史管理和各种产品功能。
所以网页端和API的关系不是"两个不同的东西",而是:
网页端 = 同一个API + 默认开启的server tools + 对话管理 + 记忆系统 + 文件处理 + UI
如果你自己调API时也把server tools打开,在"模型推理+工具执行"这个层面上,你拿到的能力跟网页端是一样的。网页端多出来的只是对话管理和产品功能这些包装。
回到那个核心问题
现在可以回答最开始的困惑了:脑子里有Agent,脑子外面也有Agent,它们是同一个东西吗?
不是。它们是不同粒度的循环。
用一个三层框架来看:
第一层:裸模型。 只负责推理,文字进文字出。不是Agent。
第二层:带server tools的API。 在单次请求内部,模型可以自主决策、调用工具、看结果、再决策。这是"脑子里的Agent"。它很像一个短生命周期的Agent:接到一个任务,自己想办法搞定,交付结果,然后就消失了。一次请求结束后,它不记得你上次问了什么,也不会主动做后续跟进。
第三层:产品层(网页端、Claude Code等)。 在API之上加了状态持久化、多步任务编排、环境交互等能力。这是"脑子外面的Agent"。它负责跨请求的状态管理、多步任务的拆分和协调。
所谓"脑子里的Agent"解决的是:这个问题我该搜什么、搜几次、怎么综合。 所谓"脑子外面的Agent"解决的是:这个大任务该拆成几步、每步调一次API、结果怎么串起来。
以Claude Code为例:你让它重构一个项目。Claude Code(外层Agent)把任务拆成"先读代码→分析结构→修改文件A→修改文件B→跑测试"好几步。每一步都调一次API。而在每一步内部,API可能又启用了server tools,自己搜索了一些技术文档或者跑了一段验证代码(内层Agent)。两层循环,各管各的,协同工作。
一个容易踩的坑
很多人在理解这些概念的时候,会把几件不同的事情混在一起。比如觉得"API是无状态的"就等于"API没有Agent能力"。
其实不是。这里有四个独立的维度:
对话状态:多轮对话是否被记住。Anthropic的API不自动记,每次请求都要你自己把历史发过去。OpenAI的Responses API可以在服务端帮你管。
工具执行:工具由谁来跑。客户端工具由你的代码跑,服务端工具由云端跑。
Agent循环:单次请求内部能否自主"思考→行动→再思考"。开了server tools就能。
数据持久化:数据存多久。Anthropic服务端保留API日志最多30天,但你没有接口去取。
这四件事是独立的,不能用一个维度的结论去推断另一个维度。"无状态"只是说多轮对话不自动记忆,跟"单次请求内部能不能像Agent一样工作"是两码事。
所以,大模型的脑子本身是Agent吗?
严格说,大模型本身不是Agent。它就是一个推理函数。
但现在的API给它装上了server tools之后,它在单次请求内部确实能自主"思考→行动→再思考",表现得很像一个短生命周期的Agent。而产品层(网页端、Claude Code)在此之上又加了一层更宏观的Agent循环。
所以不是"脑子里有Agent",更准确的说法是:同一个模型被放进了不同层次的循环中,在每一层都展现出不同粒度的agentic行为。
你以为只有一个Agent,其实是两层循环在协同工作。你以为脑子和身体是分开的,其实脑子本身已经长出了一小截手臂,能做一些简单的动作了。只不过要完成更复杂的任务,它还是需要外面那个更大的身体。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。