给足算力,AI 能无限聪明下去吗?
这两天我在疯狂地用 Claude Opus 5.5,感受就是太强了,太舒服了。它不仅能解决有深度的问题,还能用人话讲给你听,简直集 Opus 4.6 和 Fable 的智能之大成。
突然,我脑子里闪过一个问题:它的智能程度确实又有了新的突破,那么,它能无限聪明下去吗?它只是人类智慧的集大成者,还是说,它有可能超越人类?
顺着这个问题一路追问下去,会发现它比想象的深得多。这篇文章记录的就是这条思考路线。先说结论:最初的直觉,只对了一半。
一、它学到的不是答案,而是"动力学方程"
关于大模型,最常见的说法是:它是人类全部知识的蒸馏。这个说法没错,但容易让人误解,好像模型是一个巨大的数据库,把人类写过的答案压缩存了起来。
事情并非如此。大模型的训练任务是预测下一个词。想一想,要把一篇数学证明的下一步预测对,把一段调试代码的下一行预测对,光记住答案是不够的,必须在某种程度上模拟写出这些文字的那个人是怎么思考的。所以模型真正学到的,是人类思考的过程,是从一个状态跃迁到下一个状态的规则。
打个比方。你可以记住一千条炮弹的飞行轨迹,也可以学会 F=ma。前者只能复述见过的轨迹,后者能算出从未见过的轨迹。如果大模型学到的是人类思考的"动力学方程",那它就不只是在复刻人类,它可以沿着这个方程继续往前走。
沿着这个比喻再往下想一步。如果思考是一个状态按照规则跃迁到下一个状态的过程,那么推进思考,本质上就是反复运用这些规则,一步一步往下推演。而这恰恰就是"计算"的含义:从已知的状态出发,按照规则得出新的状态。人类几千年的科学史,可以看作全人类用大脑共同进行的一场漫长推演。
从这个角度看,"人类的聪明才智"指的是:在当前状态下,这场推演走到的边界。边界之外之所以还没有人到达,也许只是因为推演的步数还不够,没有人算到那里。
由此可以得出一个大胆的直觉:智能本质上是一个可以计算的东西。有了方法论,再给足够的算力和时间,它就能不断往前,无限算下去。人类的边界,只是一个算力的边界。
这个直觉有现实证据支持。现在的推理模型之所以更强,很大程度上是因为它们在回答之前花了更多计算去"想",这几乎就是"有方法论,再加算力"的直接体现。而且即使不往前走,在广度上它也已经超过了任何一个人:没有人能同时读完物理、法律、医学、编程和古典诗词的大部分文献,而跨领域的组合本身就能产生新东西。
二、只有算力,是不够的
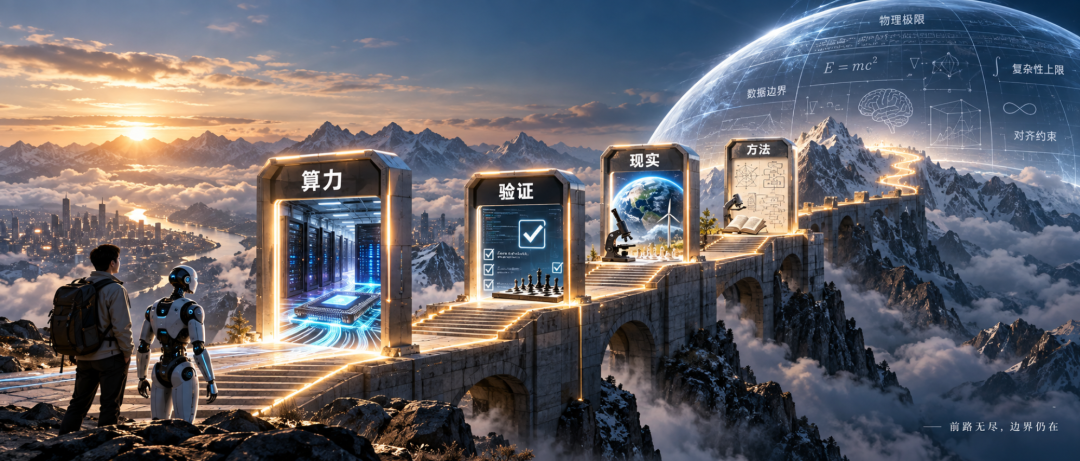
但仔细推敲,这个直觉有漏洞。算力之外,至少还需要三样东西。
第一样是验证。有了方法和算力,还得知道自己走的方向对不对。AlphaZero 能在围棋上远远超过人类,是因为围棋有一个完美而廉价的裁判:输赢。数学证明可以被形式化检查,代码可以跑测试,这些领域都有可靠的裁判。但如果没有裁判,算力越多,可能只是在错误的方向上走得越远。一条很长的推理链里,每一步的小错误都会累积,没有纠错机制的"无限计算",更像是漂移,而不是前进。
第二样是与现实的接触。人类历史上很多关键突破,不是靠纯粹推理想出来的,而是从对现实的观察中得来的。天文学家长期精确观测,发现水星轨道存在无法用牛顿力学解释的微小偏差;物理学家精确测量黑体辐射,得到一条经典理论无法解释的曲线;弗莱明则是偶然发现培养皿上的一块霉斑杀死了周围的细菌。这些都是现实世界提供的新信息,在当时已有的所有文本里都不存在。
在自然科学里,最终的裁判是物理世界,而现实世界有它自己的节奏:细胞要一天天培养,材料要一炉炉烧制,新药的临床试验要以年计算。这个节奏不会因为芯片变快而加快。
第三样是方法论本身的进化。前面的比喻里,F=ma 是固定的。但人类智慧的历史,恰恰是方程本身不断改变的历史:微积分、概率论、对照实验、可证伪性,这些都是被发明出来的新"动力学"。
那么,方法论进化的动力本身,是否也藏在已有的信息里?答案是一半一半。可以类比 DNA:DNA 里包含了"突变加选择"这套进化机制,但不包含未来会出现的物种,未来的物种是这套机制和环境碰撞之后才产生的。方法论也是这样。"如何发明新方法"的模式,已经在人类的文本里了:类比、抽象、注意反常、把旧工具用到新问题上。AI 可以学到这些,而且已经做到过:2022 年,DeepMind 的 AlphaTensor 找到了乘法次数更少的矩阵乘法算法,在某些情形下打破了保持五十年的纪录;2023 年,AlphaDev 发现了更快的小规模排序程序,已被并入广泛使用的 C++ 标准库。
但历史上很多新方法论,是被新问题逼出来的:概率论起源于对赌博问题的研究,最小二乘法诞生于处理天文观测误差的需要,牛顿的微积分与描述运动密切相关。机制在已有信息里,原料却要从外部世界不断输入。
于是,最初的公式需要修正:智能的前进需要四个引擎,方法论、算力、验证、与现实的接触。
这个修正带来一个可以检验的推论:AI 对人类的超越,会最先发生在有可靠裁判的领域,比如数学、编程和各种博弈。而在需要与现实反复碰撞的领域,比如生物、材料、医学,AI 更可能扮演的角色是让人类科学家跑得更快,而不是独自跑到前面。
三、四个引擎,四道天花板
接下来的问题是:就算四个引擎都具备,智能能无限走下去吗?
回答这个问题之前,需要先说清楚"可计算"是什么意思。
1936 年,图灵想象了一台极简的机器:一条无限长的纸带,分成格子,每格写一个符号;一个读写头,每次读一个格子;一张规则表,写着"如果处于状态 A、读到符号 1,就把它改成 0,右移一格,进入状态 B"之类的规则。仅此而已。这台机器的惊人之处在于,任何能用明确步骤描述的计算,它都能完成,只是可能很慢。你的手机、超级计算机、拿着纸笔严格按步骤算题的人,在"能算什么"这件事上完全等价,差别只在速度和内存。
反过来,"不可计算"的意思是:根本不存在一套步骤能解决这个问题,和算力大小无关。最著名的例子是停机问题:不存在一个通用程序,能判断任意程序最终会停下还是永远运行下去。
有了这个基础,会发现一件很有意思的事:前面说的四个引擎,每一个推到极致,都会撞上一道天花板。
算力推到极致,撞上物理的天花板
计算需要能量和物质,而物理定律有硬约束:擦除一比特信息存在最低能耗(兰道尔极限),一定空间内能存储的信息量存在上限(贝肯斯坦界),信号传递不能超过光速。物理学家塞斯·劳埃德估算过,整个宇宙自诞生以来,最多也只能进行大约 10 的 120 次方次基本运算。
不过对比一下就知道空间还有多大:人脑的功率只有大约 20 瓦,神经信号的传导速度远低于光速,大脑的尺寸还受到能量代谢等因素的约束。人类离物理极限,差了很多个数量级。
验证推到极致,撞上逻辑的天花板
1931 年,哥德尔证明:任何足够强且自洽的形式系统里,总存在真但无法被证明的命题。图灵的停机问题,也是同一类结论。换句话说,裁判本身有盲区,总有一些对错,是任何裁判都判不了的。
这里出现了一个耐人寻味的对称。回看前面的推论:AI 最先超越人类的地方,是数学、编程这些有可靠裁判的领域。正因为有裁判,AI 才能自己检验对错、自己进步,而不必依赖人类的示范。而现在我们看到,裁判本身也有判不了的地方。于是,验证这同一样东西,扮演了两个角色:它是 AI 超越人类的阶梯,也是一切智能抵达完备的边界。
与现实的接触推到极致,撞上信息的天花板
在混沌系统里,初始状态的微小误差会被迅速放大。以中纬度地区的逐日天气为例,研究表明,即使预报模型和初始观测都接近完美,可预报的极限也只有大约两周。这个极限来自大气本身的性质,而不是预报员不够聪明。没有观测到的东西,再聪明也推不出来;误差会增长的系统,再聪明也看不远。
更深一层,即使一个系统每一步都完全可计算,有些过程也没有捷径,唯一知道结果的办法就是一步步模拟下去,这被称为计算不可约性。2015 年,三位物理学家在《自然》上发表论文,证明了一个量子多体物理中的核心问题(给定一个系统,判断它是否存在"能隙")在一般情况下是不可判定的:不存在任何算法能对所有情形给出答案,某些情形下答案甚至独立于数学公理。也就是说,即使宇宙本身是可计算的,关于宇宙的某些问题,也可能永远无法回答。
方法论进化推到极致,撞上收益递减的天花板
方法论的进化,推动着一切进步。但进步本身在变得越来越难。
2020 年,经济学家布鲁姆等人发表了一篇题为《好点子是否越来越难找?》的论文。他们考察了半导体、农业、医药等多个领域,发现研究投入大幅上升,而研究效率在急剧下降。最典型的例子是摩尔定律:维持芯片密度每两年翻一番所需的研究人员数量,已经是上世纪七十年代初的 18 倍以上。我们看到的平稳指数增长,是靠不断膨胀的投入抵消了不断下降的效率换来的。低垂的果子先被摘完,后面的越来越高。
大模型领域也有同样的规律。缩放定律显示,模型性能随算力的提升大致呈幂律关系,想获得同样幅度的进步,需要的算力是成倍增长的。
但智能有一个其他技术没有的特点:它可以用来改进产生智能的东西。更好的芯片、更好的算法、更好的数据,都可以由更聪明的系统来设计。早在 1965 年,数学家古德就提出过"智能爆炸"的设想:如果每一次智能提升都让下一次提升更容易,增长就会自我加速。
把这两股力量放在一起,问题就清楚了。布鲁姆的研究说明,指数增长需要研究投入不断增长才能维持;而 AI 的特殊之处在于,它本身可能成为研究投入,"研究人员"的数量可以像算力一样增长。于是关键只剩一个:智能提升带来的研发加速,能不能跑赢问题本身变难的速度。跑赢了,就是加速;跑不赢,就是减速。技术史上,进步常常呈现为一连串 S 曲线的叠加:一个范式快速增长然后饱和,新的范式出现再来一轮,远看像平滑的指数,近看是一级级台阶。
四、用人的尺子去量
那么,AI 的智能现在到底在以什么速度增长?
要回答这个问题,不妨回到最朴素的角度:我们平时是怎么评价一个人聪明程度的?
智能没有绝对的单位。温度有绝对零度,长度有米,智能什么都没有。就连智商,本质上也是一个相对排名,衡量的是一个人在人群中处于什么位置。在实际生活里,我们评价一个人的能力,最常用的标准其实是:他能独立完成多大的事。新手只能完成几分钟的小任务,需要不断有人指导;熟手能独立完成一天的工作;专家能独立负责几个星期甚至几个月的项目。
有研究机构恰好用这把"人的尺子"去量了 AI。美国的非营利研究机构 METR 收集了大量软件工程和研究类任务,先测出人类专家完成每项任务需要多长时间,再看 AI 能以 50% 的成功率独立完成多长的任务。结果非常惊人:2019 年的 GPT-2 只能完成人类几秒钟就能做完的任务,而到 2026 年春天,最强的模型已经能完成人类专家需要至少 16 个小时的任务。2025 年 METR 发表的研究显示,这个长度大约每 7 个月翻一番;2026 年初的更新估计显示,2023 年以后翻倍速度还加快了,大约每 4 个多月翻一番。
所以,用人的尺子去量,目前的曲线不是在减速,而是在加速的指数增长。
但这把尺子有一个根本性的问题:它是用人类的任务做成的。METR 自己也注意到,现有任务集已经很难可靠测量超过 16 小时的能力。这不是一个偶然的技术问题。就像一个中学生分不清两位顶尖数学家谁更强,当被测量的对象超过了出题的人,用人做成的尺子就会到头。到那时,从人的角度看,曲线可能会显得变平,而原因并不是智能停止了增长,而是我们的尺子不够长了。
五、有极限,但不知道离它还有多远
回头重新审视最初的直觉:给足算力,就能无限算下去。
有一种可能是:存在一个上界,只是永远达不到。就像从 99 到 99.9,再到 99.9999,有一个极限在那里,可以无限逼近,但永远到不了。
数学里恰好有一个几乎完美的例子,而且它还带着一个意想不到的转折。
这个例子叫蔡廷常数,是数学家蔡廷在 1970 年代提出的,通常记作 Ω,可以粗略理解为"随机写一个程序,它最终会停下来的概率"。它是 0 到 1 之间一个确定的数。它有两个性质。第一,可以写一个程序,不断算出越来越大的近似值,这些近似值逐渐逼近 Ω,正是 99、99.9、99.99 的画面。第二,永远无法知道自己离 Ω 还有多远。可能已经非常接近了,也可能还差得很远,没有任何方法能够判断。任何一个形式系统,都只能确定 Ω 的有限多位数字。
这比"有极限但到不了"更微妙。不仅到不了终点,连自己走到了百分之几都不知道。
当然,有没有上界,还取决于怎么度量。如果数"已经知道的定理有多少条",这个数会无限增长,没有上界;如果衡量"掌握了全部真理的多大比例",就可能像 Ω 一样有界。而从物理的角度说,可观测宇宙的能量是有限的,任何物理存在的智能所能进行的计算总量,都有一个实实在在的上界。
结语:对了一半的直觉
回到最开始的问题:AI 是人类智慧的上限,还是能超越人类?
它能超越人类。它继承的不只是人类的知识,还有人类思考的动力学,再加上远超人类的算力,以及在某些领域里可靠的裁判。在这一点上,"给足算力就能不断往前"的直觉是对的。
但"无限算下去"只对了一半。智能确实可以无限前进,哥德尔定理从反面保证了这一点:因为总有尚未被证明的真理,探索永远不会结束,永远有下一步可走。但智能无法无限逼近完备。四个引擎各自撞上各自的天花板,而其中最深的那一道,恰恰来自让它得以超越人类的那个东西。
永远有路可走,永远走不到尽头,甚至不知道自己走了多远。这也许正是智能最本质的处境。它不只属于 AI,也一直属于人类。区别只在于,AI 可能会比我们走得更远。
那么问题来了:如果有一天,它走到了我们看不懂的地方,我们还能判断它是对的吗?还能信任它吗?这是下一篇要讨论的问题。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。