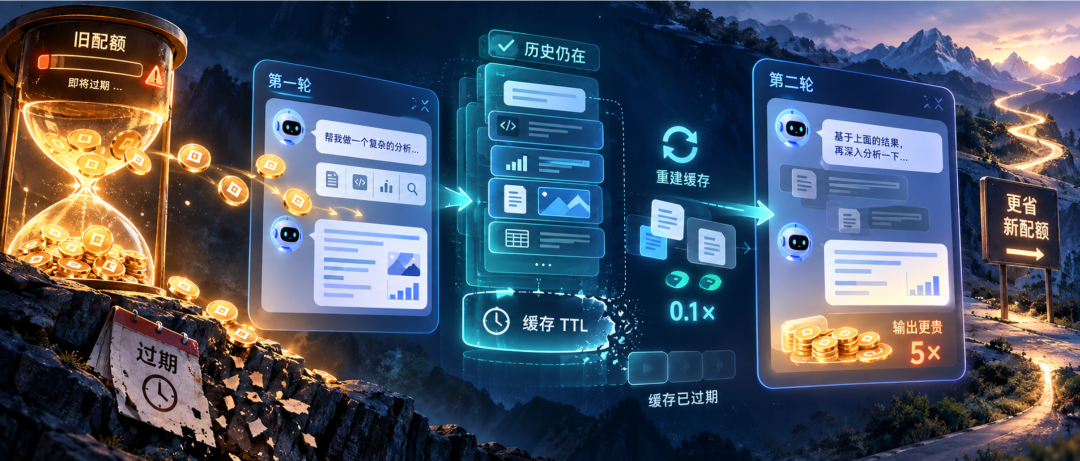
如果 token 不用就过期,那赶紧用掉是否可以省 token?
一个很常见的纠结
一周的固定配额马上就快刷新了,我们看了一眼剩余额度,还有不少 token 没用完,过了重置时间就清零了。
手头正好有个问题想问 Claude。问题比较复杂,估计要分两(多)轮才能搞定:第一轮让 Claude 帮我们调研分析,第二轮根据结果深入讨论。但今天只有时间问第一轮,第二轮得过几个小时甚至明天才能继续。
我们知道 Claude 的提示缓存有 TTL(生存时间),对话间隔超过这个时间,缓存就过期了。那等我们回来问第二轮的时候,之前的对话历史会被当成"全新内容"重新计费。
于是纠结来了:赶紧用旧配额问完第一轮?还是让旧配额过期,等新配额来了从头问?缓存过期后,之前的对话不是要重新付费加载吗,提前问真的省了吗?
这篇文章就来把这笔账算清楚。
开始之前先说一个前提:本文的数学计算基于 Claude API 的公开定价模型(cache read 0.1×、1 小时 cache write 2×、output 5×)。Claude Pro / Max / Claude Code 套餐的 usage limit 在底层共享同样的 token 消耗逻辑,但 Anthropic 没有公开它与 API 价格之间的精确换算公式。所以下面的分析可以作为理解成本结构的近似模型,但不能直接等同于套餐的配额扣减规则。此外,如果你的套餐同时存在多层额度(比如 Max 的 5 小时 session limit 和 weekly limit),需要确认即将过期的确实是"不用就白白消失"的那一层,才适用本文的结论。
每轮对话到底在花什么钱
如果你看过我之前文章《一文讲透大模型对话的缓存计费机制(高阶版)》,你已经知道 Claude 的 API 是无状态的,每次追问,整段对话历史都会被重新发送给模型。缓存机制的作用是让这些重复发送的历史不用每次按原价计费。
简单回顾一下,每轮对话涉及的 token 费用分三种(以 1 小时 TTL 为例):
| 0.1× | ||
| 2× | ||
| 5× |
关于缓存的完整机制,上一篇文章里详细讲过,这里不再重复。本文只聚焦一个问题:缓存过期的情况下,提前用掉配额到底划不划算。
第一轮结束后,上下文里到底留下了什么
这是接下来算账的基础,需要搞清楚。
一轮对话结束后,对话历史中会保留几类内容:
你发的消息和 Claude 的文字回复,这些完整保留在历史里,没什么争议。
工具调用和工具结果,也完整保留。如果 Claude 在回答过程中读了文件、做了搜索,工具返回的完整内容都会留在历史中。一个典型的 Claude Code 编程对话,工具结果占到历史体积的一半以上是常见的。(注意:Anthropic 提供了"上下文编辑"和"上下文压缩"这两种 API 功能,可以主动清理或压缩历史内容。Claude Code 在对话过长时会自动触发压缩。但在正常长度的多轮对话里,如果没有触发这些机制,工具结果会一直留在历史中。)
思考过程,这部分需要特别说明。
Claude 在回答问题前会先做一段内部推理,叫做 thinking。API 返回时,这段思考会作为一种专门的内容块(thinking block)出现在回答之前。每个 thinking block 除了你能看到的思考文本,还带一个加密签名,里面存着完整推理内容的加密副本。
你看到的 thinking 文本通常是一份摘要,甚至可能是空的(取决于模型的配置)。但这不等于思考内容消失了。加密签名会把完整推理带回给模型。
那么关键问题来了:第二轮请求时,这些 thinking blocks 还在不在上下文里?
根据 Anthropic 的官方文档,这取决于模型:
当前主流模型(Opus 4.5 及之后的 Opus、Sonnet 4.6 及之后的 Sonnet、Fable 5.1 等):默认保留所有之前轮次的 thinking blocks。它们会占用上下文窗口,并且像对话历史中的其他内容一样按输入 token 计费。
较老的模型(早期 Opus 和 Sonnet、所有 Haiku):API 会自动剔除旧轮次的 thinking blocks,不占上下文,不产生输入费用。
所以对于现在大家常用的模型,thinking blocks 确实会留在上下文中并在后续轮次作为输入计费。
这里有一点需要特别注意:模型生成 thinking 时按 output 价格计费的 token 数(output_tokens),和这些 thinking blocks 在下一轮作为 input 时占用的 token 数,是两套不同的计数。前者是完整内部推理过程的计费量,后者是 thinking blocks 加上加密签名在下一轮实际占用的输入量,两者的 token 化方式不同。想准确了解 thinking 在后续轮次到底占了多少输入,应当查看 API 返回的 usage 字段(或 Claude Code 的本地日志),或使用 Anthropic 的 Token Counting API,而非从上一轮的 output_tokens 直接推算。
总结一下:对于当前主流模型,第一轮结束后留在上下文中的东西包括:你的消息、Claude 的文字回复、工具调用和工具结果、以及保留下来的 thinking blocks。这些都会在第二轮作为输入重新发送并计费。
第一轮的回答,在第二轮里怎么计费
理解了上下文里有什么之后,还有一个计费规则需要讲清楚。
Anthropic 的自动缓存机制有一个明确的规则:只有上一轮请求中已经作为输入出现并写入缓存的内容,下一轮才可以按便宜的 cache read(0.1×)计费。
第一轮请求时,模型收到的输入是系统提示加上我们的问题,这些内容在第一轮就被写进了缓存。但第一轮的回答(包括文字回复和 thinking blocks),在第一轮时还是输出。它们到第二轮才第一次变成输入。所以即使缓存完全没有过期,这些内容在第二轮也要先做一次 cache write(2×),不是 cache read(0.1×)。
这个"身份转变有一轮延迟"的规律,在上一篇文章中讲多轮对话缓存行为时就提到过。
把这两件事结合起来,我们可以把每一轮请求中的输入内容分成两块:
「已缓存前缀」:上一轮请求时已经作为输入存在的内容。这部分在上一轮就写进了缓存。如果缓存没过期,本轮可以按 0.1× 读取。
「本轮新增输入」:上一轮刚生成的内容加上本轮的新问题。这些到本轮才第一次作为输入出现,无论缓存过不过期,都是 cache write(2×)。
这里要注意一个容易混淆的地方:「本轮新增输入」和上一轮的「输出」是两个不同的数字,不能互推,也没有固定的大小关系。
两者的关系可以这样理解:
本轮新增输入 = 上一轮输出 − 被剔除的内容 + 工具结果 + 新问题 + 编码差异拆开看每一项:
上一轮输出(output_tokens)是模型实际生成并按 5× 计费的全部 token。如果开启了 thinking,这个数字包含模型内部完整推理过程的计费量加上最终文字回复。
被剔除的内容,指上一轮输出中不会进入下一轮上下文的部分。对较老的模型(早期 Opus/Sonnet、所有 Haiku),API 会自动剥离旧的 thinking blocks,这部分就会从新增输入中减掉。对当前主流的 keep-all 模型(Opus 4.5+、Sonnet 4.6+),默认保留所有 thinking blocks,这一项接近于零。
工具结果,如果上一轮调用了工具,工具返回的内容(比如读文件返回的 8,000 token)会进入上下文,但它不属于模型的输出。这一项会让新增输入比输出更大。
新问题,本轮用户追问的内容。
编码差异,thinking blocks 的加密签名在作为 input 时的 token 化方式,和原始 thinking 作为 output 时的计费方式不完全一致。这个差异的大小和方向取决于 Anthropic 内部的编码实现,外部无法精确预测。
所以对于当前主流的 keep-all 模型,在没有工具调用的纯对话中,被剔除的内容接近于零,新增输入 = 上一轮输出 + 新问题 + 编码差异,通常会略大于上一轮输出。一旦涉及工具调用,新增输入可能远大于输出。
本文后面的示例中,输出和新增输入会分别取独立的数值来计算,不做任何换算。
两轮场景:缓存过期到底多花了多少
先从两轮开始算。
示例参数(仅用于说明逻辑,基于 keep-all 模型的纯对话场景):
已缓存前缀(第一轮请求时的输入:系统提示 + 第一轮问题)= 5,500 token第一轮输出(按 output 计费的全部生成量)= 20,000 token本轮新增输入(保留的 thinking blocks + 文字回复 + 第二轮问题 + 编码差异)= 21,000 token第二轮输出 = 15,000 token
连续追问(缓存命中)的第二轮成本:
| 合计 | 117,550 |
缓存过期后追问的第二轮成本:
| 合计 | 128,000 |
多出来的成本 = 5,500 ×(2 − 0.1)= 10,450。
在只有两轮的情况下,缓存过期只改变了第一轮请求时已经写入缓存的那个前缀(5,500 token)。第一轮刚生成的回答到第二轮才第一次作为输入出现,所以无论缓存是否过期,这部分在第二轮都是 cache write,费用一样。
两轮场景:赶紧用掉过期配额 vs 等着一起问
方案 A(赶紧用): 趁旧配额没过期,先问第一轮。等新配额到了再问第二轮。因为间隔超过了 TTL,第二轮会遇到缓存未命中。
方案 B(等着一起问): 放弃旧配额,让它过期。等新配额到了再从头连续问完两轮,享受第二轮的缓存命中。
我们只看新配额需要承担多少成本。旧配额反正要过期,用不用都一样。
方案 A:新配额只需要出第二轮
| 方案 A 新配额合计 | 128,000 |
方案 B:新配额承担两轮
| 方案 B 新配额合计 | 228,550 |
方案 A 花 128,000,方案 B 花 228,550。方案 A 省了约 44% 的新配额。
差值是 100,550。对比两张表可以看到,方案 B 多出来的正好是蓝色两项:第一轮输出(100,000)和第二轮的已缓存前缀 cache read(550)。这两项在方案 A 中由旧配额承担了。而两个方案的 cache write 总费用完全一样:方案 A 写一次 26,500(53,000),方案 B 分成第一轮写 5,500 和第二轮写 21,000(11,000 + 42,000 = 53,000),互相抵消。
结论很清楚:赶紧用掉过期配额,一定会减少新配额的消耗。
但你可能会想:这个例子里,第一轮结束后缓存里只有 5,500 token 的初始输入,过期代价很小。如果我旧配额里已经连续问了好几轮,对话历史积累得很大,缓存过期的惩罚会不会让结论有变化?
三轮场景
这个疑问很自然,我们加一轮来验证。
在前面两轮的基础上补充第三轮的参数:
第二轮输出 = 15,000 token(已有)本轮新增输入(保留的第二轮 thinking blocks + 文字回复 + 第三轮问题 + 编码差异)= 16,000 token第三轮输出 = 10,000 token
关键变化来了。第二轮做完以后,缓存里已经不只是最初的 5,500 了。第一轮的回答在第二轮时第一次作为输入出现,被写进了缓存。所以缓存中的内容现在是 5,500 + 21,000 = 26,500 token。
到了第三轮,如果缓存没过期,这 26,500 token 全部可以按 0.1× 读取。如果缓存过期了,全部要重新按 2× 写入。
第三轮缓存命中:
| 合计 | 84,650 |
第三轮缓存过期:
| 合计 | 135,000 |
缓存过期多花了 26,500 × 1.9 = 50,350。是两轮时 10,450 的将近五倍。
惩罚确实变大了。那结论会反转吗?
方案 A:旧配额做前两轮,新配额做第三轮(缓存过期)
新配额 = 135,000,见上表格。
方案 B:三轮全部用新配额连续做
| 方案 B 新配额合计 | 313,200 |
方案 A 花 135,000,方案 B 花 313,200。方案 A 省了约 57%。
不但没有反转,优势反而更大了。
为什么缓存罚款变大了,反而更划算
看表格就非常简单,方案B的三轮输入(标红色部分)正好对应方案A的全部输入,而方案B多出来的,正是蓝色部分(一二轮的输出+一二轮的缓存前缀)。
也即真正拉开差距的是两样东西:
第一,前两轮的输出费用。 方案 B 中新配额要为前两轮的 output 买单:20,000 × 5 + 15,000 × 5 = 175,000。方案 A 中这笔钱全部由旧配额出了。输出 token 是 5× 的价格,这是最大的一块。
第二,方案 B 多出来的 cache read。 方案 B 连续做三轮时,新配额还要为第二轮读取一次已缓存前缀(5,500 × 0.1 = 550),第三轮再读取一次更大的已缓存前缀(26,500 × 0.1 = 2,650)。方案 A 中这些都由旧配额出了。
两项加起来:175,000 + 3,200 = 178,200。正好等于两个方案的差值(313,200 − 135,000 = 178,200)。
更多轮也是一样
这个规律可以推广。如果用旧配额连续做了很多轮,缓存中积累的历史会越来越大,过期后一次冷启动的重建代价也越来越大。但是,如果不提前做,这些历史本来也要用新配额一轮一轮地写入缓存。两边的 cache write 成本互相抵消。
而旧配额里那些昂贵的 output 成本(每个 token 按 5× 计价),一旦由旧配额承担,就再也不会回来找新配额收钱。缓存过期只影响输入侧的计费身份,不会让已经付过的输出重新计费。
所以不存在"历史长到某个程度,提前用旧配额突然变得不划算"的临界点。旧配额里完成的有效轮次越多,新配额省得越多。
缓存过期到底有没有把之前的工作"白问掉"
没有。
缓存过期后,消失的是服务器为了加速重复前缀计算而保留的 KV cache。之前轮次产生的对话内容并没有因此消失。Claude 的文字回复、保留下来的 thinking blocks、工具调用和工具结果,只要仍在消息历史中,后续轮次还是可以继续使用。
只是再次处理它们时,计费身份发生了变化:缓存过期后,所有截至上一次请求已经写入缓存的历史内容,都要从 0.1× 读取变成 2× 重新写入。对话做了越多轮,受影响的历史就越大。
但缓存过期不会让之前轮次的输出按 output 价格再收一次。Claude 在之前每轮花掉的 thinking 和回答生成费用已经发生过了。后续轮次需要支付的是这些保留内容作为输入再进入模型的成本,按的是输入侧的价格(cache write 2×),远低于输出价(5×)。
实操建议
配额快过期了?大胆用。 只要你的问题需要 Claude 思考和生成内容,提前用掉旧配额几乎总比浪费更划算。不必纠结缓存过期的事。旧配额里完成的有效轮次越多,新配额省得越多。
能连续问完仍然是最优解。 "赶紧用"比"不用"好,但如果时间允许在一个窗口内连续追问完所有轮次,那肯定是成本最低的。缓存命中意味着已缓存历史只按 0.1× 计费,单价只有过期后 2× 的 1/20。
thinking 会让上下文增长。 对于当前主流模型(Opus 4.5 及之后的 Opus、Sonnet 4.6 及之后),thinking blocks 默认保留在上下文中,后续轮次会作为输入计费。你看到的 thinking 文本可能是摘要甚至是空的,但实际保留在上下文中的部分可能更大。想准确了解占用了多少,看 API 返回的 usage 字段或 Claude Code 本地日志。
工具结果是历史膨胀的另一个主因。 如果你发现对话越来越慢、越来越贵,原因往往是 Claude 回答过程中积累的工具结果(文件内容、搜索结果等)在膨胀。
两轮无关就开新会话。 前面的分析假设后续轮次依赖之前的成果。如果两个问题完全独立,新开会话意味着后续轮次不带之前的历史,输入成本更低,结论更明确。
总结
回到标题的问题:如果我的 token 不用就过期了,我是否应该赶紧用掉?
应该。
缓存过期确实有额外的输入端成本。而且用旧配额做的轮次越多,积累的上下文越大,缓存过期时重建缓存的代价也越大。但如果选择不用旧配额,这些上下文本来也要用新配额来生产和写入缓存。两边的写入成本互相抵消,而旧配额里那些昂贵的输出费用(5× 的价格)则实实在在地省下来了。
简单说:缓存过期让后续轮次的输入贵了一些,但它无论如何不会让你为之前轮次的输出重新付费。你用旧配额买到的那些思考和回答,已经留在了对话历史里,等着你在后续轮次继续利用。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。