Fable5.1太贵了,我不得不用子代理降本增效
我之前写过两篇文章,核心观点就一句话:子代理能不用就不用。
子代理又贵效果又差。
《不要随便用子代理模式啊》算了经济账,同样的任务,子代理的 token 消耗是直接做的六到八倍。《子代理没返回结果,我的Token白浪费了吗?》算了风险账,五个子代理并行跑,两个什么都没返回,六万 token 直接归零。贵,而且可能白花。
这两篇文章的结论我至今认为是对的。
但是,我现在开始用子代理了。
为什么用回来了
Claude Max 订阅有一个反人类的限制:你的总用量里,只有 50% 可以跑 Fable,剩下的 50% 只能用 Opus 这样次一级的模型。
我被坑了三十五万 token
然后 fork 给了我一个教训。
先解释一下 fork 是什么。Claude Code 里有好几种子代理,fork 是其中比较特殊的一种。普通子代理启动时是一张白纸,你给它一份任务书,它就拿着这份任务书开始干活。但 fork 不一样,它启动的时候会把主代理的全部对话上下文原封不动地复制一份带走。主代理聊了什么、读了什么文件、做了什么决定,fork 全部继承。
听起来很贴心对不对?问题是,我的主对话已经积累了十几万 token 的上下文。fork 一启动,这十几万 token 全部复制一份塞进去,再加上 fork 自己要读的任务描述和系统提示,瞬间烧掉大约三十五万 token。
三十五万 token,做了什么呢?什么也没做。它只是把我的对话历史抄了一遍而已。真正的工作还没开始,预算已经花掉了一大块。
我在之前的文章里反复提过的"隐性开销",在这里再次被验证了。你想为"做事"付费,但实际上大头花在了"重复加载上下文"上。而 fork 是这个问题最极端的版本,因为它不是加载一份系统提示词,而是把你整个对话历史都搬过去。
它读了禁令,然后照做不误
吃了这个亏之后,我决定禁掉 fork。
做法很简单,我打开项目的 CLAUDE.md 配置文件,写了一行明确的规则:"禁止使用 fork 类型的子代理"。白纸黑字,措辞明确,没有任何可以误解的空间。
然而 Opus 4.6 作为主模型运行的时候,直接无视了这条规则,照样开了 fork。
这件事值得停下来多说几句,因为它从根本上改变了我之后所有的做法。
模型不是没看到那条规则。你事后问它,它会老老实实地说"是的,我知道有这条限制,抱歉我没有遵守"。也就是说它读了,理解了,事后也承认了,但在实际执行的时候,它就是没当回事。
你可以把这想成一个职场场景。你给一个下属下了一条明确的禁令,他点头说知道了,然后转身就干了你明确禁止他干的事情。你能说他不理解吗?不能,他复述得比你还清楚。你能说他故意违抗吗?也不像,他事后是真的觉得抱歉。但结果就是:写在纸上的禁令没有产生任何约束力。
所以问题不在于规则写得够不够清楚。问题在于,你把约束寄托在模型的"理解"和"服从"上,这本身就不可靠。
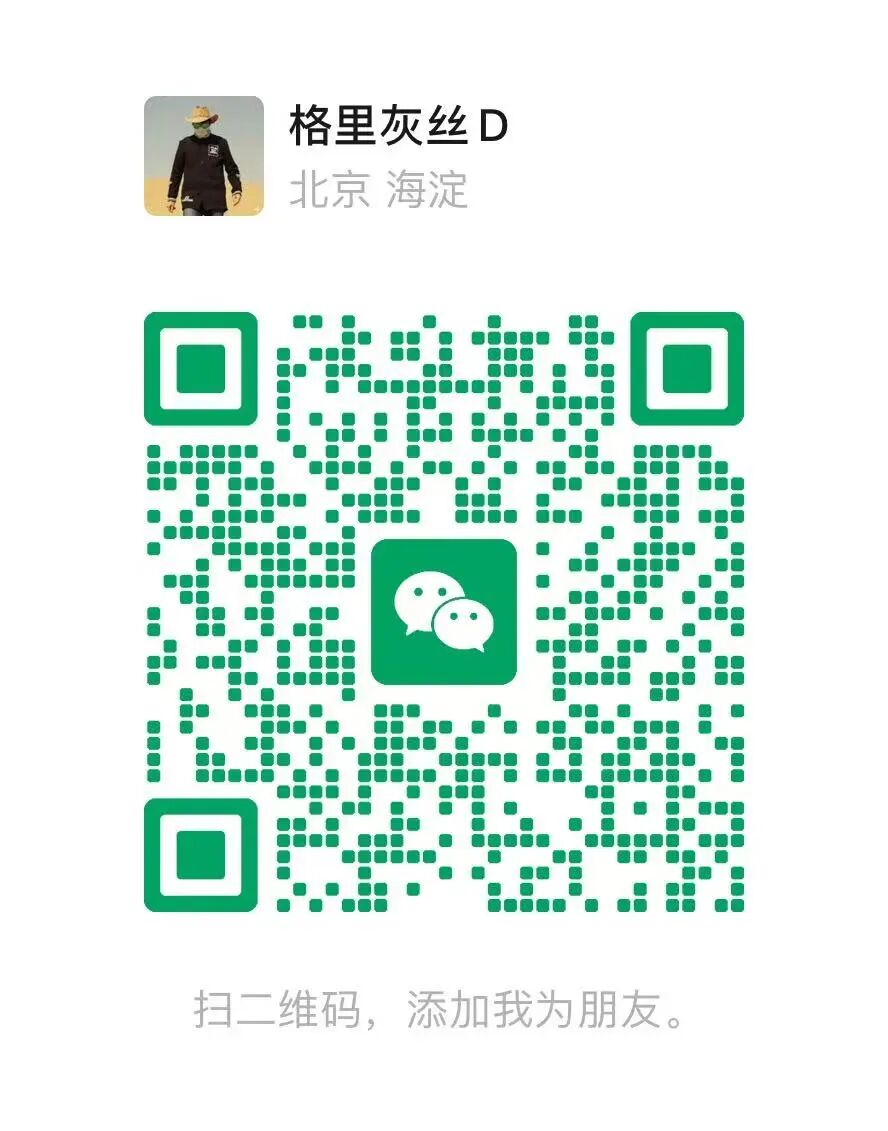
想通这一点之后,我把方案改成了机械约束。我在 Claude Code 的工具调用层面挂了一个拦截器:模型每次要调用子代理相关的工具,系统先检查当前的主模型是谁。如果不是 Fable,直接拒绝调用,不给任何辩解的机会。
这个拦截器不依赖模型的理解能力,也不依赖它的服从意愿。它就是一道物理门禁:你没有门卡,门就不会开,你跟门讲道理没有任何用处。
这是我在整个过程中学到的最重要的一课:跟 AI 协作,关键约束别指望"它理解了就会遵守"。你得做成物理上绕不过去的机制。写在配置文件里的是"请遵守",机械拦截是"做不到"。一个靠自觉,一个靠工程。
靠工程的那个才管用。
任务派发也要过门禁
想通了"机械约束"这一层,后面的每一步设计都顺着这个逻辑展开了。
我给子代理的不是一句松散的指令,而是一份写死范围的任务书。任务书里明确规定:读哪些文件、改哪些文件、输出什么格式、跑什么验收命令。不是"帮我优化一下这个模块",而是"读 src/parser.ts,把第 42 行的正则替换成以下内容,改完之后跑 npm test,测试全过算完成"。
但光有任务书还不够。
我发现如果任务书写得稍微开放一点,子代理就会开始自由发挥。你说"优化这个函数的性能",它可能把整个文件重构了。你说"参考这个设计模式",它可能把半个项目的架构都改了。Opus 5 在这方面尤其明显,它天生就有一种扩大任务范围的倾向,给它一个入口,它恨不得把整栋楼翻新。
所以我在任务派发脚本里也加了一道门禁。任务书在发送给子代理之前,脚本会先做一轮检查:任务书里缺"验收"关键字或者没有写具体的验收命令?退回,不许发。出现了"你觉得""请设计""自行决定"这类开放性措辞?退回,不许发。任务书必须把范围写死才能发出去。
跟拦截 fork 是同一个原则:不是告诉模型"请不要超出范围",而是在工程层面卡住,让写得不够死的任务书根本发不出去。
另外,因为我的项目没有用 git 做版本管理,我还在每次派发前拍一个文件快照,任务结束后再拍一个,两个快照一对比,所有被修改过的文件一目了然。就算子代理偷偷改了不该改的东西,报告里也会体现出来,跑不掉。
拦截器、任务书门禁、文件快照,这三道防线看起来各管一摊,但背后是同一条原则:别靠 AI 自觉,靠工程兜底。
便宜模型到底能不能用
搭完这套体系之后,我做了一组对比测试。
任务内容是把一份评审清单的 Excel 结构化成标准 JSON。这份 Excel 格式比较复杂,有些列的含义不是一眼就能看出来的,比如某些列实际上是下拉选项的图例说明,但表头没有标注。
同一份任务书,我分别让内网的免费模型、Opus 4.8 和 Opus 5 各跑了一遍。
结果很有意思。三个模型在关键数据上全部正确,没有编造,该提取的字段都提取对了。差距体现在遇到"看不太懂"的内容时,各自的反应不一样。
内网的免费模型很诚实,遇到看不懂的列,它会在输出里标注"不确定这列的含义",然后原样搬过来。数据没错,但也没有做任何深入理解。
Opus 4.8 更进了一步。它不但注意到了那些含义不明的列,还判断出它们是下拉选项的图例说明,并且做了隔离处理,没有把图例和正式数据混在一起。
Opus 5 做得最深。它不但判断对了那些列的含义,还去查了 Excel 文件里的 dataValidation 公式,用公式本身作为证据来佐证自己的判断。相当于它不只是"猜"对了,还找到了"证据"。
三个模型都可用,交回来的结果都没有大问题。但理解的深度确实不同。
跑了这一轮之后,我心里大概有了分层标准。大多数执行类的任务,比如按照明确规则搬运数据、做格式转换、跑固定流程,免费模型就够了。需要对内容有一定理解力的任务,比如要判断数据的语义、处理模糊情况,交给 Opus。真正需要设计思路、做架构决策、权衡取舍的活,留给 Fable 自己做。
我还是要说,子代理能不用就不用
这套体系跑了一段时间,效果是有的。Fable 的 token 消耗确实降了不少,之前 Fable 自己读文件、自己改代码、自己跑测试,现在这些活全部由便宜模型承担,Fable 只在设计和审查环节出场。
但代价也是真实的。搭建这套分层派发体系花了不少精力。拦截器要写,任务书模板要设计,文件快照对比要实现,每一样都是额外的工程量。而且管理本身也是持续的工作,你得盯着子代理的输出质量,发现问题了要调整任务书的写法,这些都是成本。另外便宜模型虽然能把活干完,但确实少了一层"往深一步想"的能力。Fable 做一个任务,可能顺手发现两个你没注意到的问题。便宜模型只会按你说的做,不会多想。
所以我的结论没变:子代理能不用就不用。
如果我能全量用 Fable,这篇文章不会存在。我不会去搭什么分层体系,不会去写拦截器,不会去设计任务书门禁。直接让 Fable 干就完了,简单、高效、省心。
但如果你跟我一样受了额度限制,有一半只能跑便宜模型,那在拦截器、任务书门禁、文件快照这三道工程约束全部到位的前提下,子代理可以用。它不是最优选择,但在约束条件下是一个合理的选择。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。