初中生都知道,大模型的数据还远没有用完
刷信息的时候,总会看到有人说:大模型的能力提升快到头了,因为互联网上的数据快被用完了。
我们对此有不同的看法。不是"数据还很多"这种量的层面上的不同意,而是从更根本的角度:我们认为现有的数据远没有被充分利用,数据中蕴含的信息还有大量没有被提取出来。
但要把这件事说清楚,我们得先回答一个看似简单实则不简单的问题:怎样才算"用完"?
这个问题的答案,每一个学过解方程组的初中生其实都见过。
一、从解方程说起
假设你有三个未知数 x、y、z,以及三个独立的方程。每个方程的本质作用是什么?是给系统施加一个约束,消除一个自由度。三个独立方程恰好锁定三个未知数,方程组有唯一解。此时每个方程的信息贡献都已经完全兑现,我们可以说方程被"用完"了。
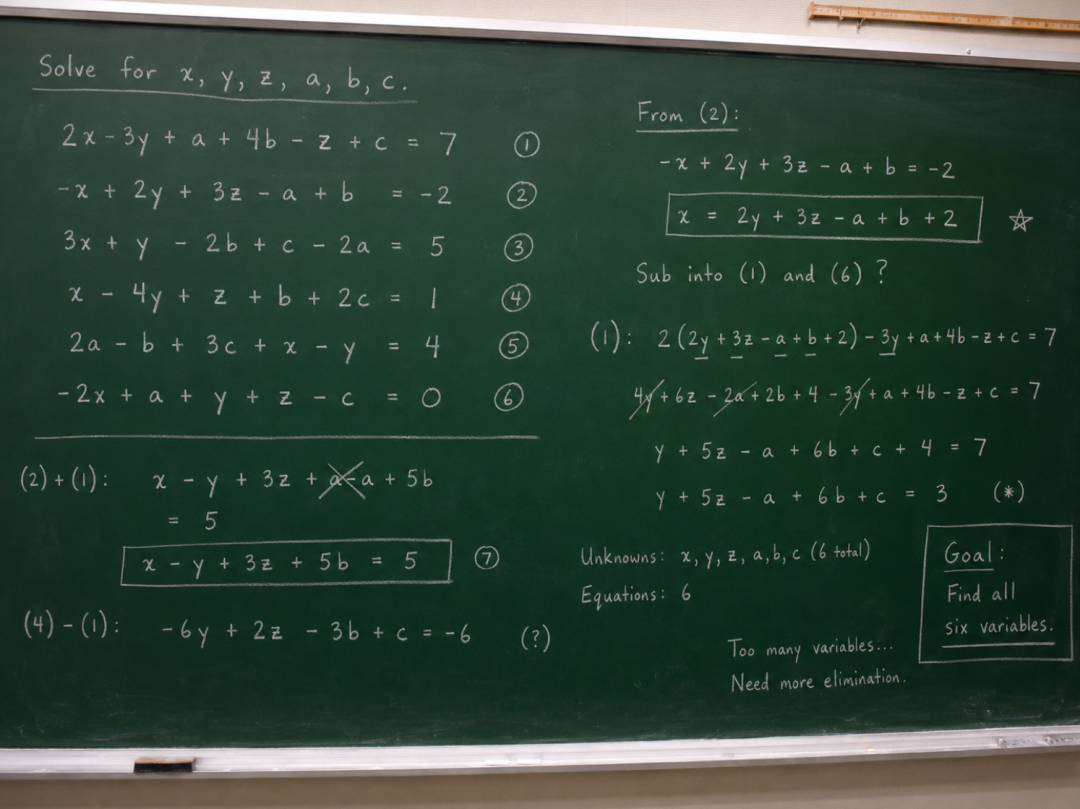
但这里有一个关键的问题:怎么判断一个方程是不是真的被用完了?
解方程组的时候,我们经常做的一件事是把一个方程代入另一个方程。代入之后,被操作的那个方程看起来变简洁了,有时候还挺漂亮。于是很容易产生一种错觉:那个被代入的方程已经"用过了",它的使命完成了。
真的是这样吗?
判断的标准其实很明确:看未知数的数量有没有减少。 如果代入之后,系统的独立未知量确实少了一个(比如从三个变成了两个),那说明这个方程的信息确实被充分利用了,它成功消除了一个自由度。但如果只是方程的形式变好看了,未知数的个数并没有变化,那这个方程的信息就只被用了一部分,甚至可能只是换了一种写法而已。它还有剩余价值,可以继续用来化简其他方程,直到真正消掉一个未知量为止。
这个区分非常重要。表面上的"用过"和本质上的"用完",是两回事。
二、这跟大模型训练有什么关系?
关系非常直接。
训练大模型,本质上是在寻找人类语言(或更广义地说,人类知识)背后的真实规律。我们把这个终极规律叫做真实分布 P。P 描述了在任何给定的语境下,合理的表达应该是什么样的。语法、语义、逻辑、常识、推理能力,全部编码在这个分布里。
我们永远无法直接看到 P 本身,就像你永远无法直接看到物理定律本身,只能通过实验观测去推断。而训练数据,就是这些"实验观测"。每一条训练数据,一篇文章、一段对话、一行代码,都是从 P 中采样出来的一个样本。它告诉模型:"在这个上下文下,人类实际上会这样表达。"
每一条数据,就相当于一个方程。它对那个我们正在寻找的 P 施加了一个约束,缩小了 P 可能的形态范围。比如"今天天气"后面大概率跟"很好"而不是"紫色",这就排除了一大片不合理的分布假设。
到这里,方程的类比就完全建立起来了:训练数据就是方程,真实分布 P 就是未知数,训练过程就是解方程。
三、"看起来用过了"不等于"真的用完了"
理解了这个对应关系之后,最关键的问题来了:现在的训练方式,是不是真的把每条数据的信息都用完了?
回想一下刚才解方程的经验。一个方程代入另一个方程,方程看起来变简洁了,但如果未知量没有减少,那方程就没有被真正用完。
大模型训练中存在完全类似的情况。模型在一批数据上训练之后,loss降低了,预测准确率提高了,看起来这批数据的"信息被吸收了"。但这就像方程被代入后看起来变简洁了一样,是表面现象。真正的判断标准应该是:模型对真实分布 P 的认知,有没有实质性地进步?那些深层的、结构性的规律,有没有被捕捉到?
现实中,很多数据在训练过程中被"浏览"了,但远没有被"理解"。模型可能学到了一些表面的统计相关性(像方程变好看了),但更深层的因果关系、逻辑结构、跨领域的抽象模式(相当于真正消掉一个未知量),还藏在数据里没有被提取出来。
这就是当下最核心的认知误区:人们看到数据被"训练过"了,就以为数据被"用完"了。但"训练过"只是"代入过",不是"解出来了"。
四、什么才叫"彻底用完"?
前面铺垫了这么多,现在可以精确地回答这个核心问题了。
回到方程的类比。一个方程被彻底用完,判断标准是什么?不是"这个方程被代入过了",不是"方程组的形式变简洁了",而是:它有没有真正消掉一个未知量。 消掉了,就是用完了。没消掉,不管形式上怎么变化,方程里的信息就还没有兑现。
对应到训练数据:一条数据被彻底用完,意味着它所包含的关于真实分布 P 的约束,已经完全转化成了模型参数中对 P 的认知。模型因为这条数据的存在,对 P 的某个方面从"不确定"变成了"确定",就像一个未知量被消掉了一样。如果模型只是在表面上降低了loss、提高了预测准确率,但对 P 的深层结构的认知并没有实质性推进,那就像方程代入后只是变好看了,未知量纹丝没动。
当然,这里面还有一个前置问题:数据中并不是所有内容都值得学。
回忆一下初中做应用题的过程。一道应用题给你一大段文字:小明去商店买了三斤苹果、两斤梨,苹果每斤比梨贵两块钱,总共花了多少多少钱。你要做的是从这段文字中提取出数学关系,列出方程。
这段文字里有两种东西。一种是有效信息:数量关系、价格关系、总价约束,这些可以转化为方程,是你解题需要的。另一种是无关的文字:"小明""商店"这些名字和场景描述,它们对列方程没有任何帮助。
训练数据也是一样。信号,就是那些可以转化为"方程"的部分:语法规律、语义关联、逻辑链条、事实性知识,这些反映了真实分布 P 的结构性规律。噪声,就是应用题里那些无关的文字:某篇文章作者的个人措辞怪癖、某条评论中的笔误、某段对话里偶然出现的不合逻辑的表达,这些不反映 P 的规律,只是这个特定样本恰好长这样。
所以完整地说,"彻底用完数据"需要满足两个条件:第一,从数据中正确地识别出哪些是"方程"(信号),哪些是"无关文字"(噪声);第二,也是更关键的,每一条被识别出来的"方程",都要真正消掉一个未知量,而不只是被代入后让形式变好看了就丢在一边。
信息论为这件事提供了一个精确的度量工具:互信息。
互信息这个词听起来很术语化,但核心思想很朴素。它度量的是:知道一件事之后,你对另一件事的不确定性减少了多少。
比如你不知道明天是否下雨,不确定性很高。但如果你知道今天气压很低,不确定性就大幅降低了,因为低气压大概率对应降雨。气压帮你减少了多少不确定性,就是气压和天气之间的互信息。
放到训练的语境中:训练数据和真实分布 P 之间的互信息,就是数据中全部可以转化为"方程"的信号总量,也就是全部可以消掉的"未知量"的总数。这是一个理论上的定值。当模型通过训练,把这些互信息全部吸收了,也就是每一个可消的未知量都被消掉了,数据才算被彻底榨干。
这也给出了"最合适的位置"的理论依据:还有未知量可以消但没消掉,就是欠拟合,数据还有油水可榨。所有未知量恰好消完,就是最优点。如果连噪声也开始拟合,模型就是在试图从"小明""商店"这些无关文字里硬提取方程,那就是过拟合。
五、现在到底处在哪里?
有了这个框架,就可以冷静地评估当前的状况了。
答案是:远在欠拟合的那一侧。 数据中的信号远没有被提取干净。
这个判断不只是理论推测,业界一线的实践者也从自己的经验中印证了这一点。OpenAI 的核心研发工程师翁家翌在一次访谈中说过一句很有穿透力的话:"每家的 Infra 都有不同程度的 bug,谁修的 bug 越多,谁的模型训得就越好。"
这句话初听像是在说工程管理,但用我们的框架来理解,它揭示了一个更深层的事实:当前的训练基础设施本身就存在各种问题,这些问题导致大量数据在训练过程中根本没有被真正使用。就像你一次性拿到了一千个方程,但因为你的计算工具有bug,很多方程在处理过程中被跳过了、被截断了、被错误地丢弃了,它们虽然"经过"了你的手,但从来没有真正参与到消元中去。修bug不是在发明新算法,而是让那些本来就在手边、却因为工具问题而被浪费掉的方程,重新回到解题过程中来。
换句话说,如果数据真的已经被用完了,那修bug应该不会带来模型性能的显著提升。但事实恰恰相反,修bug能明显改善模型效果,这本身就是一个强有力的证据:数据中的信息还大量残留着,只是因为工程层面的问题没有被充分提取。
除了基础设施的问题之外,还有更多层面的原因说明数据远没有被用完。
首先,当前的训练方式并没有对数据做充分的深度利用。大量的训练数据只是被粗略地遍历过,模型在上面快速扫了一遍就过去了。就像解方程时你拿到了一个方程,匆匆代入了一次,方程看起来变简洁了,你就放下了。但未知量并没有真正减少,这个方程里还有可以继续利用的约束。数据配比的优化、训练顺序的设计、数据质量的精细筛选,这些手段都在尝试更充分地从同样的数据中提取信息。
其次,提取信息的工具本身还可以更锋利。当前大模型的核心训练方式是预测下一个词。这就像你只会用一种代数技巧去解方程。同样的方程,换一种变换方式、换一种分解策略,可能还能提取出目前方法提取不到的约束。方程没变,但你解方程的能力升级了。
再者,很多信息本来就不在现有的数据形态中。文本只是人类知识的一种载体。图像、视频、音频、物理世界的交互反馈,这些都是真实分布 P 的不同侧面。只用文本训练,就像应用题只给了你一部分条件,你能列出一些方程,但不是全部。多模态训练不是锦上添花,而是在补充新的独立方程。
六、合成数据:把公式拿出来再用一次
最近几年有一个重要的趋势是合成数据。让模型自己生成推理过程、解题步骤,然后用验证器筛选正确的结果,再拿来训练。
很多人觉得这是在"无中生有",用模型自己编的东西来训练自己,听着像是在自欺欺人。
但从方程的视角来看,这件事有一个完全不同的解读。
回想一下:一个方程被用过一次之后,如果未知量没有减少,那它还有剩余价值。你可以把它拿出来,做做变形、做做整合,跟其他方程联立,看看能不能用另一种方式消掉某个未知量。
合成数据本质上就是这个过程。训练数据中存在一些尚未被充分利用的"公式",这些公式中蕴含的规律没有被当前的训练方式完全提取出来。通过让模型做推理、生成中间步骤,再用外部验证器检查对错,实际上是在对这些公式做变形和整合,试图从不同角度榨取它们的剩余信息。这不是凭空创造信息,而是把原来没用完的信息用另一种方式释放出来。
七、"到头了"的错觉
如果信号远没有提取完,为什么很多人觉得进步放缓了?
因为人们混淆了两件事:容易提取的信号被提取完了,和所有的信号被提取完了。
大模型发展的早期,每一步进步都很显著。模型从"语无伦次"变成"说话通顺",再变成"能做复杂推理"。这些巨大的跳跃,对应的是信号空间中最粗粒度、最显著的模式被学到了。
但越往后,剩下的信号越精细、越隐蔽、越难提取。从90分到95分的难度,远大于从60分到90分。这不是因为信号不存在了,而是因为提取精细信号需要更巧妙的方法。就像方程组中那些容易消元的未知量已经被消掉了,剩下的需要更高超的技巧去处理。
体感上的"放缓"不等于原理上的"到头"。
八、结语
回到最初的问题:大模型的能力提升到头了吗?
从信息论的视角看,只要训练数据中关于真实分布 P 的互信息还没有被完全提取,能力提升就没有到头。而以目前的训练效率来看,我们距离那个理论极限还很远。
当然,这个视角也给出了一个冷静的提醒。数据中的信号总量是有限的。在某个更远的未来,当所有独立约束都被充分利用、所有信号都被提取殆尽之后,大模型的能力确实会逼近一个天花板,它能完美地逼近真实分布 P,但不能超越 P 本身。
但至少在今天,断言"到头了"为时尚早。我们手里的方程还远没有解完,而我们解方程的能力,也还在不断进步。
· · ·
如果你觉得这篇文章有帮助,欢迎转发给同样关注AI发展的朋友。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。