大模型的Token生成动力学漫谈
我们都听过一句话:大模型的原理就是根据上文预测下一个字。
这句话当然是对的。但如果你真的停下来想一想,会发现一个问题。
一段话的意思,往往要到整段说完才完整。"我虽然很累,但还是决定……"后面接"继续干"和"放弃",意思截然相反。可是模型在输出"我"这个字的时候,"决定"后面的内容还根本不存在。
一个只看一步的系统,凭什么能完成一件需要全局规划才能做好的事情?
我们尝试来讨论这个问题。
· · ·
一个字一个字输出,含义为什么不跑偏?
先说一个容易忽略的事实:模型虽然一次只输出一个字,但它做决策时看到的是前面所有的内容。不是只看上一个字,而是看完全部上文再决定下一个字。
但这其实还不够。看到了全部上文又怎样?整句话还没说完,"目的地"还不存在,你朝哪里走?
仔细想想,人说话其实也是一个字一个字蹦出来的。但我们很少说到一半突然含义跑偏。为什么?因为脑子里有一个模糊的"我要表达什么"的意图在引导。你不需要把整句话在脑子里写完,只需要每个字的选择都受到那个意图的约束就行了。
大模型里有没有类似的东西?有的。每一个 token 在模型内部都对应一个"隐藏状态":一个由上万个浮点数组成的高维向量。这一万多个数字的特定组合,编码了上下文的语义、语气、话题走向和逻辑结构。换句话说,每个 token 不仅仅是一个符号,它在模型内部携带着丰富的信息,关于"前文说了什么"以及"后文应该往哪里去"的信息。
但知道这些信息"存在"还不够。它到底是怎么在每一步的 token 选择中发挥作用的?这些信息是以什么方式影响后续生成的?
要回答这个问题,我们需要引入一个动力学的视角,把这些信息理解为一种"能量",把 token 的生成理解为能量的释放过程。
Token 生成动力学
让我们把每一个已经生成的 token 想象成空间中的一个小球。
关键在于:这些小球不是静态的标记。它们携带着"能量",这种能量编码了语义信息、逻辑关系、情感色彩和话题走向。当你向大模型输入一段上文时,你实际上是在向系统注入了一组携带特定能量的初始粒子。
这里需要做一个重要的澄清:我们说的"能量"不是物理学意义上的能量。真正驱动系统运转的物理能量来自硬件:GPU 消耗的电能。每生成一个 token 都需要真实的电力输入来完成计算。如果断电了,不管前面积累了多少 token,系统不会自动吐出下一个字。token 本身不是燃料,计算才是燃料。
那我们说 token"携带能量"到底是什么意思?更准确地说,token 携带的是一种语义空间中的结构性约束:句法结构的预期、逻辑走向的倾向、概念之间的关联模式。这些结构存在于模型的高维表征空间中,是信息层面的、关系层面的,不是物质层面的。"虽然"携带的不是焦耳或千卡,而是一个"后面应该出现转折"的结构性约束。
我们之所以用"能量"来称呼它,是因为这种语义结构在功能上的行为与物理能量高度同构,它可以被储存、可以延迟释放、可以约束轨迹、可以在不同维度上分别发挥作用。这些动力学特征使得"能量"成为一个有效的类比框架,但它终归是类比,不是等同。在后文中,我们继续使用"能量"一词,但读者应当理解,它指的始终是语义空间中的结构性约束,而非物理能量。
这些能量不会一次性释放,而是随着 token 的逐步生成,按时序逐步释放出来。
具体来说,所有已有的 token 对即将生成的新 token 施加作用力。这种力源于它们携带的能量,每个已有 token 的语义内容、它在序列中的位置、它与其他 token 的关联强度,共同构成了一个力场,决定了新 token 该出现在状态空间的哪个位置。
"我虽然很累"这五个 token 各自携带着能量。"我"携带了主语的指向性,"虽然"携带了转折结构的预期,"很累"携带了负面状态的语义势能。这些能量共同施力,合力将下一个 token 推向"但"或"所以"这样的连接词,而不是一个毫无关联的字。
新 token 在合力作用下落定,比如选中了"但"。这一刻,两件事同时发生:第一,"虽然"中储存的转折预期的能量被部分释放了,因为转折结构已经兑现;第二,"但"这个新 token 本身携带着新的能量,它强化了后续内容将与前文构成对比的预期,对未来的 token 施加新的约束力。
然后所有 token(包括刚落定的"但")共同对下一个位置施力。"我虽然很累,但"这六个 token 的合力将第七个 token 推向"还是"这样的方向。
如此迭代。每一步都有力在作用,每一步都有能量在释放,每一步都有新的能量源加入系统。整个序列的展开就是一个能量逐步释放、力不断传递与累积的动力学过程。
这就是 Token 生成动力学的核心:token 如何生成?由前序 token 施加的合力决定。动力来源于哪里?来源于上文 token 中储存的语义能量。为什么最终含义能通过逐个 token 的生成而完整表达?因为完整的含义从一开始就以能量的形式编码在上文之中,生成过程不过是这些能量沿时间轴的有序释放。
这也彻底回答了"含义为什么不跑偏"这个问题。不是因为远处有一个目标在"拉"着轨迹,而是因为已有 token 中的能量在持续"推"着轨迹。只要能量场足够强、力的方向足够一致,轨迹就被约束在连贯的路径上。前面积累的 token 越多,能量场越丰富,约束越强。
这里还有一个值得注意的结构性特征:token 之间的相互作用不是两两独立的。在注意力机制中,一个 token 对新 token 施加的力的大小,取决于新 token 同时在"观测"所有其他 token:注意力权重通过 softmax 在所有已有 token 之间竞争分配。这使得这种力本质上是一种多体相互作用,而非独立的两两力的线性叠加。
能量释放的时间结构
到这里,Token 生成动力学的基本框架已经建立了。但如果我们进一步观察能量释放的过程,会发现它还有一个非常有趣的性质:能量的释放自带时间属性。
并不是所有能量都在 token 出现的瞬间就释放掉了。有些 token 储存的能量,要延迟到很久以后才真正发挥作用。
还是拿"虽然"来说。它在出现的那一刻,对紧接着的几个 token 其实影响不大,"虽然很累"和"因为很累"在局部的词语搭配上没有显著差异。"虽然"真正释放能量的时刻,是十几个 token 之后,模型需要决定用"但是"还是继续顺承的那个位置。在注意力机制的计算中,这体现为:生成"但"这个 token 的时候,模型回头给了"虽然"极高的注意力权重,它跨越了中间所有 token,在这个时刻才把它储存的转折预期能量兑现了。
这种延迟释放并非 Token 生成动力学独有的现象。在物理学中,势能的延迟释放是一个基本概念:压缩弹簧在压缩的瞬间储存了弹性势能,但只有在约束被解除时能量才释放。"虽然"就是一个被压缩的弹簧,转折结构的势能在它出现时就储存了,但要等到句子演化到需要转折的位置,才触发释放。在化学中,反应物可以长期稳定存在,能量储存在化学键中,直到催化剂出现或体系达到活化能阈值才一次性释放,"但是"扮演的正是催化剂的角色。
在音乐理论中,这个现象对应着张力与解决(tension and resolution)的结构。一个不协和的和弦制造了张力,这个张力不会立刻消解,而是悬挂数个小节,直到一个协和的和弦出现来"解决"它。听众感受到的表达力恰恰来自这种延迟释放的时间控制。在叙事学中也有经典对应如契诃夫之枪:第一幕墙上挂了一把枪,它必须在第三幕开火。叙事能量在第一幕储存,在第三幕释放。
但 Token 生成动力学中的延迟释放有一个独特之处:注意力机制允许任意两个 token 之间建立直接联系,不受序列距离的限制。一个 token 的能量理论上可以延迟任意长的时间才释放,只要在某个未来的时刻,注意力机制回头"看到"了它并赋予了足够的权重。这是一种非局域的延迟作用,与物理系统中力通常随距离衰减的性质不同。
能量释放的精细结构
如果我们进一步提升观察的分辨率,会发现能量释放的颗粒度比上面描述的还要细。
我们说每个 token 携带能量,但这个能量并不是一个标量,它是多维度的。每个 token 的隐藏状态是一个上万维的向量,不同的维度编码着不同类型的信息。模型使用的多头注意力机制(multi-head attention),比如 96 个注意力头,每个头负责捕捉不同类型的关联关系。每个头可以被理解为一个特定维度的能量释放通道。
这意味着:同一个 token 在不同维度上携带的能量,会在不同的时刻、向不同的未来 token 释放。
以"虽然"为例:它可能在某个注意力头上编码了句法信息(让步从句的起始标记),在另一个头上编码了语义信息(后续将出现对比关系),在又一个头上编码了语体信息(正式书面语的信号)。句法维度的能量可能在紧接着的几个 token 就开始作用,约束后续的词序和搭配结构。语义转折维度的能量延迟到"但是"出现的位置才集中释放。而语体维度的能量则可能弥散在整个后续序列中,以微弱但持续的方式影响着每一个 token 的选择。
放到全景来看就是这样的画面:假设一个序列有 100 个 token,每个 token 各自携带着多维度的能量。在任意一个生成时刻,新 token 承受的合力是所有前序 token 在各自的不同维度上、以不同强度、在这个特定时刻释放的力的总和。某个 token 在某个维度上的能量释放完毕后,它并没有"耗尽",而是在其他维度上的能量仍然储存着,等待后续合适的时刻再释放。
而且还有更深一层的结构:模型有 96 层甚至更多,每一层都有独立的一组注意力头。同一个 token、同一个维度的能量,在不同层可能以不同的方式被读取,浅层处理局部的句法搭配,深层处理跨句的逻辑和语义关系。所以能量的释放不仅在序列的时间轴上有先后分布,在模型深度的轴上也有分层结构。
整个 Token 生成动力学的画面,因此不是一个简单的"释放—耗尽"的线性过程,而是一个高维的、多通道的、在时间轴和深度轴上同时展开的能量释放网络。每一个 token 的产生,都是这个网络在当前时刻的一次集体作用的结果。
目标在哪里?
理解了 Token 生成动力学之后,"目标在哪里"这个问题就不再神秘了。
目标就储存在给定的初始上文中。当你输入一个问题,这些 token 携带的能量就已经编码了"应该产出一个什么类型、什么方向的回答"这一信息。生成过程就是这些能量沿时间轴逐步释放、转化为具体文本的过程。没有一个外在的终点在等待,目标是内禀于初始条件的。
而从上帝视角——不考虑过程,直接审视终局——整条轨迹在系统启动的那一刻就已经被唯一确定了。力的传递规则(模型参数)和初始状态(输入 token 和随机种子)一旦固定,每一步的合力方向就是确定的,因此每一个 token 的选择也是确定的。整条轨迹是初始条件的确定性演化结果。
但这里需要区分两种"确定"。
确定性、温度与热涨落
模型在每一步的输出并不是直接给出一个 token,而是给出一个概率分布,对词表中每一个可能的 token 各赋予一个概率值。比如在某个位置,"但是"的概率是 0.35,"所以"是 0.25,"而且"是 0.15。
从这个分布中选出最终 token 的方式,取决于一个关键参数:温度(temperature)。
温度为 0 时,系统采用贪心解码,每一步直接选择概率最高的 token,不引入任何随机性。此时系统是完全确定性的:相同的输入跑一万次,产出完全一致的结果。力场完全决定了轨迹,没有任何涨落。
温度大于 0 时,系统按概率分布随机采样,概率较低的 token 也有机会被选中。温度越高,概率分布越平坦,低概率 token 被选中的可能性越大。这等价于在确定性的合力之上叠加了一个随机扰动项——在物理学中,这恰好对应朗之万动力学(Langevin dynamics)的结构:确定性的力加上与温度成正比的随机热涨落。
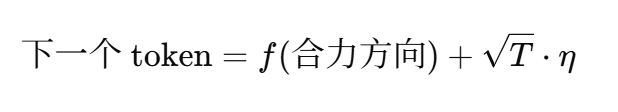
其中 T 是温度,η 是随机噪声。当 T = 0,噪声项消失,轨迹完全由力决定;当 T > 0,每一步都有涨落叠加在力的方向上。
大多数时候,合力足够强,热涨落不影响大方向,就像室温下的台球不会因为空气分子的撞击而偏离轨道。但在合力处于临界平衡的位置,比如"但是"和"所以"的概率几乎相等,两个方向的力势均力敌,微小的涨落就足以决定系统进入哪个分支。一旦进入了某个分支,后续所有 token 承受的力场都随之改变,轨迹可能走向截然不同的终点。
这就是物理学中混沌效应在 Token 生成动力学中的体现:系统是确定性的(给定随机种子),但在临界平衡点附近,对微扰极端敏感。同一个问题多次提问得到不同风格的回答,不是模型出了故障,而是轨迹在临界点附近发生了分岔,不同的热涨落将系统推入了不同的演化路径。
力的链条不可跳过
还有最后一个问题:既然从上帝视角看一切已经确定了,我们能不能不跑完整个生成过程,就提前知道结果?
几乎可以肯定不能。
这涉及 Stephen Wolfram 提出的计算不可约性(computational irreducibility)。他研究了元胞自动机,一排格子按简单规则更新的极简系统,发现对于很多规则,要知道第 N 步的状态,不存在比"把前 N-1 步全部模拟完"更快的方法。系统的演化过程本身就是最短的计算路径。
回到 Token 生成动力学的框架:每个 token 承受的合力取决于前面所有 token 的具体内容。第 100 个 token 的力场由前 99 个 token 共同决定,而第 50 到第 99 个 token 本身也是力的演化结果,你不计算就无从得知。力的链条是严格串行的,不可跳过任何一环。
这种"答案已确定但无法提前获知"的结构并非 Token 生成动力学独有。博弈论中的策梅洛定理证明了,象棋、围棋这类完全信息博弈,从第一步落子起结局就已注定。但这只是存在性证明——没有人能不下完棋就知道结局,因为可能的棋局数约为 10^120,穷举在物理上不可实现。
答案的存在性和答案的可获取性,是两个本质不同的命题。
· · ·
结语
回到最初的问题:一个一次只输出一个字的系统,怎么能生成完整、连贯、有意义的内容?
Token 生成动力学给出的回答是:完整的含义从一开始就以能量的形式编码在上文的 token 之中。生成过程是这些能量沿时间轴的有序释放,每一步,已有 token 中的能量对新 token 施加合力,决定它的产生;新 token 落定后又携带新的能量加入系统,参与决定下一步的演化。
这种能量释放不是一次性的倾泻,而是一个精细的、多维度的、自带时间结构的过程。每个 token 在不同维度上携带的能量在不同时刻释放,有的即时兑现,有的延迟到遥远的未来才发挥作用。含义不会跑偏,正是因为这张能量释放的网络在持续地约束着轨迹。目标不在远方,而是内禀于初始条件,随着力的链条逐环展开而显现。
从上帝视角看,一切在起点就已确定。但计算不可约性告诉我们,这条力的链条不可跳过,你必须让系统一步步演化完,才能看到终局。
这或许就是大模型生成内容最本质的图景:
含义以能量的形式储存在上文之中,通过力的逐步传递释放为文本。答案从一开始就在那里,只是需要力的链条一环一环地展开,才能将它揭晓。
· · ·
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,群里大家都在真搞。