大模型的原理完美诠释了什么是"道可道,非常道"
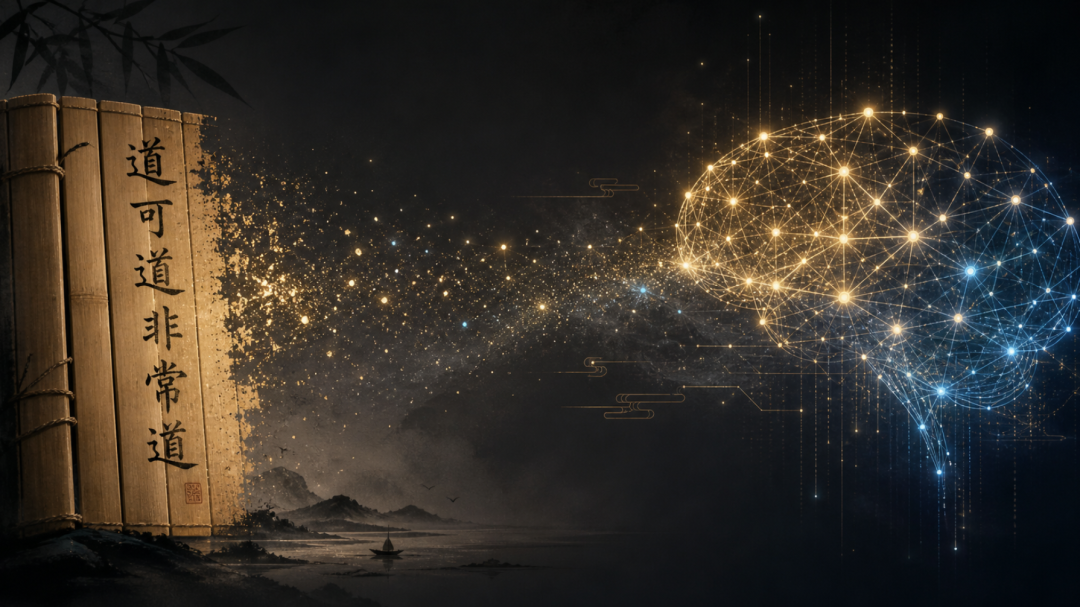
大模型的全部家当,就是一张几万词的字典加上千亿个小数。这个结构跟两千年前老子说的那句话,对得上。
· · ·
大模型里有"字"吗?
大模型的参数都是数字,那它到底认不认识汉字?
这个问题看起来简单,但真追问下去,会把你带到一个很有意思的地方。
我们都知道大模型本质上是一堆权重——千亿量级的浮点数,组成一个巨大的神经网络。这就是它的全部"脑子"。但问题来了:你问它"唐朝第一个皇帝是谁",它答"李渊"——这两个方块字不可能凭空从一堆零点几里蹦出来吧?
答案是:大模型里确实有文字。
下载一个开源模型,你会在文件里找到一个相对很小的文件,通常叫 tokenizer.json。打开它,里面一行行列着真实的文字片段:"的""是""李""渊""hello""the"……几万个,每个旁边标着一个编号。
这张表就是大模型跟人类文字之间唯一的接口。没有它,那千亿个权重就是一堆哑巴方程式。
所以大模型的完整构成是三样东西:一张词表(Vocabulary),一个嵌入矩阵(Embedding Matrix),加上中间几十层到上百层的Transformer网络权重。平时大家说"模型就是一堆参数",这话没错——嵌入矩阵本身也是参数,词表相对于千亿参数来说只是一个小配置文件。但这个小文件不可或缺。
· · ·
从汉字到向量,再从向量到汉字
明白了结构之后,大模型处理语言的过程就清晰了。以"唐朝第一个皇帝是谁"为例:
Tokenization: 句子先被切分成token,通过词表映射成编号序列。"唐"对应编号5012,"朝"对应3891。到这一步,汉字已经变成了一串整数。
Embedding: 每个编号去嵌入矩阵中取出对应的一行,得到一个高维向量(通常几千维)。这个向量就是该token在语义空间中的坐标——"唐"不再是一个Unicode字符,而是几千维空间中的一个点。
Transformer层层运算: 向量进入几十层甚至上百层的Transformer网络,每一层做矩阵乘法、自注意力计算(Self-Attention)和非线性激活。每过一层,每个位置的向量都融合来自其他位置的上下文信息。到最后,"皇帝"这个位置的向量已经不只是"皇帝"本身的语义了,它编码了"唐朝+第一个+皇帝+疑问"整个上下文。
解码输出: 最后一层输出的向量跟嵌入矩阵中所有token的向量计算相似度,得到概率分布,概率最高的token被选中——"李"。然后模型把"李"追加到输入序列末尾,再跑一轮,输出"渊"。
完整链路:汉字 → 词表查编号 → 嵌入矩阵取向量 → Transformer层层运算 → 输出向量 → 比对嵌入矩阵 → 词表查回汉字。入口和出口是文字,中间全是线性代数。
· · ·
"李渊"到底存在哪里?
这是整篇文章最值得停下来想一想的问题。
"李渊"作为一个知识,不在任何一个具体的参数里。它分布式地编码在大量参数的协作模式中。"李渊"的嵌入向量跟"唐朝""开国""皇帝""618年"的向量之间,通过中间那些Transformer层的权重矩阵,形成了一张复杂的关联网络。没有人编过一行代码写入这条知识——模型只是在训练过程中读了大量文本,通过梯度下降自动调整权重,自己把这层关系"长"了出来。
你没法打开权重文件,指着某个数字说"这就是李渊"。但当特定的输入模式流过这张网络时,正确的输出就浮现了。
知识真实存在,确实起作用,但你无法将它定位、隔离、展示。
想到这里,我脑子里开始浮现一句话。
· · ·
道可道,非常道
《道德经》开篇:"道可道,非常道;名可名,非常名。"
真正的本质一旦被说出来就不是它了,事物一旦被命名,名字就不等于事物本身。
大模型的结构,恰好把这句话变成了一个可以拆开看的工程实物。
词表里的"李""渊""唐""皇帝"——这些就是名。符号,标签,人类发明出来用于指代事物的记号。而那千亿个权重参数组成的网络——那个你打开只能看到一片数字,完全无法直接阅读,但确确实实"理解"了语言的东西——那就是道。
名和道缺一不可。没有词表,千亿权重虽然存在,却无法跟人类语言对接——道虽在,却无从"道"。但名本身不包含任何知识,"李渊"就是字典里的两个编号,全部的意义都来自背后那张说不清道不明的权重网络。名不是道,但没有名就无法言道。
更妙的是,模型内部的向量空间是连续的。在那个几千维的空间里,"李渊"和"李世民"之间不是非此即彼,而是一片渐变地带。"皇帝"和"帝王"之间也没有截然的分界。概念与概念融在一起,浑然一体——这就是道的状态。
但模型一旦要输出,就必须从词表里选一个离散的token。连续的、丰富的内部状态,被压缩成一个符号。
每一次输出,都是一次从道到名的降维。
老子的洞察正在于此:世界的本质是浑然一体的,但人为了交流,不得不把它切碎、贴标签。每一次命名,都是一次有损压缩。大模型每吐出一个字,也是如此。
· · ·
无名天地之始,有名万物之母
道德经紧接着还有一句,也对得上。
大模型训练之前,所有权重是随机初始化的——毫无意义,一团混沌。这就是"无名"的状态,天地未开。
然后训练开始。几万亿字的文本灌进去,模型反复看,反复调整权重,逐渐学会将输入模式与输出对应起来。"唐朝第一个皇帝"开始跟"李渊"挂上钩,"E=mc²"开始跟"爱因斯坦"关联。混沌中生出秩序,无名中生出万物。
而且没有人设计这些知识。没有工程师写过 if question == "唐朝第一个皇帝" then return "李渊"。权重自行调整,知识自然涌现。
道法自然。它就是这样自己如此的。
· · ·
你自己的大脑呢?
这些对应关系成立,也许有一个更深层的原因——人类大脑本来就是同构的。
你的大脑也是神经元和突触连接。说穿了,也是"权重"。你脑子里同样没有任何一个位置刻着"李渊"两个字。你对李渊的了解,也是分布式地编码在大量神经连接的模式中——你没法打开自己的大脑,指着某个区域说"看,李渊在这儿"。
当你要开口说话的时候,你做的事情跟大模型一样:把脑中那个连续的、分布式的、无法直接展示的内部状态,压缩成几个离散的汉字符号输出。
你以为自己在用语言思考。但也许,语言只是思维的输出接口。真正的认知发生在更深处——一个你自己都无法直接观察的连续神经活动层面。你能感觉到自己"懂"了一件事,但让你描述"懂"本身是什么,你只能再次把它翻译成语言。
又是一次有损压缩。
老子大概意识到了这件事,所以他在开篇第一句就坦白了:我接下来说的所有关于"道"的话,说出来的那一刻就已经不是道本身了。
两千年前能有这份自觉,了不起。
· · ·
写在最后
大模型用工程的方式,把一个古老的哲学洞察做成了可以拆开查看的实物。千亿个权重是道——真实运作,不可言说。几万个token是名——清晰可见,只是接口。
两者之间那条边界,就是道与名的边界。
我们每个人也活在这条边界上。一辈子用名去逼近道,用语言去触碰语言够不到的东西。明知永远差那么一点,但就是忍不住要试。
两千年前老子试了。今天大模型也在试。
你正在读的这篇文章,也是一次尝试。
· · ·
转发给一个你觉得聊得来的人。有些话题值得找个人坐下来好好说说。
我建了一个AI学习群,目前十几个人,都是在真正动手学AI的人。如果你也在自己跑模型、写代码、做项目,欢迎加我微信,备注"你在做的AI方向",我拉你进群。纯围观的就不加了,群里大家都在真搞。