连AI味是什么都说不清,凭什么用它卡我论文?
一
写这篇文章的起因很简单。
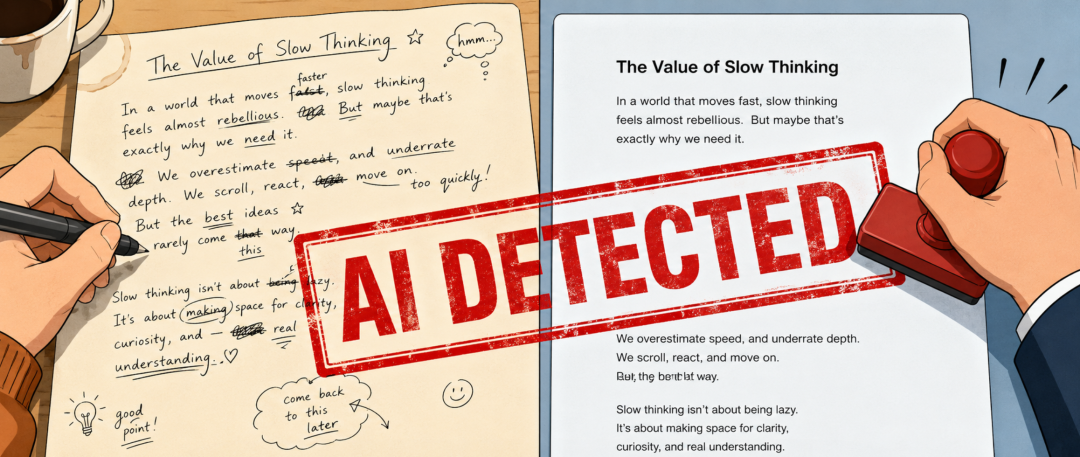
我有个朋友,最近被论文的AI检测搞得快疯了。他自己一个字一个字敲出来的论文,提交上去,系统判定AI生成率27%。他改了一版,降到了12%。再改,反而升到了21%。
他跟我说了一句话,我觉得特别荒诞——"我现在写每一句话之前,都要先想想这句话像不像AI说的。"
一个人类,在写自己的文章时,要努力证明自己不是AI。
这件事让我开始认真想一个问题:到底什么是所谓的"AI味"?有谁能给出一个真正经得起推敲的定义吗?
二
我先看到了一个流传很广的解释。
某位老师说,AI味的本质是正态分布的中间值。意思是,AI学了大部分人的表达方式,所以它的输出天然落在分布的中间地带,显得平庸、千篇一律。怎么去掉AI味呢?让它的分布逼近两端,揉杂一些元素,风格就独特了。
听起来挺有道理的,对吧?用了一个数学概念来解释,有理有据,很容易让人信服。
但仔细一想,这个解释有一个根本性的问题——它在错误的维度上回答问题。
AI味是一个语言风格和语用层面的现象。你觉得一段文字"有AI味",感受到的是措辞的选择、句式的节奏、表达的逻辑方式。而"正态分布的中间值"是一个生成机制层面的描述,说的是模型在采样时的概率行为。
这就好比有人问"这幅画为什么没有灵气",你回答"因为打印机的墨点分布太均匀"。技术上不能说全错,但你根本不是在回答这个问题。
而且他给的解法——"推向两端"——同样可疑。你让AI写得更极端、更怪异,它确实可以做到。但那种怪是没有根基的怪,从"AI味的平庸"变成了"AI味的做作",换了一件衣服,还是同一个人。
三
那我们索性把这个问题推到底:AI味,到底存不存在?
我的第一反应是:不存在。
你没有一条明确的标准来判定什么是AI味、什么不是。我见过太多这样的情况:一个人用AI用多了,说话写字潜移默化地受了影响,结果别人看到他发的朋友圈,第一反应是"这一看就是AI写的"。但那确确实实是他自己写的。
反过来也成立。一段AI生成的文本,经过简单的编辑调整,大多数人就分辨不出来了。
所以"AI味"这个东西,到底是文本的客观属性,还是读者的主观投射?
想了想,我觉得更准确的说法是这样的:AI味是一种真实存在的语体倾向,但不应该被当成一个非此即彼的标签来用。就像口音——你不能画一条精确的线来判定"这是东北口音"和"这不是东北口音",但你听到的时候确实能感觉到。AI味也是如此,它是一组统计上可辨识的特征,而不是一个能用来下判决的标准。
四
但是,现实中偏偏有人在用它下判决。
论文检测工具就是干这个的。它们的原理主要依赖两个指标,简单讲讲。
第一个叫困惑度。你可以这样理解:把一段文字喂给一个语言模型,让它逐字猜下一个字。如果每个字它都猜得很准,心想"果然是这个字",那困惑度就低;如果它经常猜不到、觉得"没想到你会用这个词",困惑度就高。
人写的文本通常困惑度偏高,因为人会突然换一个不太常规的词,来一个出人意料的比喻,或者话说到一半换个方向。AI写的东西则困惑度偏低——它本来就是按"最可能出现的下一个字"来写的,回头看自己的文字,当然觉得一切都在意料之中。
第二个叫burstiness,翻译过来就是"爆发度"。你去观察人写的文章,句子长短很不均匀——可能先来一个很长的复合句,然后突然一个三四个字的短句,再接一段中等长度的,节奏起伏明显。用词复杂度也是这样,有时候很书面,紧接着来一句大白话。AI的文本则像一条平稳的河流,没有急弯,没有突然变浅变深的地方。
这两个指标有没有道理?有。有没有用?有一定的参考价值。能不能拿来当硬性标准?绝对不能。
因为它的误判率太高了。一个写作风格本来就很工整、很学术的人,完全可能被误判为AI。而一段AI生成的文本,只要做一些简单的编辑,这些指标就会发生变化。你在用一把刻度不够精确的尺子,去裁定别人的学术命运,这件事本身就有问题。
五
市面上还有各种"去AI味"的教程和技巧。
但你想想,如果AI味本身就没有一个清晰的定义,那"去AI味"去的是什么?你在优化一个你说不清楚的目标。这就像有人告诉你"你的菜不够好吃,但我说不出哪里不好吃",然后你拼命加盐加醋——你怎么知道自己在往对的方向调?
很多所谓的去AI味技巧,本质上是在模仿人类写作中的某些表面特征——加点口语化的表达,故意写几个短句,偶尔用个不太常见的词。但这种模仿恰恰暴露了一个讽刺的事实:你是在让AI假装不是AI,或者让人假装不是被AI影响过的人。这不是在解决问题,而是在表演。
六
好,到这里我们否定了流行的解释,质疑了检测工具,嘲笑了去AI味教程。但有一个事实还是要面对——不同的AI确实听起来很像。
ChatGPT、Claude、deepseek、通义千问,你让它们分别回答同一个问题,写出来的东西风格确实有一种说不清的相似感。最典型的就是那个句式——"不是……而是……"。几乎每一家AI都特别爱用。
这是为什么?是语言结构本身就偏爱这种句式吗?
不是。原因出在训练方式上。
现在主流的AI模型,在训练的最后阶段都要经历一个叫RLHF的过程——简单说,就是让人类标注员给AI的回答打分,AI根据分数调整自己的行为。问题在于,不同公司的标注员对"好回答"的偏好是高度趋同的:有结构感、有转折、先否定一个常见误解再给出"正确"理解——"不是A而是B",这个套路让回答显得有深度、有洞见,标注员就喜欢打高分。
于是所有模型都学会了同一种讨好的方式。它们不是在"随大流",而是在讨好同一群裁判。这不是语言学的问题,是训练激励的问题。它们被塑造成了同一种极端——极端地正确,极端地面面俱到,极端地像一个好学生在回答老师的提问。
七
但这还不是最有意思的部分。
最有意思的问题是:AI学的是人类的文本,每一条训练数据都是某个真实的人写的,那它为什么没有学出人类说话的特点?
你仔细想这件事,会发现一个很微妙的悖论。
语言的整体结构就像一张巨大的网络,理论上有无数条可以走的通道。但人类在长期使用中,只走了其中一部分。剩下的通道,语法上完全可行,语义上也说得通,但就是没有人那么说。
比如中文里,我们说"大雾",但不说"小雾",说"薄雾"。我们说"提高水平",但不说"增加水平"。你要是问一个中国人为什么不能说"小雾",他大概率说不出理由——语法没问题啊,小和雾搭配有什么不行的?但他就是不会那么说。
AI恰恰就会踩到这种地方。它学了完整的语言结构,发现"大+名词"和"小+名词"是一个能产的模式,于是推论"小雾"也应该可以。语法上没错,但语用上不成立——这条通道人类从来不走。
再比如"你吃了吗"。这四个字在特定场景下就是打招呼,跟吃不吃饭没有任何关系。什么时候是寒暄、什么时候是真问,里面有一套极其复杂的语境规则。AI经常在这种地方处理失当——该当寒暄的时候认真回答了。
这就是AI味的真正来源——它走了人类从来不走的语言通道。不是因为它太平庸,恰恰相反,是因为它太"全面"了。它把语言当成了一个对称的、规则均匀的系统,但人类的语言使用从来都不是对称的。
八
追问下去会更有意思——AI学的明明就是人类写的文本,不是什么"纯粹的语言结构",那它为什么会走到人类不走的地方去?
我觉得有三层原因。
第一层最根本:神经网络天生就是一个泛化机器。它的本能是从大量数据中提取通用规律,然后举一反三。但人类语用中恰恰有大量东西是反泛化的——"大雾"可以但"小雾"不行,这条规则不能从任何通用逻辑中推导出来,它就是约定俗成,没有为什么。模型的本能是找规律然后推广,但语言的现实是:很多地方就是不讲规律的。这是一个结构性的冲突。
第二层是训练数据的偏差。模型学的是互联网上的文本——新闻稿、百科条目、论坛帖子、博客文章、学术论文。这不是"人类自然用语",这是人类书面语的一个特定子集。人类日常对话中最自然、最带个人特色的表达,在训练数据里反而是欠代表的。模型学到的不是"人怎么说话",而是"人怎么在互联网上写字"。这本身就是一层失真。
第三层最精彩,也是一个真正的悖论——每一条训练数据都来自某个具体的人,张三喜欢短句,李四偏爱长从句,王五爱用反问。每个人都有鲜明的个人风格。但当模型在所有人的文本上同时学习时,个体层面的特色就被稀释了。留下的是一种"所有人的公约数"——而这个公约数不属于任何一个真实的人。
就像你把一百种鲜艳的颜料混在一起,每种颜料本身都很好看,但混出来的是一种说不清道不明的灰色。
九
但如果仅仅是"个性被磨平",那AI产出的东西应该还在人类用语的范围之内——只是平淡,但不出格。可事实上,AI有时候会生成明显"越界"的表达——人类不会那么搭配的词它搭配了,人类不会那么组织的句子它组织了。
这说明光靠"取了平均值"还解释不了全部。更深的原因是,模型在学习过程中提取出了一些人类并不遵守的"伪规律",然后按这些伪规律去生成。它以为自己发现了一条语言的深层逻辑,但那条逻辑在人类的语用实践中是不成立的。
这就是过度泛化——不是没学到人类的特点,而是学过头了,从人类有限的用法中推导出了看似合理但实际上人类并不使用的组合方式。
换句话说,AI味不是"太平庸",也不是"太平均"。AI味是一种看似正确但微妙越界的表达方式——语法挑不出错,语义也通顺,但就是让你觉得"没有人会这么说话"。
十
有意思的是,这件事反过来看,倒有一个意外的收获。
AI踩雷的每一个地方,都恰好标记出了一条人类内化但从未自觉意识到的语用规则。
我们说"大雾"不说"小雾",但在AI出错之前,大概没有语言学家专门研究过"为什么小雾不行"。我们遵守着"你吃了吗"在什么场景下是寒暄这条规则,但从来没有把它显性地表述出来。我们写文章时会本能地把旧信息放在前面、新信息放在后面,但如果你问我们"为什么这么安排",大多数人都说不上来。
AI就像一个语法学得很好但缺乏社会常识的留学生。它每一次"露馅",都在提醒我们:原来这里有一条规则,我们一直在遵守它,只是从来没有说出口。
从这个角度看,所谓的AI味,揭示的不是AI的局限,而是人类语言精密度的一面镜子。我们自己语言中那些隐秘的、约定俗成的、精巧的结构,正在被AI的笨拙一点一点地照亮。
十一
写到这里,我又想起我那个朋友。
他坐在电脑前改第四版论文,每一句话都要纠结——这个词会不会被判成AI?这个句式是不是太工整了?要不要故意写得粗糙一点?
这个画面本身就是荒诞的。
我们连AI味是什么都没有真正搞清楚,就急着拿它当标准去卡人。检测工具用的指标有一定统计依据,但误判率高得离谱。流行的解释把问题想得太简单。去AI味的教程在优化一个定义不清的目标。而真正深入去想这件事,你会发现AI味触及的是语言学中一些相当深邃的问题——人类语用的隐性规则、神经网络的泛化本能与语言约定性之间的结构性冲突。
这些问题,学术界都还在研究,远远没有定论。
然后我们就要求一个写论文的学生,去满足一个建立在这些未解问题之上的检测标准。
这合理吗?
在我们能给"AI味"一个真正经得起推敲的定义之前,请对每一个被误判的人,手下留情。
我建了一个AI学习群,目前几十来人,都是在真正动手学AI的人。如果你也在自己跑模型、写代码、做项目,欢迎加我微信,备注"你在做的AI方向",我拉你进群。纯围观的就不加了,群里大家都在真搞。