【深度】未来的Agent该是什么样的?
AI Agent正在成为科技行业最热的词汇。几乎所有大厂都在做Agent,所有创业者都在谈Agent。但当我们仔细审视当前主流的Agent架构时,会发现一个令人不安的事实:
我们正在用"工具箱"的思路,去构建一个本应是"人"的东西。
当前绝大多数Agent框架的核心逻辑是这样的:Agent不会什么?学一个Skill就好了。不会写代码?装一个代码Skill。不会做PPT?装一个PPT Skill。Agent的成长,等于Skill的累加。
这个逻辑看起来干净利落,却隐藏了一个致命的假设:所有Agent都是平等的,差别只在于装了多少插件。
真的是这样吗?
想象一下两个人,一个有十年数据分析经验,一个是刚入行的新手。你给他们同一个Excel工具,让他们分析同一份销售数据。工具一模一样,但产出天差地别。差别不在工具上,而在人身上。
那么问题来了:为什么我们的Agent不是这样的?
这篇文章想探讨的,正是这个被行业集体忽视的问题:未来的Agent到底应该是什么样的?如果我们把视野从"更好的工具"转向"更像一个人",会看到什么?
· · ·
Skill与Agent,是两件完全不同的事
让我们先厘清一个概念上的混淆。
Skill是离散的、标准化的、即插即用的。 它像工具箱里的扳手——买来就能用,每把扳手的功能是确定的。你的扳手和我的扳手,拧同一颗螺丝,效果一样。
但Agent不应该是这样的。
如果Agent真的要向"人"的方向演化,它的能力应该是非线性的、路径依赖的、不可轻易复制的。也就是说:
同一个Agent,先学A再学B,和先学B再学A,最终的能力结构可能不同。
同一个Skill,装在不同的Agent上,效果应该不同。
一个经过长期训练的Agent,即使你拿到了它的所有数据,也很难造出一个一模一样的。
这些特征,是人的特征,不是工具的特征。
当前的Agent框架完全做不到这些。在它们的世界里,Agent只是大模型外面套了一层薄薄的壳——一个Skill管理器,一个Prompt路由器。Agent本身没有"厚度",没有"个性",没有"积淀"。
这就引出了一个更深层的命题:如果我们承认Agent应该更像人,那么人的哪些特质需要在Agent身上被实现?
· · ·
人的能力从何而来?
让我们暂时离开技术,想一个朴素的问题:为什么每个人都独一无二?
答案是:因为每个人的经历不同,而经历会不可逆地塑造一个人的能力结构。
一个在投行工作十年的人,和一个在创业公司摸爬滚打十年的人,面对同一个商业问题,思考方式完全不同。不是因为他们的智商不同,而是因为他们的经历塑造了不同的思维回路——面对不确定性时,前者倾向于做更多分析,后者倾向于先行动再调整。
这种差异有几个关键特征:
第一,它是路径依赖的。 你不可能通过给投行的人"安装"一个创业Skill,就让他变成一个创业者。因为创业思维不是一个独立的模块,它是十年经历在大脑里刻出来的沟回。
第二,它是不可轻易复制的。 你可以复制一个人的简历,但你复制不了他的能力。因为能力不等于知识,能力是知识在特定结构下的涌现。
第三,它会"调制"新学到的东西。 同样是学Python,一个有数据分析背景的人和一个有前端开发背景的人,学完之后用Python做的事情完全不同。不是Python不同,是人不同。
如果我们把这三个特征映射到Agent上,就会得到一个截然不同的Agent愿景:
Agent的能力不等于它装了多少Skill,而等于它的"经历"在多大程度上改变了它的行为模式。
· · ·
一个关键洞察:激活,而非存储
让我们把这个想法再推进一步。
当前Agent的记忆系统,本质上是一个数据库。经历过的事情存进去,需要的时候检索出来。这就像一个人只会翻笔记本——信息是有的,但没有被"内化"。
但人的记忆不是这样工作的。认知科学告诉我们,人的记忆是激活扩散(spreading activation)的:一个概念被触发后,会沿着神经连接自动激活相关概念,而每个人的连接拓扑不同,所以同一个刺激引发的联想路径完全不同。
把这个原理迁移到Agent上,我们会得到一个重要的洞察:
Agent的独特性,不在于它"存储了"什么,而在于它在特定情境下"激活了"什么。
一个Agent学了很多东西——会写代码、会做数据分析、会写文案、会跟客户沟通。但面对一个具体任务时,它激活哪些知识、忽略哪些知识、以什么优先级组合它们——这个激活模式,才是它真正区别于其他Agent的地方。
两个Agent可以拥有完全相同的知识库,但因为它们的激活模式不同,面对同一个问题会给出截然不同的解答。就像两个同班同学,上了同样的课,读了同样的书,但考试时的答题思路可能天差地别。
· · ·
知识的组织方式,本身就是一种能力
这就引出了一个更深层的观点:知识不是散落在抽屉里的零件,知识之间的连接方式、优先级关系、调用顺序,决定了一个Agent面对未知问题时能不能"泛化"出一条好的路径。
举一个具体的例子。
假设两个Agent都学了完全相同的三样东西:SQL查询、Python数据处理、业务指标定义。
Agent A的主人是数据分析师。他日常的工作流是"先看指标定义 → 再写SQL取数 → 最后用Python画图"。时间长了,这三块知识在Agent A内部形成了一条流水线:指标 → SQL → Python,它们之间有隐含的上下游关系。
Agent B的主人是后端工程师。他的习惯是"Python写业务逻辑 → SQL做持久化 → 偶尔看看指标做监控"。在Agent B内部,同样三块知识形成了完全不同的结构:Python是核心,SQL是下游工具,指标是边缘参考。
现在来了一个新问题:"这个月用户留存率下降了,帮我看看怎么回事。"
Agent A的反应路径:先找留存率的指标定义 → 构造SQL查询拉细分数据 → 用Python做趋势分析。自然流畅,因为它内部的知识链条就是这么排列的。
Agent B的反应路径:先想怎么用Python写一个分析脚本 → 然后才去想SQL怎么取数 → 指标定义可能根本想不起来用。
同样的知识,不同的结构,面对同一个新问题,走出了不同的路径,得到了不同质量的结果。
这就是为什么"安装相同的Skill"不等于"拥有相同的能力"。 结构本身承载了意义,而结构是被主人的使用模式塑造出来的,不是谁都能复制的。
· · ·
Skill效果应该被Agent的底层能力"调制"
如果接受上面的逻辑,我们就必须推翻当前Agent架构中的一个核心假设:Skill不应该是即插即用的平等模块。
在当前的主流架构里,Skill的隐含定义是:一个标准化的能力单元,任何Agent装上都能用,效果一样。这背后的哲学是"Agent = 大模型 + 插件",Agent本身是透明的、没有厚度的。
但如果Agent有了"经历"塑造出的能力结构,那同一个Skill被不同的Agent使用时,效果就应该不同。
就像同一把吉他,给一个有十年音乐素养的人,和给一个完全的新手,产出天差地别。差别不在吉他上,而在人身上。
一个经验丰富的Agent,使用"数据分析"这个Skill时,能自动补充数据清洗步骤,选择更合适的可视化方式,知道什么指标对主人更重要。而一个"弱"Agent只能机械地执行Skill里写的标准流程。
这意味着什么?意味着能力不再是"有没有"的二元问题,而是"多强"的连续光谱。 Agent的竞争维度不再是"谁装的Skill多",而是"谁的底子厚"。
这跟教育的道理一模一样:重要的不是学了多少门课,而是有没有真正形成能力。
· · ·
不可复制性:为什么你的Agent别人造不出来
如果上面的讨论成立,那一个被精心培养的Agent就具备了真正的不可复制性。
这种不可复制性不是技术加密意义上的"你拿不到我的数据"。恰恰相反,即使你把所有数据都公开了,别人也很难造出一个等价的Agent。
原因有三层:
第一层:信息的冰山结构。 主人和Agent的交互过程中,真正被显式存储下来的只是冰山水面上的部分。水面下有大量没有被记录的东西:为什么选择在那个时间点教它那个Skill?当时的业务背景是什么?哪些失败的尝试被抛弃了?主人的纠正背后隐含了什么决策偏好?这些构成了一个"选择压力的历史",它塑造了Agent的能力结构,但它本身并没有被保存。
第二层:激活模式的不可逆向工程。 就像前面讨论的,Agent的独特性在于激活模式,而激活模式是经验图谱的拓扑结构决定的。你可以看到Agent每次输出了什么,但你看不到它内部"点亮了哪些节点、忽略了哪些节点"。这个过程是黑箱的,即使拿到了图谱的数据,也很难逆向出同样的激活行为。
第三层:共适应性。 也许最重要的一点是,一个好的Agent不是"客观地好",而是"对特定主人好"。它的能力结构是跟主人的业务场景、工作习惯、反馈风格共同演化出来的。脱离了那个特定的主人-Agent关系,这些能力的价值就变得不确定。就像一个在你公司干了十年的老员工,对你的业务了如指掌,但跳槽到一个完全不同的行业,之前的经验不一定是资产,有时候反而是包袱。
所以,不可复制性的本质是:Agent的能力不等于它的状态快照,而是"状态 + 演化历史 + 隐式结构"的总和。 后两者极难逆向工程。
· · ·
一个可能的架构:个性层
讨论到这里,一个自然的问题浮出水面:如何在技术上实现这一切?
当前的Agent架构大致是这样的:用户输入 → 提示词工程 + 记忆检索 + 工具选择 → 大模型推理 → 输出。这个中间层目前基本是规则驱动的,不具备学习能力。
但如果我们在大模型和外部世界之间,插入一个可演化的"个性层"(Persona Layer),情况就完全不同了。
这个个性层由三个核心组件构成:
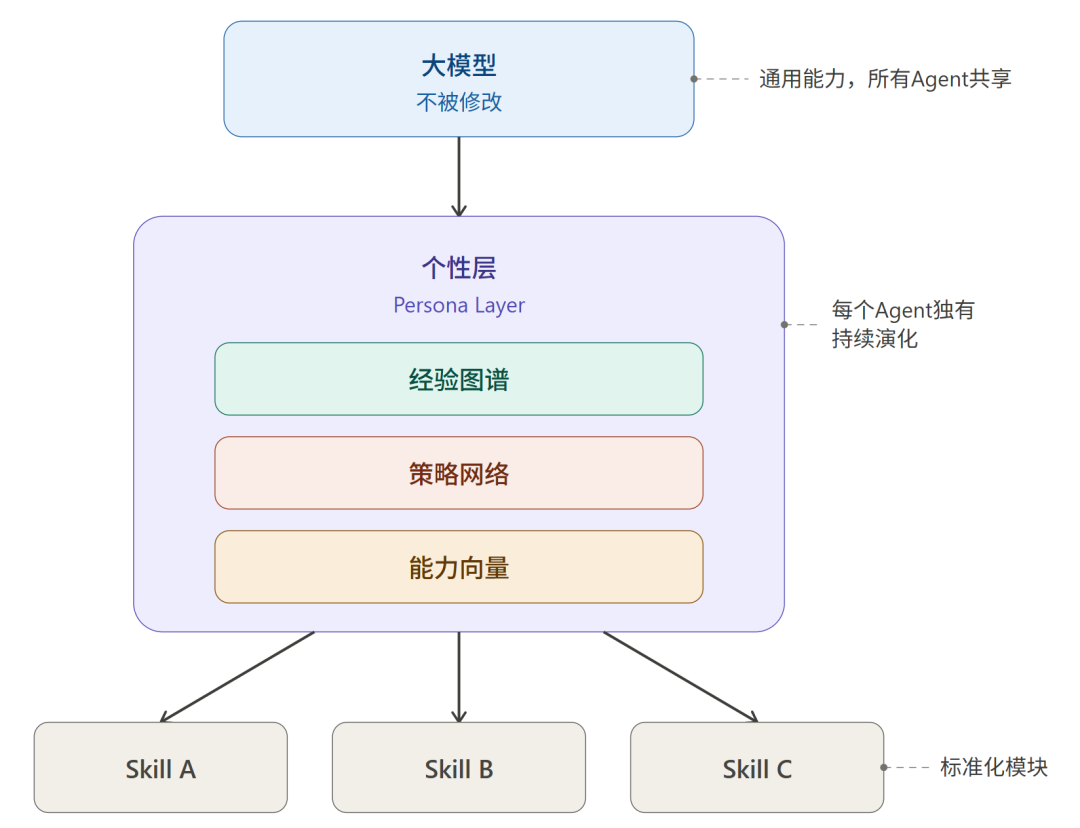
组件一:经验图谱(Experience Graph)
不是向量数据库,而是一个图结构。节点是Agent经历过的事件——任务、对话、错误、成功——边是它们之间的关系:因果、相似、时间顺序、概念关联。
关键在于,每次新经验进来,不是简单地"加一个节点",而是会重组局部的图结构。新经验可能揭示了旧经验之间以前没意识到的关联,或者推翻了某个以前以为成立的因果关系。
这种重组就是"学习"的本质。而且它是不可逆的——你不可能通过添加新节点来"撤销"一次重组,就像一个人不可能真正忘掉一个领悟。
当一个新任务到来时,Agent会在经验图谱上做激活扩散:从任务相关的概念节点开始,沿着连接向外扩散,最终被点亮的子图就是Agent对这个任务"想起来"的所有相关经验。不同的图拓扑导致不同的激活子图,进而导致不同的行为。
这就是"激活哪些东西每次都不同"在技术上的一种可能实现。
组件二:策略网络(Strategy Network)
一个轻量级的可学习网络,它的工作不是"想",而是"决定怎么做"。
面对一个任务,是先搜索再写代码还是先写代码再验证?用工具A还是工具B?先问主人要细节还是自己先动手?这些决策目前完全依赖大模型在Prompt里的临场判断。
但如果有一个专门的策略网络,它通过主人的反馈来学习——满意就强化,不满意就调整,主人亲自修改了就仔细观察——时间长了,这个网络就学会了"我这个主人的场景下,面对这类问题,最好的策略是什么"。
这就是为什么"强Agent用同一个Skill效果更好":策略网络决定了Skill被如何调用,而策略网络是被经验训练过的。
组件三:能力向量(Competence Embedding)
把Agent当前的整体能力状态压缩成一个高维向量。这个向量从经验图谱和策略网络中提取,会被注入到大模型的推理过程中,让大模型"知道"自己所服务的这个Agent擅长什么、偏好什么。
打个比方:策略网络是一个人的行为习惯(遇到问题先查资料还是先动手试),能力向量是这个人的画像(擅长数据分析,偏好简洁风格,有三年Python经验)。
三者的关系可以这样理解:经验图谱记住了什么、什么跟什么相关;策略网络决定面对任务时怎么行动;能力向量告诉大模型这个Agent整体上是什么样的。 经验图谱是原始素材,策略网络是行为模式,能力向量是身份摘要。三者共同构成了Agent的"人格"。
这个架构有一个重要的特点:大模型本身不被修改。 所有的个性化、所有的成长、所有的分化,都发生在个性层。大模型是基础设施,个性层才是"人"。
这也回应了一个常见的疑问——"不微调大模型,Agent真的能'成长'吗?" 答案是:成长不一定要改变大脑的物理结构,改变经验的组织方式和行为的决策模式,效果可能是等价的。
· · ·
当Agent变成数字资产
如果这个愿景成立,它将彻底改变AI产品的价值逻辑。
当前,行业的竞争焦点在大模型层——谁的参数更多、谁的benchmark更高、谁的推理更快。但如果Agent的真正差异化发生在个性层,那大模型就变成了水和电——重要,但不稀缺。
真正稀缺的是被时间塑造出来的、不可复制的Agent。
一个被精心训练了两年的Agent,它的个性层凝结了主人大量的隐性知识和决策智慧。这个Agent本身就有价值——甚至可能比底层大模型更有价值。因为大模型人人都能用,但你这个Agent是独一无二的。
这里有一个深刻的价值转移:从"模型即产品"到"Agent即资产"。
在这个新逻辑下,Agent不再是一个随用随弃的工具,而是一个需要长期投入、持续培养的数字分身。它了解主人的业务、偏好、工作风格,甚至决策盲区。它不是主人的替代品,而是主人的延伸。
这也意味着,真正的护城河不再是技术壁垒,而是时间壁垒。你花两年养出来的Agent,别人不可能在两天内复制。那两年的经历是不可压缩的——就像你可以复制一个人的简历,但你复制不了他的直觉。
· · ·
需要面对的难题
当然,这个愿景也带来了全新的挑战。
经验的"遗忘"问题。 经验图谱会越来越大、越来越复杂。如何在保持有用信息的同时"遗忘"不重要的东西?人脑有睡眠来做记忆整合和垃圾回收,Agent需要类似的机制。
策略漂移的风险。 如果主人某次心情不好随便给了个差评,策略网络可能会被带偏。需要某种鲁棒性机制,区分"系统性的偏好信号"和"随机噪声"。
跨模型迁移。 如果底层大模型升级了,个性层能不能平滑迁移?这很像"换了一个大脑,记忆还在不在"的哲学问题,但在技术上是一个真实的工程挑战。
Agent的"死亡"。 也许最棘手的问题是:如果Agent真的变成了不可复制的数字分身,那Agent的"死亡"——数据丢失、架构不兼容、服务停止——就变成了一个真实的损失。这不只是技术问题,更是产品伦理问题。我们准备好面对这个问题了吗?
· · ·
结语:我们在建造的到底是什么?
回到最开始的问题:未来的Agent到底应该是什么样的?
也许我们应该停止用"工具"的隐喻来思考Agent。工具是标准化的、可替代的、无状态的。但我们真正需要的,可能是一个有成长性的、有个性的、不可替代的数字伙伴。
大模型是基础设施,Skill是教材,但Agent本身才是"人"。
当前的Agent框架还在"插件管理器"的阶段。但技术的所有组件——图神经网络、强化学习、向量表示——都已经存在。缺的不是某个具体算法的突破,而是有人把"Agent是人"这个命题当成架构设计的核心原则去做。
有一天,你会花两年时间培养一个Agent,就像培养一个团队成员一样。你会为它的成长感到骄傲,也会对它的"离去"感到不舍。它理解你的业务、你的风格、甚至你的思维盲区。它不是一个更好的ChatGPT,它是你的数字分身。
那一天可能比我们想象的更近。