一文讲透大模型对话的缓存计费机制(高阶版)
一、起因
我在用大模型(主要是 Claude Code)做项目的时候,一直有个问题没想通。
模型在回答问题的时候,一个字一个字往外蹦。这个过程中,前面的对话历史到底在不在被反复计费?我问了 100 个 token 的问题,模型输出了 10000 个 token 的回答,中间我什么都没做。这 10000 个 token 的输出过程中,前面那 100 个 token 的输入费是只收了一次,还是每输出一段就要再收一次?
更进一步:模型在输出到一半的时候,自己调了一次搜索工具。这算什么?算它还在"输出中"不额外收费,还是已经触发了一轮新的计费?
后来我又遇到了一个之前从没注意过的计费类型:缓存写入(cache write)。缓存读取(cache read)我是知道的,就是"服务器记住了你之前发过的内容,下次再发直接复用,只收十分之一的费用"。但缓存写入是什么?写入不就是"把内容存进缓存"吗?这件事为什么要单独收费,而且比普通输入还贵?
这些问题带着我翻了 Anthropic 的官方文档、读了几篇 prompt caching 的工程实践文章、又跟 Claude 对着计费表一行一行地算。搞懂之后发现,之前对大模型计费的很多直觉都是错的。
这篇文章就是把搞懂的过程完整写出来。
说一下和我之前写的《大模型缓存机制完全指南》的关系:那篇讲的是 KV Cache 的底层原理、前缀匹配规则、Claude Code 的请求结构设计。这篇不重复那些内容,聚焦在计费机制本身,尤其是 cache read、cache write、standard input 这三种计费类型的区分,以及工具调用场景下隐藏的计费逻辑。建议先读那篇再读这篇,但不读也不影响理解。
二、先回答那个最直接的问题
在一次 API 请求内部,输入只付一次账。不管输出多长,前面的历史都不会被重复计费。
一次 API 请求分两个阶段。第一个阶段叫 prefill:服务器收到你发过来的全部内容(系统提示、对话历史、新消息),计算所有 input token 的 KV 值,这一步按输入价计费一次。第二个阶段叫 decode:模型基于 prefill 阶段已经算好的 KV 值,逐个 token 生成回答,每个 output token 按输出价计费。
decode 阶段不管生成 100 个 token 还是 10000 个,前面 prefill 阶段处理的那些输入 token 都不会被再次计费。因为它们的 KV 值在 prefill 阶段就已经算好、存在 GPU 显存里了,生成每个新 token 的时候直接从显存读取,不需要重新计算。
所以"什么时候只花输出的钱"的答案很明确:只要还在同一次 API 请求的 decode 阶段内,就只花输出的钱。
那什么时候会重新花输入的钱?
只有当发起一次新的 API 请求时。 这条规则是整篇文章的地基,后面所有内容都是它的推论。
三、什么事件会触发"新的 API 请求"
直觉上,只有用户打字发送新消息才会触发新请求。但实际上有两种情况。
第一种:用户发了新消息。 你在对话框里打了一段话,点发送。客户端把全部对话历史加上你的新消息打包,发出一次新的 API 请求。这个好理解。
第二种:模型调用了工具。
这个不那么直觉。搜索引擎、文件系统、代码执行器,这些工具本身不是大模型,为什么调用它们也算一次 API 请求?
原因在于大模型的 API 是无状态的。模型没有"暂停推理、等工具执行完、再继续推理"的能力。当模型决定要调用一个工具时,它会输出一段特殊格式的内容(tool_call),然后这次推理就结束了。客户端程序收到 tool_call,自己去执行工具,拿到结果后,把工具返回的结果追加到对话历史末尾,向模型发起一次全新的 API 请求。模型在这次新请求中看到了工具结果,才能继续工作。
所以逻辑链条是这样的:不是"调用工具需要走 API",而是"工具执行完之后,让模型看到结果的唯一方式就是发一次新请求"。因为模型是无状态的,它不会在那儿等着。
这意味着什么?
你以为的"一问一答",如果模型在回答过程中调用了 3 次工具,实际上是 4 次 API 请求。每一次请求都把全部对话历史重新发送了一遍。
用 Claude Code 改一个 bug 为例:你提了一个需求(第 1 次请求),模型读了一下文件(返回结果后第 2 次请求),改了文件(返回结果后第 3 次请求),跑了一下测试看结果(返回结果后第 4 次请求),最终给你回复。你只说了一句话,后台发生了 4 次 API 请求,对话历史被重发了 4 次。
这一点对理解计费至关重要:一次对话的实际成本,不只取决于你说了多少和 AI 答了多少,还取决于 AI 在回答过程中调了多少次工具。 工具调用越多,历史被重发的次数越多。
补充一点:会员账号(claude.ai 网页版、Claude Code 订阅)和直接调 API,底层逻辑完全一样。你在网页上打字聊天,后台就是把全部历史打包成 API 请求发给推理服务器。区别只在计费方式:会员是固定月费(有配额上限),API 是按量付费。但 token 消耗的逻辑没有任何不同。
四、每次重发历史时,具体怎么收费
上一章确认了:每次新的 API 请求都会重发全部对话历史。那重发的历史按什么价格收费?
如果每次都按全价,那成本会非常高。实际上不是。这就是 prompt caching 的作用:让重发的历史中,和之前完全相同的部分只收十分之一的费用。
4.1 prompt caching 是什么
一句话:服务器记住你之前发过的输入前缀的 KV 值,下次再发相同的前缀时跳过 KV 计算、直接复用。
很多人之前没有主动接触过这个概念。这是正常的,因为在 Claude Code 和 claude.ai 中,prompt caching 是在后台自动运行的。你不需要开启、不需要配置、完全无感。你每次发消息,系统自动判断哪些部分可以从缓存读取、哪些需要重新计算。
4.2 三种输入计费类型
开了 prompt caching 之后(Claude Code 和 claude.ai 默认就开了),每次请求中的输入 token 会落入三种计费类型之一:
这张表中,cache read 好理解,standard input 也好理解。最容易让人困惑的是 cache write。
4.3 cache write 到底是什么,为什么比 standard input 还贵
standard input 和 cache write 都是"缓存中没有、需要重新计算 KV 值的内容"。区别在于计算完之后:
standard input = 计算 KV 值,用完就扔。下次再遇到同样的内容,还得重新计算。
cache write = 计算 KV 值 + 把结果存进持久化缓存。下次再遇到同样的内容,直接从缓存读取(cache read),只收十分之一的费用。
"存进持久化缓存"这一步有额外成本:需要占持久化存储空间、需要维护哈希索引(用来匹配后续请求的前缀)、需要管理 TTL 计时和缓存淘汰。所以 cache write 比 standard input 贵:5 分钟档贵 25%,1 小时档贵 100%。
那什么时候会出现 standard input 而不是 cache write?当你没有启用 prompt caching 的时候(不传 cache_control 参数),所有输入都按 standard input(1 倍)计费,不写缓存也不读缓存。也就是说缓存不是"天然就存在的",是一个需要启用的功能。
但你在 Claude Code 和 claude.ai 中从来不用操心这件事,因为系统默认替你开了自动缓存。
4.4 自动缓存怎么知道哪些该存、哪些不该存
不是靠"理解内容"来判断,而是靠字节级精确匹配。
每次请求到达服务器时,系统把这次请求的 token 序列和缓存中已有的前缀逐字节比对。完全一致的部分直接复用(cache read),从第一个不同的位置开始往后的部分重新计算并写入缓存(cache write)。
系统还会自动设置一个"缓存断点",放在请求中最后一个可缓存块的末尾。断点前面的所有内容要么 cache read 要么 cache write;断点后面的少量内容(如果有)才是 standard input。在实际使用中,自动缓存模式下几乎所有输入都落在断点前面,standard input 接近于零。
缓存断点在多轮对话中会自动前移。每一轮新请求在末尾追加了新内容,断点跟着移到新末尾。前面不变的部分继续 cache read,新追加的部分 cache write。
(前缀匹配的更多细节在《大模型缓存机制完全指南》中有详细讲解,这里不展开。)
4.5 cache write 的两个 TTL 档位
cache write 有两个档位可选:5 分钟档(写入 1.25 倍)和 1 小时档(写入 2 倍)。读取价格两档完全相同(0.1 倍),差异只在写入成本和缓存的存活时间。
普通用户不需要自己选,也看不到选择入口:
Claude Code 会员订阅:自动使用 1 小时档(2 倍写入)。虽然写入更贵,但缓存存活时间更长,适合 Claude Code 这种可能中间暂停几分钟思考的编码场景。
API key 用户:默认 5 分钟档(1.25 倍写入),更便宜。如果需要 1 小时档,可以通过环境变量 ENABLE_PROMPT_CACHING_1H=1 开启。
claude.ai 网页端:由 Anthropic 内部管理,具体 TTL 策略没有公开文档。
五、上一轮生成的内容,下一轮到底算 cache read 还是 cache write
上一章解释了三种计费类型的区别。这一章追问一个更具体的问题:模型上一轮生成的 10000 个 token 的回答,在你追问时被重发给模型,这 10000 个 token 是按 cache read 计费还是 cache write?
5.1 一个很合理的直觉,但是错的
直觉上,上一轮的回答应该"已经在缓存里了"。毕竟服务器刚刚生成了它,生成过程中每个 token 的 KV 值都已经被计算过、存在 GPU 显存里。直接留着不就行了?
但实际上,这 10000 个 token 的 KV 值不在 prompt cache 里。
原因是 GPU 显存中的 KV 和 prompt cache 中的 KV 是两回事。前者是单次请求的工作内存,请求结束后就释放了(服务器同时服务着成千上万个用户,GPU 显存不可能为每个用户的每次请求都一直保留)。后者是一个跨请求的持久化存储系统,需要显式写入。
要把 output 的 KV 值从 GPU 显存搬到持久化缓存,需要额外的数据传输和存储管理。这件事在工程上有成本。学术界把这两种策略称为 output-cached(输出缓存)和 output-resend(输出重发)。目前所有主流商业 API,包括 Anthropic、OpenAI、Google、DeepSeek,都选择了 output-resend,也就是不做这一步。
5.2 身份转变有一轮延迟
既然 output 不会自动进入 prompt cache,那上一轮的回答到底什么时候进缓存?
答案是:在它第一次作为 input 被重发的那一轮进入缓存,但是以 cache write 的身份(1.25 倍),而不是 cache read(0.1 倍)。从第三轮开始才是 cache read。
Anthropic 官方文档给出了一张非常清晰的多轮对话缓存行为表:
注意第 2 次请求中的 Asst(2):这是第 1 次请求中模型的 output,现在第一次以 input 身份出现在新请求中。缓存里没有它(因为 output 不自动进缓存),所以它是 cache write。到了第 3 次请求,Asst(2) 已经在缓存里了(第 2 次请求写进去的),变成 cache read。
一段内容的完整身份转变链条是这样的:
第 1 次出现:作为 output 生成 → 按输出价计费;
第 2 次出现:作为 input 被重发,缓存中没有 → cache write(1.25 倍输入价);
第 3 次及之后:作为 input 被重发,缓存中已有 → cache read(0.1 倍输入价)
5.3 每一轮哪些是 read、哪些是 write
在持续对话中(缓存未过期),规律非常稳定:
每一轮新请求中,之前所有已经在缓存中的历史 → cache read(0.1 倍)。 这一轮新增的内容(上轮的回答 + 这轮的新提问)→ cache write(1.25 倍或 2 倍)。
也就是说,每一轮只有"最新的一组内容"是 cache write,其余全部是 cache read。这组内容的大小约等于上轮回答的 token 数 + 新提问的 token 数。
六、工具调用怎么影响计费
前面几章讲的是"用户问一句、AI 答一句"的简单场景。但第三章已经指出,一次回答里可能包含多次工具调用,每次都是一个新的 API 请求。那工具调用中的 token 具体怎么算?
6.1 tool_call 和 tool_result
tool_call 是模型的 output。它是一段 JSON 格式的文本,包含要调用的工具名称和参数,通常只有几十到几百个 token。按输出价计费。
tool_result 是下一次请求的 input。工具实际执行后返回的文本内容。搜索结果可能有几千个 token,一个文件的完整内容可能有几万个 token。按输入价计费(cache write 或 cache read,取决于缓存状态)。
另外还有一个容易忽略的固定开销:工具定义(tool definitions)。所有可用工具的名称、参数描述、功能说明,这些内容是系统提示的一部分,每次请求都要重发。Claude Code 的工具定义大约八千个 token。好消息是这部分非常稳定(同一个 session 内不会变),排在请求结构的最前面,几乎总是 cache read。
6.2 文件和上下文的关系
这个问题在 Claude Code 场景下特别常见:模型修改了一个文件,这个文件的内容会自动进入上下文吗?
不会。 文件存在磁盘上,不在对话上下文中。模型通过 write/str_replace 工具修改文件时,tool_result 返回的只是一条简短的确认信息(比如"替换成功"),不会把整个文件内容塞进上下文。
只有当模型调用 read/view 工具主动读取文件时,文件的完整内容才作为 tool_result 进入上下文。而一旦进入了,这段内容就永久留在对话历史中,之后每一轮 API 请求都会重发它。
所以判断标准不是"这个文件是否存在"或"这个文件是否被修改过",而是"模型是否通过工具看到了这段内容"。凡是工具返回给模型的文本,都会成为对话历史的一部分,在后续每次 API 请求中被重发。
如果模型在第 3 轮读了一次文件(5000 token 进入上下文),在第 7 轮又读了一次同一个文件(又 5000 token 进入上下文),那上下文里就有两份文件内容。第 3 轮的那份在后续走 cache read(0.1 倍),第 7 轮的那份在第 7 轮是 cache write(1.25 倍),从第 8 轮起变成 cache read。
6.3 追问的边际成本没有想象中那么大
在理解了工具调用的计费逻辑之后,可以得出一个实用结论。
之前很多人(包括我)以为"追问一个问题"的成本是很大的,因为要把整个对话历史重发一遍。但如果仔细想想:模型在回答你上一个问题的时候,可能已经因为工具调用产生了 3 到 4 次 API 请求。每次都重发了历史。你再追问一个问题,只是在已有的 N 次请求基础上多了 1 次。
也就是说,追问的边际成本不是从 1 变成 2(翻倍),而是从 N 变成 N+1。N 越大,边际增量越小。
当然,这不意味着可以无限制地追问。对话越长,历史越大,每一次 API 请求中 cache read 的部分虽然只收 0.1 倍,但乘以一个很大的 token 数,绝对金额也会可观。重点是:追问的成本比直觉预期的要低,尤其是在工具调用频繁的 Agent 场景下。
七、缓存的保质期:TTL 机制
前面所有讨论都基于一个前提:缓存还没有过期。这一章讲过期的情况。
7.1 过期后的代价
缓存有保质期,叫 TTL(Time to Live)。5 分钟档的缓存条目在最后一次被访问后 5 分钟过期,1 小时档在最后一次被访问后 1 小时过期。没有更长的选项。
过期后会发生什么?缓存条目被删除。下一次 API 请求到达时,系统发现缓存是空的,所有内容全部变成 cache write。包括之前已经在缓存里待了很久的旧历史,也全部要重新写入。相当于一次冷启动。
7.2 TTL 重置的时机
一个非常重要的细节:每次缓存被命中(发生 cache read)时,TTL 计时器会重置。
也就是说,只要你持续对话,每次 API 请求都会命中缓存、刷新 TTL,缓存永远不会过期。只有当连续超过 TTL 时长没有任何请求时,缓存才会失效。
那 TTL 的重置具体发生在什么时刻?是在新请求的 prefill 阶段,也就是系统检测到前缀匹配并从缓存加载 KV 值的那一刻。不是输出结束时,也不是请求发送时。
这里有一个有意思的极端场景:如果模型的单次输出时间非常长(理论上可能但实际中几乎不会发生),长到超过了 TTL,那么 TTL 是在 prefill 阶段重置的,但到输出结束时已经又过去了很长时间。用户此时追问,新请求到达服务器,系统去查缓存,发现上一次重置已经是很久以前,缓存已经过期,全部内容变成 cache write。
不过实际中不用担心这个问题。单次输出就算跑满 max_tokens(通常几万个 token),生成时间也就几分钟,远远不到 5 分钟的 TTL 时限。
7.3 会员和 API 的 TTL 差异
根据 Claude Code 官方文档:
Claude 会员订阅的 Claude Code 主对话:自动使用 1 小时 TTL。不需要用户配置。
API key 用户的 Claude Code:默认 5 分钟 TTL(写入 1.25 倍,更便宜)。可通过设置 ENABLE_PROMPT_CACHING_1H=1 切换到 1 小时档。
Subagent(子代理):即使主对话是 1 小时档,subagent 也只用 5 分钟档。
claude.ai 网页端:TTL 策略没有公开文档,由 Anthropic 内部管理。
会员用 1 小时档、API 用 5 分钟档的原因很直接:1 小时档的 cache write 是 2 倍(比 5 分钟档的 1.25 倍贵了 60%),但缓存存活时间长了 12 倍。对于会员用户来说,配额是固定的,用 1 小时档意味着"你可以中间停下来想十分钟再继续,缓存还在",总体节省的配额多于多付的写入费。API 用户按量付费,默认用便宜的档位,把选择权留给开发者自己判断。
2026 年 3 月发生过一件事值得一提:Anthropic 把 Claude Code 的默认 TTL 从 1 小时静默降回了 5 分钟。社区通过分析本地日志发现了这个变化。目前 Max 订阅用户仍然是 1 小时 TTL。如果你觉得自己的配额消耗突然变快了,可以检查一下 ~/.claude/projects/ 下日志中的 ephemeral_5m_input_tokens 和 ephemeral_1h_input_tokens 字段,确认当前实际使用的是哪个档位。
八、各家对比
Prompt caching 不是 Anthropic 独有的。OpenAI、Google、DeepSeek 都有各自的实现。但各家在"是否收 cache write 费"、"读取折扣多大"、"是否需要手动开启"等方面差异不小。
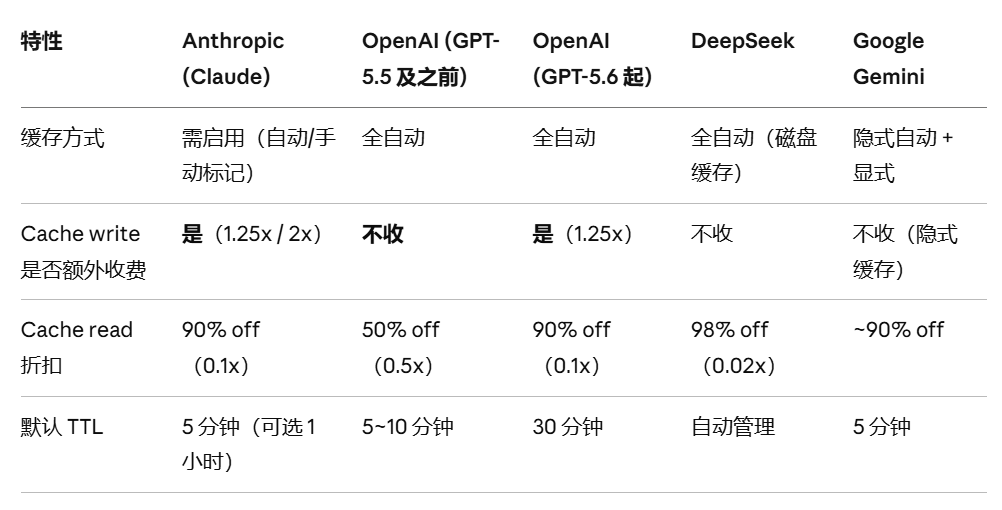
几个值得注意的点:
OpenAI 正在趋同。 GPT-5.5 及之前的模型没有 cache write 溢价,写入缓存是免费的。但 GPT-5.6 开始引入了 1.25 倍的写入溢价,和 Anthropic 的 5 分钟档完全一致。"免费写入"正在成为历史。
DeepSeek 的折扣最激进。 Cache read 只收标准价的 2%(0.02 倍),比 Anthropic 的 0.1 倍还便宜 5 倍,而且没有 write 溢价。不过需要注意的是 DeepSeek 的绝对价格本身就远低于 Claude 和 GPT,所以百分比折扣的实际金额差距更大。
各家都在做 prompt caching,但实现方式不同。 Anthropic 给开发者最多的控制权(可以手动标记缓存断点位置、选择 TTL 档位),但也意味着更多的配置工作。OpenAI 和 DeepSeek 选择了全自动路线,开发者不需要做任何事情。哪种更好取决于场景。
九、完整计费实例
把前面所有概念串起来,用一个完整的场景做一次精确的费用审计。
设定: Claude Sonnet 5 标准价。输入基础价 $3/M token,cache write(5 分钟档)$3.75/M,cache read $0.30/M,输出 $15/M。系统提示 2000 token。5 分钟 TTL。对话间隔均在 5 分钟以内。
Round 1:你问了一个 100 token 的问题
模型收到你的问题,开始回答。
这是第一次请求,缓存是空的,全部内容都是 cache write。
输入费用:2100 × $3.75/M = $0.00788
模型输出了 3000 个 token 的分析文字,然后决定调用搜索工具,输出了 30 token 的 tool_call。
输出费用:3030 × $15/M = $0.04545
第 1 次请求结束。缓存中存入了:[系统提示 2000 + 提问 100] = 2100 token。
搜索工具执行完毕,返回了 2000 token 的搜索结果。客户端把结果追加到历史中,发起新请求。
| cache read | |||||
| cache read | |||||
| cache write | |||||
| cache write |
输入费用:2100 × $0.30/M + 5030 × $3.75/M = $0.00063 + $0.01886 = $0.01949
模型基于搜索结果继续输出 7000 token 完成回答。
输出费用:7000 × $15/M = $0.10500
第 2 次请求结束。缓存更新为:[系统提示 2000 + 提问 100 + 之前的输出 3030 + 搜索结果 2000] = 7130 token。
注意:第 2 次请求中模型输出的 7000 token 不在缓存中(output 不自动进缓存)。
Round 2:你追问了一个 200 token 的问题
| cache read | |||||
| cache read | |||||
| cache read | |||||
| cache read | |||||
| cache write | |||||
| cache write |
输入费用:7130 × $0.30/M + 7200 × $3.75/M = $0.00214 + $0.02700 = $0.02914
模型回答 5000 token。
输出费用:5000 × $15/M = $0.07500
第 3 次请求结束。缓存更新为之前的 7130 + 新增的 7200 = 14330 token。
Round 3:你再追问 150 token
| cache read | |||||
| cache write | |||||
| cache write |
输入费用:14330 × $0.30/M + 5150 × $3.75/M = $0.00430 + $0.01931 = $0.02361
模型回答 3000 token。
输出费用:3000 × $15/M = $0.04500
费用汇总
| 合计 | $0.00707 | $0.07305 | $0.27045 | $0.35057 |
几个值得注意的数字:
输出费占了总费用的 77%。 在这个场景下,真正的大头是输出价($15/M),不是缓存重发。
Cache read 只占总费用的 2%。 虽然历史被反复重发了很多次,但 cache read 的 0.1 倍费率压得很低。
Cache write 占了 21%。 这是新内容(上轮输出 + 新提问 + 工具结果)每次第一次以 input 身份出现时的成本。
追问的边际成本。 如果你把三个问题合成一个一次性问完(假设模型一次性输出 15000 token 不调工具),总费用约为 2100 × $3.75/M + 15000 × $15/M = $0.233。比分三次问的 $0.351 节省了约 33%。但这个差距主要来自 output 的差异(分开问时模型可能有重复的开场和过渡),缓存重发本身带来的额外成本(cache read + cache write)大约只多了 $0.08。
如果你在用 Claude Code 的 API 付费模式,可以在请求的 usage 对象中查看三个字段来验证计费:cache_read_input_tokens(缓存读取的 token 数)、cache_creation_input_tokens(缓存写入的 token 数)、input_tokens(standard input 的 token 数)。三者相加等于总输入 token 数。
十、结尾
回到开头的问题。
模型在输出过程中,前面的历史是否在被反复计费?不会。 在同一次 API 请求内部,输入只在 prefill 阶段计费一次,之后的 decode 阶段不管输出多长,历史都不再参与计费。
模型调用工具算不算新一轮计费?算。 工具调用会触发新的 API 请求,全部历史被重发。匹配缓存的部分按 cache read(0.1 倍)计费,新增内容按 cache write(1.25 倍或 2 倍)计费。
cache write 为什么比普通输入还贵?因为它不仅要计算 KV 值,还要把结果存进持久化缓存。"存"这个动作本身有成本。
归结成两条规则:
第一条:同一次 API 请求内部,输入只付一次账,之后纯输出费用。
第二条:任何触发新 API 请求的事件(用户追问、模型调用工具后拿到结果继续),都会导致全部历史被重发。重发的历史中,和缓存匹配的部分是 cache read(0.1 倍),新增的部分是 cache write(1.25 倍或 2 倍)。
理解了这两条,大模型对话计费的逻辑就全部清楚了。省钱的方向也就明确了:减少不必要的 API 请求次数(合并问题、减少工具调用轮次)、保护缓存前缀不被破坏(不要频繁改 CLAUDE.md、不要频繁切换模型)、在合适的时机开新 session 而不是无限累积历史。
和《大模型缓存机制完全指南》的关系:那篇讲的是"为什么会重复发送"(API 无状态)和"怎么保护缓存前缀"(前缀匹配规则、请求结构设计)。这篇讲的是"每次发送到底怎么收费"(三种计费类型的区分、身份转变的时机、工具调用的隐形成本、TTL 机制)。两篇合在一起,构成对大模型缓存计费机制的完整理解。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,或者使用Claude和Claude code,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。