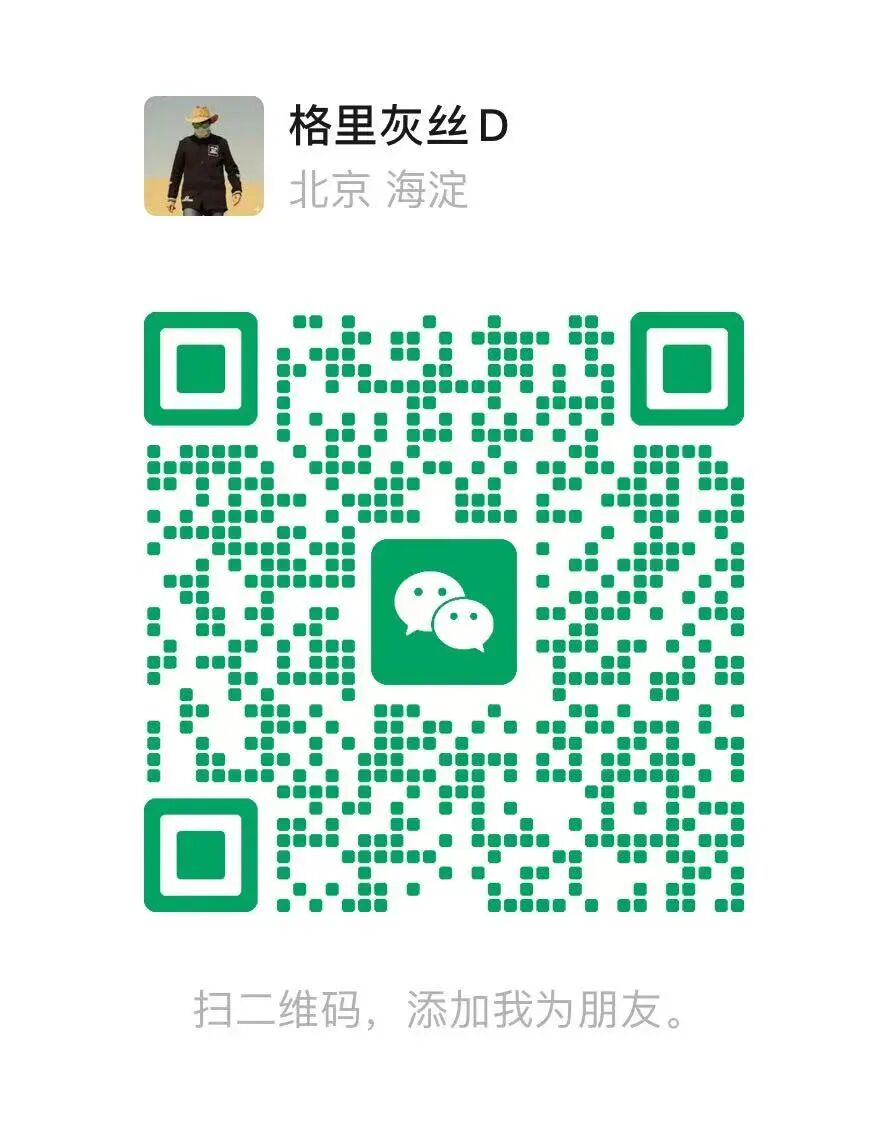
同样一个 token,中文和英文在 AI 脑子里占的"空间"一样吗?
模型给每个 token 的"预算"是一样的
要理解这个问题,首先要知道模型是怎么"看"一个 token 的。
当一个 token 被输入 Transformer 模型后,第一步就是被转换成一个向量(vector),也就是一组数字。这组数字有多少个?取决于模型的设计。比如某个模型的嵌入维度是 4096,那每个 token 就会被转换成一个包含 4096 个数字的向量。
关键来了:不管这个 token 是英文的 "the",还是中文的"国",还是一个逗号,它被转换后的向量都是 4096 维的。维度数量完全一样,没有例外。
模型不会因为"国"这个字含义丰富就多给它几个维度,也不会因为 "the" 含义简单就少给它几个维度。所有 token 拿到的"预算"是严格相等的。
这就产生了一个你可能已经直觉到的问题:预算一样,但要装的东西差了好几倍,装得下吗?
· · ·
行李箱一样大,但要装的东西不一样多
英文的 "the" 是一个定冠词。它的功能非常明确:标记后面的名词是特指的。语义简单,用法固定,上下文变化对它含义的影响很小。用 4096 个维度来表示它,绰绰有余。
中文的"打"则完全是另一回事。打人、打电话、打车、打折、打水、打算、打底、打听、打量、打发。同一个字,几十种完全不同的含义。而且这些含义之间的差异不是细微的,是天差地别的。"打人"是暴力行为,"打折"是商业概念,"打量"是心理活动。
但模型给"打"的向量空间跟给 "the" 的一样大,都是 4096 个维度。
你可以想象成两个人各分到一个同样大小的行李箱。一个人只需要装两件 T 恤("the" 的简单语义),行李箱空间富余,东西摆得整整齐齐,随时能找到。另一个人要把全套正装、运动装、西装革履外加三双鞋全塞进去("打"的几十种含义),行李箱塞得满满当当,所有东西挤在一起,想找某件特定的衣服就得翻半天。
这就是信息密度差异在向量空间中造成的最直接后果:不是"占用维度不同",而是"拥挤程度不同"。
· · ·
"拥挤"意味着什么
先说说"不拥挤"的情况是什么样的。
英文的功能词(the、is、and、but、of)数量有限,含义也简单。它们的向量在 4096 维空间中可以彼此离得很远。就像一个巨大的停车场里只停了几辆车,每辆车之间距离很远,你一眼就能分辨出哪辆是哪辆。模型区分它们几乎不需要费力气。
现在看看"拥挤"的情况。
中文的多义字,比如"打""下""上""过""开",每个字都有大量的可能含义。每种含义都需要在向量空间中占据一个"位置"。但空间大小是固定的(4096 维),要挤进去的含义却很多。结果就是不同含义对应的向量位置挤得很近,彼此之间的区分度变小了。
这就像同样的停车场里挤进了几十辆车,车与车之间的间距变得很窄。远远看过去,相邻的两辆车可能分不太清。模型要区分"打电话"和"打听"的语义差异,就需要更精细的判断,容错空间也更小。
用更技术性的语言说:高密度 token 的向量被压缩得更紧,不同含义之间的向量距离更近,这使得模型在做语义消歧时更容易出错。
· · ·
但模型不是只看一个 token
到这里你可能会觉得中文在模型里被严重"亏待"了。但实际情况没那么悲观,因为模型不是孤立地理解每个 token 的。
Transformer 的核心机制叫"注意力"(Attention)。它做的事情是:让每个 token 去"看"序列中所有其他 token,从上下文中收集信息来修正自己的表示。
这个机制对高密度 token 来说至关重要。
拿"打"来说。在嵌入层(模型的最底层),"打"的向量是一个模糊的、包含所有可能含义的"叠加态"。它同时携带着"打人""打电话""打折"等所有可能性,没有确定是哪一个。
然后注意力机制开始工作。模型看到"打"前面有"给他"、后面有"电话",就把"打"的向量往"打电话"这个特定含义的方向调整。"打人""打折"这些不相关的含义被逐步抑制,"打电话"的含义被逐步增强。
每经过一层 Transformer,这个调整就更精确一些。到了足够深的层,"打"的向量已经不再是模糊的叠加态了,而是精确地指向了"打电话"这个特定含义。
你可以把这个过程理解为"解压缩"。初始嵌入是一个高度压缩的包裹,里面装着所有可能的含义。注意力机制就像一个逐层拆包的过程,根据上下文线索,一层一层地排除掉不相关的含义,最终把正确的含义"解压"出来。
· · ·
浅层和深层:模型是分阶段理解语言的
这就引出了一个有趣的规律:Transformer 的不同层做的事情是不一样的。
在最浅的几层(模型的前几层),每个 token 的向量主要还是由它自己的初始嵌入决定的。上下文信息刚刚开始融入,还没怎么起作用。这个阶段,模型对每个 token 的理解更接近于"这个字本身大概是什么东西",而不是"在这个句子里它具体是什么意思"。
对于信息密度低的 token,浅层就足够了。"the" 不管出现在什么句子里,含义几乎不变,模型在浅层就能确定它的功能。
但对于信息密度高的中文多义字,浅层的理解是非常模糊的。"打"在浅层可能只是一个笼统的"跟用手或用力做某事有关"的表示,根本区分不了打人还是打电话。必须等到更多的上下文信息通过注意力机制融入进来,到了更深的层,"打"的含义才会被逐步锁定。
这个规律可以概括为:浅层处理简单的、局部的信息(词性、基本语法关系),深层处理复杂的、全局的信息(语义消歧、长距离依赖、抽象含义)。
这个规律对所有语言都成立。英文的多义词 "bank"(银行还是河岸)也需要深层来消歧。但因为中文每个 token 平均的歧义度更高,中文整体上对深层的依赖更重。
换一种说法:中文 token 就像一块可以放在拼图中好多个位置的万能碎片,你必须看到足够多的周围碎片(更深的上下文整合)才能确定它到底该放在哪里。英文 token 更像一块形状已经切好大半的碎片,浅层就能大致看出它的位置。
· · ·
一个被忽略的推论:中文可能需要更"深"的模型
如果中文 token 的消歧需要更多层的注意力处理,那一个自然的推论就是:要达到同等的理解精度,处理中文可能需要比处理英文更深的模型。
但现实中,所有主流大模型对中文和英文用的是同一套架构、同样的层数。这个深度是在以英文为主的数据上调优出来的,对英文来说可能正好够用,但对中文来说可能不够充分。
这能解释一个实践中常见的观察:在模型层数比较少的小模型上,中文的歧义错误明显比英文多。而随着模型变深变大,中文的表现改善幅度通常比英文更大。
为什么?因为更深的层提供了更多的"解压缩"机会。对于英文这种歧义度较低的语言,额外的层带来的边际收益不大,反正浅层就已经解决了大部分问题。但对于中文这种歧义度高的语言,每多一层都意味着多一次消歧的机会,收益更大。
这也从另一个角度解释了为什么"模型越大,中英文差距越小":不只是因为大模型见过了更多中文数据,更是因为大模型通常也更深,给了中文更多的"解压缩"空间。
· · ·
歧义不是信息,而是需要被消除的噪声
读到这里,你可能会想:中文每个 token 含义那么丰富,歧义那么多,那是不是意味着中文 token 携带的"信息"比英文多?
这个直觉需要修正。
"打"这个字可以表达几十种含义,但在任何一个具体句子中,它只表达其中的一种。那其他几十种可能性是什么?它们不是有用的信息,而是需要被消除的噪声。模型的工作就是从这些可能性中筛选出唯一正确的那一个。
这就像你在一个有 50 扇门的走廊里找一扇正确的门。门越多不代表你获得的信息越多,只代表你排除错误答案的工作量越大。英文 token 的走廊可能只有 5 扇门,选对门的难度低得多。
所以中文 token 的"信息密度高"准确说应该是"歧义密度高"。高歧义不是优势,是模型需要额外付出计算资源来处理的负担。
这也是为什么我们之前讨论的那个"矛盾"并不成立。有人觉得"中文每个字含义多,中文 token 数量也多,那中文的总信息量不就比英文大了吗?" 但两句话说的是同一件事,总信息量当然一样。中文多出来的 token 是编码开销,中文每个字"含义多"其实是歧义多。两个"多"都不是额外的有效信息,一个是 tokenizer 层面的浪费,一个是语义层面的噪声。
· · ·
如果从头设计,能做得更好吗
理解了上面这些,一个自然的问题是:这种对中文的"亏待"是必然的吗?有没有可能设计一种对中文更友好的架构?
理论上有几个方向可以探索。
第一,可以设计对中文更友好的 tokenizer。比如增大词表中中文词汇(而不只是单字)的比例,让更多的双字词、三字词被合并为单个 token。这样每个中文 token 的有效信息量更接近英文 token,编码效率的差距就缩小了。一些专门面向中文的模型已经在这样做了。
第二,更激进一点,可以让不同信息密度的 token 获得不同大小的向量空间。高密度 token 分配更多的维度,低密度 token 分配更少的维度。这样"行李箱"的大小就跟要装的东西匹配了。但这会让模型架构变得更复杂,计算效率也会受影响,目前还主要停留在研究阶段。
第三,可以设计专门的注意力机制,让模型在处理高歧义 token 时自动投入更多的计算资源。有些研究者在探索"自适应计算"(adaptive computation)的思路:模型根据每个 token 的消歧难度,动态决定用多少层来处理它。简单的 token 过几层就够了,复杂的 token 多过几层。这样就不用给所有 token 强制施加同样的深度了。
但目前这些都是前沿研究,还没有成为主流。现实中的大模型仍然是"一视同仁"的架构:固定维度、固定深度、统一的 tokenizer。这套架构在英文上表现优秀,在中文上也能工作,但对中文来说不是最优的。
· · ·
为什么这件事值得在意
你可能会觉得,向量空间里的拥挤程度、消歧的层数,这些技术细节离日常使用太远了。但它们的影响其实非常具体。
每当你用中文问 AI 一个复杂问题,模型内部都在做大量的消歧工作:这个"打"是什么意思,这个"下"是方向还是动作,这个"过"是经历还是经过。每一次消歧都有出错的概率。消歧任务越重,累积出错的可能性越大。这就是为什么在长链条推理中,中文的准确率往往略低于英文。不是模型"偏心",而是中文给它出的"消歧考试"天然更难。
而这个难度差异是由模型架构的一个基本设计决定的:所有 token,不管信息密度多高,都被塞进同样大小的向量空间里。这个设计简洁、高效,但它隐含了一个假设:所有 token 的复杂度大致相当。对英文来说,这个假设还算合理。对中文来说,它就是一个系统性的低估。
未来或许会有更聪明的架构来解决这个问题,让高密度 token 获得更大的表示空间,让消歧过程获得更多的计算资源。但在那一天到来之前,理解这个机制本身就有价值。它能帮你更准确地预判 AI 在什么时候可靠、什么时候可能出错,以及为什么同一个模型在不同语言下表现会有那个微妙的、不易察觉的、但确实存在的差异。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,或者使用Claude和Claude code,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。