从 0 到 1 打造一个 Agent 系统
你不需要一开始就理解整个 Agent 架构。你只需要从一个最简单的循环开始,每遇到一个痛点,就加一块积木。走完这趟旅程,你会发现自己已经搭出了一个完整的系统。
· · ·
第一层:最小可用的 Agent
一切从一个问题开始:如果让 AI 不只是回答问题,而是帮你做事,最少需要什么?
答案是一个死循环。
whileTrue: 感知:收集信息(用户消息、工具返回的结果……) 决策:LLM 判断下一步做什么 执行:调用工具去做 反馈:把执行结果放回上下文 如果 LLM 返回的是纯文本(没有工具调用)→ 跳出循环,任务结束
这就是 Agent 的主循环。感知是把信息喂给 LLM,决策是 LLM 思考后选择行动,执行是真正去做,反馈是把结果送回来让 LLM 继续判断。
为什么用"纯文本"作为结束标志?因为 LLM 每次返回只有两种可能:一种包含工具调用,说明它还想做事;另一种是纯文本,说明它觉得做完了,要把最终答案告诉用户。
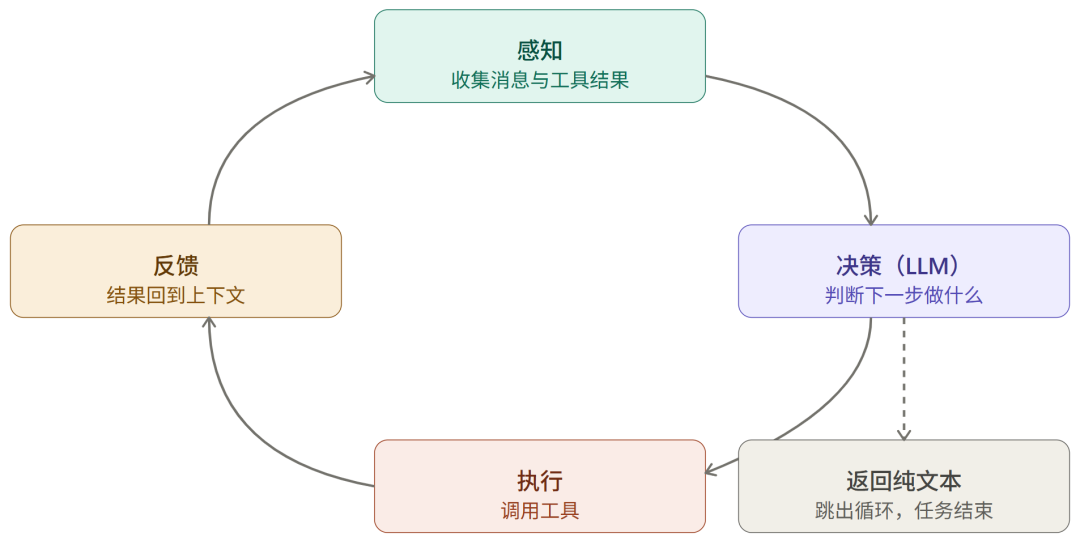
就这么几行逻辑,一个最基础的 Agent 就跑起来了。
但它马上会遇到第一个问题。
· · ·
第二层:工具系统 —— 给 Agent 一双手
痛点:LLM 光会想,没有手。
LLM 能思考、能规划,但它不能读文件、不能跑代码、不能搜索网页。没有工具,它就是一个只会说话的大脑。
解法:定义工具集 + handler。
工具分两部分。第一部分是工具定义,告诉 LLM "你有哪些工具可以用,每个工具需要什么参数"。第二部分是 handler,就是 LLM 真的选了某个工具时,实际执行的那段代码。
工具定义:name: "search", params: {query: string}handler:function search(query) { 调用搜索 API,返回结果 }
LLM 看到工具定义后,会在需要时输出"我要调用 search,参数是 xxx",主循环里的代码解析这个调用,跑对应的 handler,把结果放回上下文,LLM 继续思考。
这里有一个重要的设计原则:新能力通过加工具扩展,不改主循环。 想让 Agent 能读文件?加一个 read_file 工具。想让它能发邮件?加一个 send_email 工具。主循环的代码一行都不用动。
但光有工具还不够,LLM 怎么知道什么时候该用什么工具?这就需要系统提示词。你在系统提示词里告诉 LLM:"你是一个编程助手,遇到需要执行代码的情况用 shell 工具,需要查资料的情况用 search 工具。" 系统提示词塑造了 Agent 的行为方式,也是后续调优最常动的地方。
工具和提示词,加上前面的状态外化(后面会讲),构成了扩展 Agent 能力的三种方式。记住这一点,后面会反复用到。
现在 Agent 能想能做了,但很快你会遇到第二个问题。
· · ·
第三层:上下文管理 —— 桌面太小了
痛点:对话越来越长,上下文窗口爆了。
LLM 的上下文窗口是有限的,比如 128K token。Agent 每调一次工具,返回的结果就堆在对话历史里。搜索返回一堆 JSON、代码文件读进来几千行——几轮下来,上下文就快满了,早期的关键信息被挤掉。
解法一:压缩整合。
当 token 使用量达到上限的一半时,触发整合。让 LLM 把旧消息压缩成摘要,追加到一个 MEMORY.md 文件里,然后移动指针跳过旧消息。注意:不删除原始消息,只是标记"已整合"。万一整合失败,把原始消息归档到 archive/ 目录。这样压缩就变成了一种有损但可追溯的操作——平时是有损的(上下文里只有摘要),但需要时可以从文件里找回细节。
解法二:文件系统做缓冲。
工具调用返回了 5000 行 JSON,不要全塞进上下文。写到文件里,Agent 用 grep 按需提取需要的几行。上下文只放 200 token 的精准结果,而不是 10000 token 的原始数据。
这里的核心思路是:把上下文窗口当内存,把文件系统当硬盘。 频繁访问的放内存,不常用的放硬盘,需要时再取。
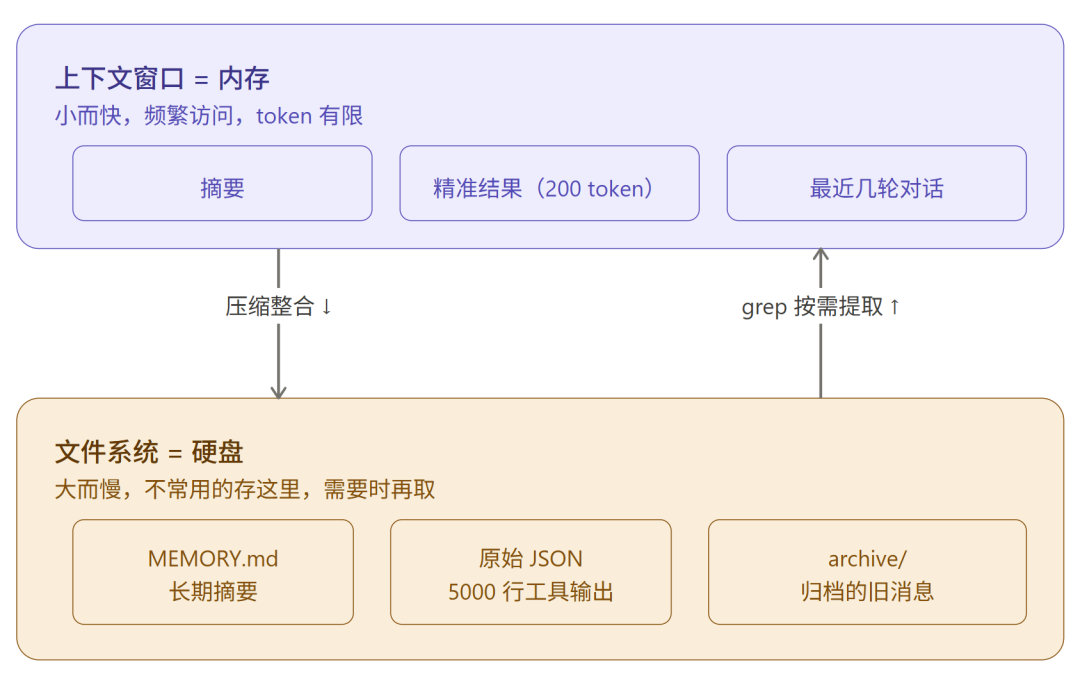
上下文管好了,但还有一个隐蔽的浪费。
· · ·
第四层:消息分层 —— 别让 LLM 看到垃圾
痛点:框架产生的内部事件也塞给了 LLM,白白消耗 token。
Agent 运行过程中,框架会产生很多内部事件:"上下文压缩触发了"、"某个工具调用超时被跳过了"、"推送了一条通知"。这些信息框架自己需要记住,方便调试和排查。但 LLM 完全不需要看——你告诉它"压缩发生了",它也不知道该怎么处理。
解法:分两种消息类型。
AgentMessage 是给框架用的,可以携带任意自定义字段(时间戳、事件类型、内部状态)。Message 是给 LLM 用的,只保留 user、assistant、tool_result 三种标准类型。发给 LLM 之前过滤一遍,会话历史保留完整框架状态,LLM 只收它需要的部分。
类比一下:公司内部系统记录了"小王请假导致延期""服务器重启了一次",但给客户看的只有正式的沟通邮件。
到这里,单次对话的问题基本解决了。但如果任务做不完呢?
· · ·
第五层:跨 Session 续跑 —— 记忆不能断
痛点:Session 结束了,任务还没做完,下次启动一片空白。
Session 就是一次会话。你关掉对话或者上下文彻底满了,Session 就结束了。如果让 Agent 搭一个完整的电商网站,一个 Session 可能只够做完用户登录模块。下一个 Session 启动时,Agent 不知道上次做到哪了。
解法:把状态外化到文件。
这里的"状态"不只是上下文,而是所有需要持久保存的信息。具体来说,准备三个文件:
CLAUDE.md:项目级别的规范和约束——技术栈、代码风格、测试要求。基本不变。
todo.md:任务清单和完成状态。每完成一个任务就更新。
.claude/commands/next-task.md:自动化每轮工作流的指令。
todo.md 是数据,next-task.md 是指令。前者像你桌上的待办便签,后者像你写给实习生的操作手册——"每天来了先看便签,挑第一个没做的做,做完打勾"。有了操作手册,你每次启动 Agent 只需要输入一个命令,不用重复描述流程。
更复杂的场景可以拆成两个角色:Initializer Agent 只跑一次,负责拆任务、建骨架、初始化进度文件;Coding Agent 反复跑,每次读进度、做一个任务、更新进度、提交代码。这样即使中途崩溃,也能从文件系统里恢复现场。
任务能续了。但随着功能越加越多,主循环开始变胖了。
· · ·
第六层:事件流 —— 主循环不能再膨胀了
痛点:想加日志、加 UI 实时显示、加评测,每个功能都要改主循环代码。
你在主循环里加了写日志的代码,又加了更新 UI 的代码,又加了发送评测数据的代码……循环体越来越臃肿,改一个地方可能影响其他功能。
解法:事件流。
主循环在三个时机往外广播事件:工具开始调用时(tool_start)、工具调用结束时(tool_end)、一轮对话结束时(turn_end)。每个事件带上相关数据。
下游功能各自订阅这些事件:
agent.on("event") -> write_to_logs # 写日志agent.on("event") -> update_ui # 更新界面agent.on("event") -> send_to_eval # 发送评测
想加新功能?写一个订阅者,注册到事件总线,完成。主循环一行不改。
这些订阅者都是旁路操作——日志写没写成功、UI 有没有刷新,完全不影响 Agent 的决策。主循环广播完事件就继续走,不等任何人。
核心原则:publish once, consume many, main loop never changes for downstream。
事件流让旁路功能彻底解耦了。但日志、UI 这些旁路不需要结果回到主循环——可如果 Agent 派出去的任务本身就很慢呢?
· · ·
第七层:后台 I/O —— 别让慢操作拖住大脑
痛点:Agent 让工具去跑一个完整的测试套件,要 3 分钟。下载一个大文件,要 5 分钟。主循环傻等着,LLM 什么都做不了。
解法:慢任务丢后台线程,结果通过通知队列注入。
主循环每轮开头多一步:检查通知队列。
whileTrue:# 检查后台有没有完成的任务 new_results = check_queue()if new_results: inject_into_context(new_results)# 正常的感知→决策→执行→反馈 response = llm(messages) ...
如果队列里有新结果,塞进上下文,LLM 下一轮就能看到。如果没有,LLM 自己判断:是先做别的事,还是等一等。等不等不是代码写死的,是 LLM 根据上下文决定的。
注意区分两种外部交互:事件流是只出不进的旁路(日志、UI),通知队列是有去有回的异步任务(后台测试、下载)。两个机制各管各的。
慢操作的问题解决了,但还有一个更基本的问题被忽略了:工具调用本身就可能失败。
· · ·
第八层:错误处理 —— 工具不总是听话的
痛点:Agent 调搜索 API,网络超时了。读一个文件,路径不对。调用数据库,连接断了。工具不是每次都能成功的,失败了怎么办?
这里有两种策略。
代码层自动重试:对于明确的临时性错误(网络超时、限流),handler 里直接重试 2-3 次,LLM 不需要知道。
交给 LLM 决策:对于语义性错误(搜索没找到结果、文件路径不对),把错误信息放回上下文,让 LLM 决定是换个关键词重搜、换个路径、还是放弃这条路换方案。
原则还是一样:确定性的事交给代码,需要判断的事交给 LLM。 不要在代码里写一堆 if/else 处理各种错误场景,那会让主循环变成状态机。
到这里,一个单 Agent 系统已经相当完善了——能执行工具、能管理上下文、能跨 Session 续跑、能异步处理慢任务、能优雅地处理错误。但当任务复杂到一定程度,一个 Agent 就不够了。
· · ·
第九层:多 Agent 协作 —— 一个脑子装不下
痛点:让 Agent 搭一个完整的电商系统,前端、后端、数据库、测试全要做。一个 Agent 的上下文窗口装不下所有细节,而且它是串行的,一次只能做一件事,效率太低。
解法:主 Agent 派子 Agent,各自独立上下文。
子 Agent 带着干净的上下文去做一件具体的事,做完把结果(几句话的摘要)返回给主 Agent。搜索和调试的细节留在子 Agent 自己的上下文里,不污染主 Agent。
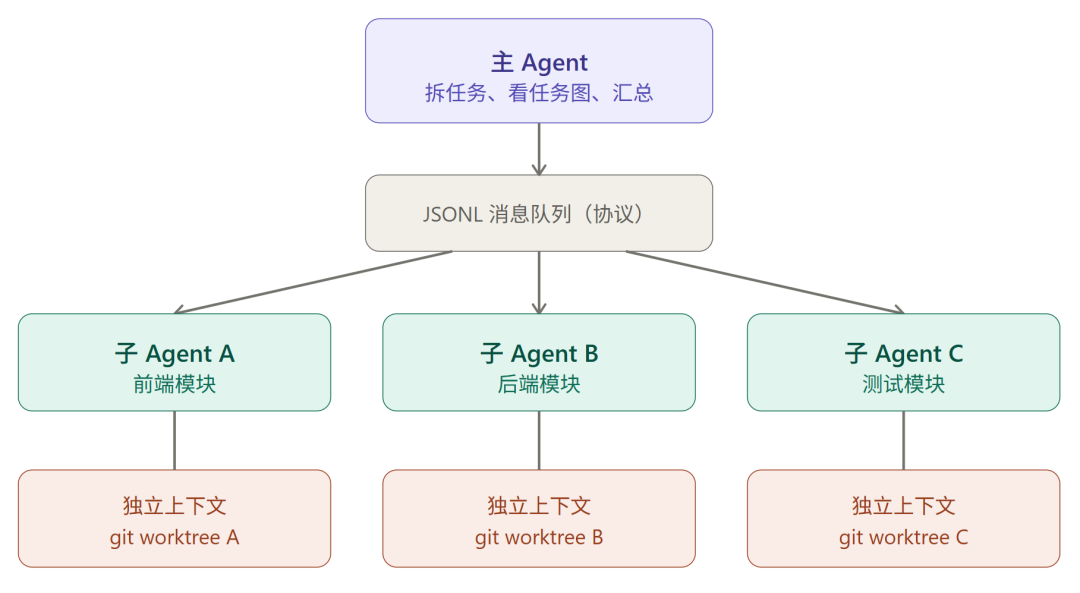
但多 Agent 协作需要基础设施:
协议:Agent 之间不靠自然语言喊话,而是通过 JSONL 消息队列传递结构化消息(谁发给谁、什么内容、什么状态)。append-only,崩溃可恢复。
任务图:记录任务之间的依赖关系。购物车依赖商品列表完成才能开始,支付依赖购物车。主 Agent 看任务图就知道哪些能并行、哪些要等。
隔离:用 git worktree 给每个子 Agent 独立的工作目录,避免同时改同一个文件冲突。同时给子 Agent 最小系统提示——只给工具和工作目录,不给 Skills 和 Memory 权限,防止权限外泄和隔离破坏。
顺序很重要:协议先定,隔离先做,再谈协作和并行。
多 Agent 系统跑起来了。但此时所有消息还是从同一个入口进来的——你的终端或者一个 API。如果你想让它同时服务飞书群、Telegram 频道、网页客服呢?
· · ·
第十层:多渠道接入 —— 消息从哪来不重要
痛点:老板说"把这个 Agent 也接到飞书上",然后又说"Discord 也要",每加一个渠道你就得在 Agent 代码里加一套解析逻辑。
解法:Channel Adapter + MessageBus。
每个渠道有自己的适配器,负责把该渠道的消息格式转成统一格式,丢进 MessageBus。Agent 只从 Bus 里取标准消息,完全不知道消息是从飞书来的还是 Telegram 来的。加第 24 个渠道?写一个新 Adapter 就行,Agent 代码一行不动。
Session 由 Agent 层统一管理,不下沉到 Channel 层。如果飞书和 Telegram 绑定了同一个用户 ID,两边的对话共享上下文;跨渠道的长期记忆靠 MEMORY.md。
多渠道解决了"消息从哪来"的问题。但不管有多少渠道,Agent 始终在被动等消息。如果你想让它每天早上自动发一份摘要、每隔几分钟检查一下有没有新任务呢?
· · ·
第十一层:主动触发 —— Agent 也需要闹钟
痛点:Agent 只能等用户说话才动。你想让它每天定时跑一个总结任务,或者每 5 分钟检查一下是否有新数据要处理,但没人发消息它就不会动。
解法:cron 和 heartbeat。
cron 是操作系统或编程语言本身就有的定时能力,跟 AI 无关。Agent 框架只是把它接进来:定时器到点,往消息队列塞一条消息(比如"执行每日摘要任务"),主循环照常处理。
接入点在感知层——主循环以为来了一条普通消息,其实是闹钟响了。主循环不需要知道消息是人发的还是定时器发的。
heartbeat 是更高频的轮询(比如每 5 分钟一次),内容是"检查有没有待处理的任务"。
Agent 现在能做的事越来越多了——能执行 shell 命令、能读写文件、能上网搜索、还能定时自己跑任务。能力越大,风险越大。如果它执行了 rm -rf / 呢?
· · ·
第十二层:安全边界 —— 能力越大,围栏越高
痛点:Agent 有了 shell 权限,理论上它可以删除整个文件系统、读取系统密码文件、把代码推到错误的仓库。你不能指望 LLM "自觉"不做这些事。
安全边界不是要求 Agent 自觉守规矩,而是在代码层面让它做不到越界操作。三件事必须到位:
白名单授权:只有指定用户才能触发 Agent。一个 if 判断,不在白名单里直接拒绝。
工作空间隔离:工具的 handler 里做路径检查,用 realpath 解析符号链接,发现路径不在工作目录内就直接报错。用 execFile 而不是 exec,防止 shell 注入。
审计日志:每次工具执行都记一笔——谁调的、什么时间、执行了什么、结果是什么。日志不会凭空出现,需要你写代码记录(或者用框架内置的事件流订阅者)。
这是多层防御:提示词约束最弱(LLM 可以忽略),代码层路径检查是第二层,Docker 容器或虚拟机沙箱是最后兜底。
安全围栏建好了,Agent 不会搞破坏了。但还有最后一个问题:你怎么知道它在把事情做对?你改了一句提示词,之前能做对的任务会不会突然做错了?
· · ·
第十三层:可观测性与评测 —— 怎么知道它在变好
痛点:Agent 做了 20 步才给出结果,结果是错的。你看着最终输出完全不知道哪一步出了问题。更隐蔽的是,你优化了提示词让 A 场景变好了,但 B 场景悄悄变差了,你毫不知情。
Trace 解决排查问题。 每次运行记录完整轨迹:给了 LLM 什么提示词、LLM 怎么想的、调了什么工具、参数是什么、返回了什么、花了多少 token。出了问题,回放 Trace 定位到具体是哪一轮决策出的错。
两层可观测解决规模问题。 第一层是人工抽查——从失败案例里挑一些仔细看 Trace,发现失败规律。第二层是 LLM 自动批量评分——覆盖所有 Trace,但需要人工标注的结果来校准。人工定标准,自动跑规模。
评测体系解决回归问题。 从第一个真实失败案例开始,转成测试用例。20-50 个案例就够启动。每次改了提示词或工具,跑一遍评测,对比成绩。通过率接近 100% 时,补充更难的任务——评测套件饱和了说明它已经不能反映真实能力边界了。
评测不是 Agent 自身的一部分,是工程实践。如果你只是用别人的 Agent 不需要关心;如果你自己开发 Agent 系统给别人用,评测是必须的。
· · ·
回看整体:一张图看清全貌
走完这十三层,回头看,会发现一个关键事实:主循环始终是那几行代码。
while True: context = build_context(messages, tools, files) response = llm(context) if response.is_text(): return response result = execute_tool(response.tool_call) messages.append(result)
所有的复杂性都被推到了主循环的外围:
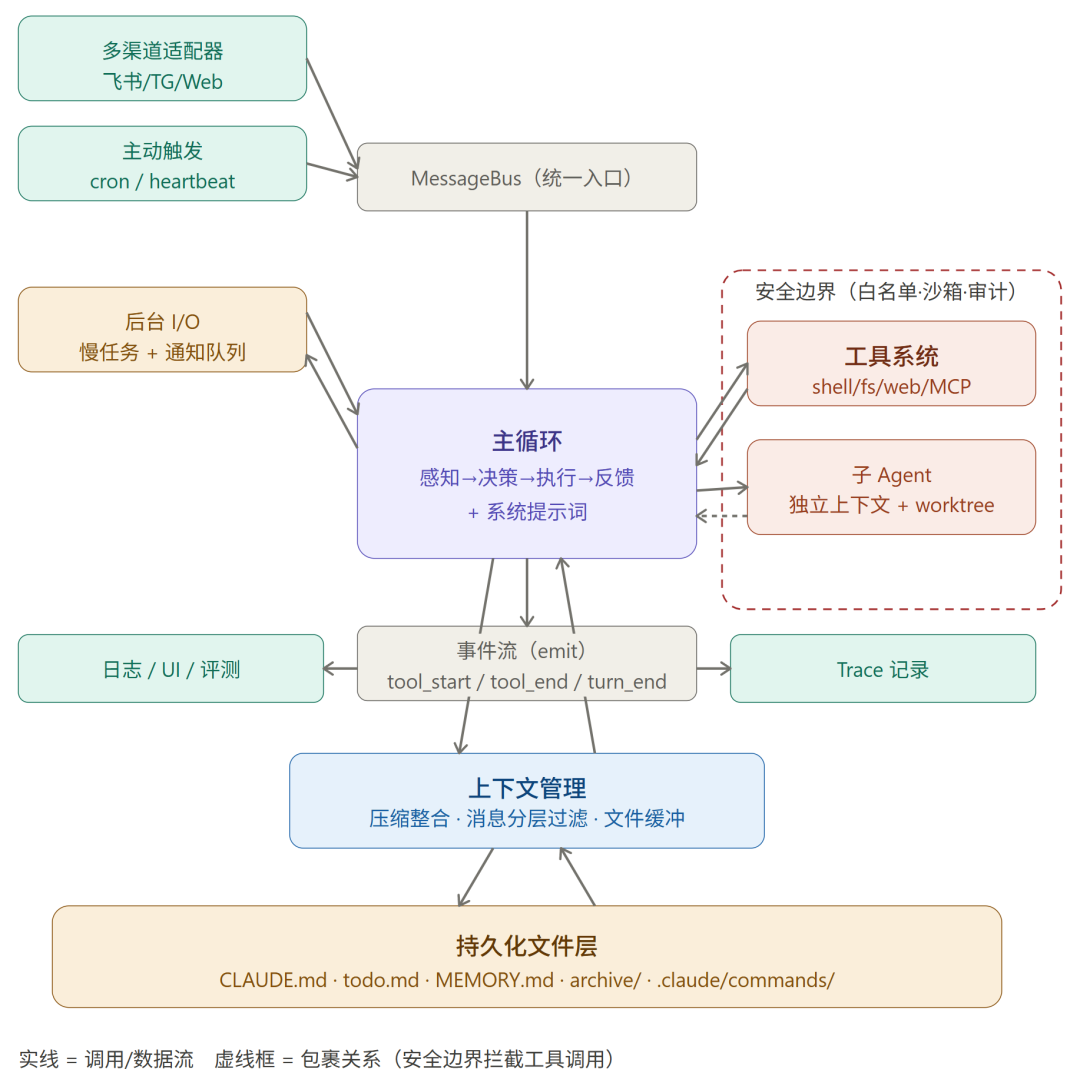
扩展 Agent 能力,永远只用三种方式:
加工具:扩展执行能力,不改主循环
调提示词:调整决策行为,不改主循环
状态外化:把数据写到文件或数据库,不改主循环
不要让主循环变成一个巨大的状态机。模型负责推理,外部系统负责状态和边界。一旦这个分工确定下来,核心循环逻辑就很少需要频繁调整了。
Agent 不是一个神秘的黑盒,它就是一个循环,加上围绕这个循环的一圈基础设施。 理解了这一点,你就理解了所有 Agent 框架的底层逻辑。剩下的,只是工程实现的细节。
· · ·
如果你觉得这篇文章有帮助,欢迎分享给同样对 Agent 感兴趣的朋友。