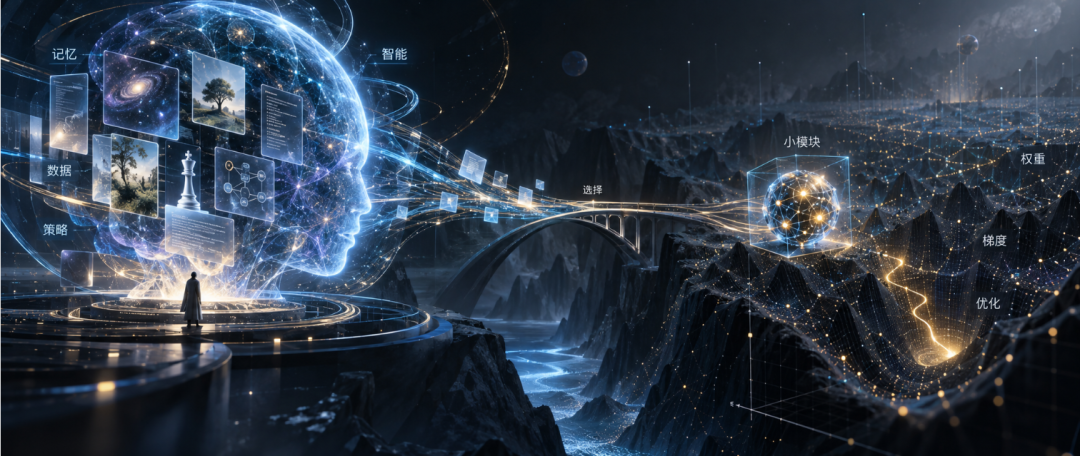
能不能用大模型来训练大模型?
最近碰到一个场景,越想越觉得值得写出来聊聊。
我们有内部的大模型可以免费用,但没有自己的GPU算力。大模型本身就是一台巨大的智能机器,它能理解问题、做推理、写代码、做判断。那一个很自然的念头就冒出来了:能不能让大模型自己训练出一个新模型?
不是让大模型生成训练数据,然后再找GPU去做训练那种间接方式,而是更直接地,让大模型承担训练过程本身。
这个念头听起来有点疯狂,但认真想下去,它碰到了一些很根本的问题,也在碰壁的过程中摸到了一些更深的东西。
一条已经走通的路
先把最常见的路线交代清楚。
业界确实有一种"用大模型帮忙训练小模型"的做法。思路很简单:让大模型充当老师,批量生成高质量的问答数据,然后拿这批数据去训练一个参数量小得多的学生模型。这在行业里叫"知识蒸馏",也叫"合成数据"路线。
Stanford的Alpaca项目是早期的代表。他们用GPT生成了5万条指令数据,去训练了一个7B参数的小模型,效果出乎很多人的意料。微软的Phi系列走得更远,几乎完全靠合成数据训练出来的小模型,表现远超同级别的其他模型。Vicuna、WizardLM等一批开源项目也都是这条路上的成果。
这条路已经被反复验证了,很多公司也在实际业务里这么做。
但它有一个绕不过去的环节:最终还是需要GPU来完成训练。大模型在这里扮演的是"原材料供应商"的角色,真正的"施工"(反向传播、更新权重这些过程)还是得靠传统算力来干。
所以问题变成了一个更激进的版本:施工的活也能交给大模型吗?让它直接去调整模型的权重参数?
为什么非要盯着"改权重"这件事
很多人听到这里会说,何必非要改权重呢?把提示词写好就行了。
提示词确实好用,但它有几个绕不过去的天花板。
提示词是临时性的。每次新对话开始,我们都得把背景信息重新塞进去,模型才知道该怎么做。上下文窗口有长度限制,塞不下的部分就得丢掉。更关键的是,提示词只能在模型已有能力的范围内做选择和引导。模型原本不懂的东西,提示词再怎么写也教不会它。
训练是另一码事。训练改变的是模型的参数,相当于改写了它大脑里突触连接的强度。训练过后,模型真的"记住"了新知识,"学会"了新能力,这些能力内化在了模型里面,不需要每次都从外面注入。
如果我们想让一个模型获得某种它原本不具备的专长,比如精通某个垂直领域的专业知识,或者学会某个人的思维方式和判断习惯,光靠提示词是够不到的。得动权重。
那大模型有智能、能理解、能推理、能判断,让它来干这个活,到底行不行?
一个很强的直觉
先说说为什么这个想法看起来应该成立。
传统的模型训练靠梯度下降。把数据喂进去,看输出对不对,算出误差,按照数学公式调整参数值让误差变小,然后下一轮再来。整个过程完全是机械的。梯度下降不"理解"自己在训练什么,不知道模型最终要用来干什么,也不会根据经验跳过明显没希望的方向。它就是按照公式一步步算。
大模型呢?它能看懂输入和输出之间的关系,能判断什么样的调整方向可能有效,能从错误中总结规律。按道理说,一个有判断力的优化过程,效率应该比一个纯机械的过程更高。
下棋就是个好例子。人类棋手靠经验和直觉,几秒钟就能排除绝大多数无意义的走法,只把精力花在少数几个有潜力的选择上。早期的计算机象棋程序靠暴力搜索所有可能的走法,最终也能下好棋,但需要的计算量大得多。在搜索这件事上,有判断确实比没判断更高效。
这个直觉很强,在很多领域也确实成立。
那为什么在训练模型这件事上,它似乎不太管用了?
梯度下降的真面目
这里需要纠正一个认知。
我们前面说梯度下降是"机械的""盲目的",但这个说法不完全公平。梯度下降确实不理解语义层面的东西,但它有一个极其强大的数学工具:微积分的链式法则。
这个工具做了一件什么事呢?一次反向传播,就能同时算出模型里所有参数各自应该往哪个方向调、调多大幅度,让误差最有效地减小。注意"同时"和"所有"这两个词。一个70亿参数的模型,一次反向传播就把70亿个参数的调整方向全部精确算出来了。不需要一个个去试,也不需要猜。
打一个比方。想象我们站在一座连绵起伏的山脉上,要找到海拔最低的山谷。梯度下降相当于脚底装了传感器,每一步都能感知所有方向的坡度,然后沿着最陡的下坡路走。这个传感器是链式法则提供的,精确、可靠、成本极低。
现在换成让大模型来干同样的事。相当于叫了一个非常聪明的人站在山上,但蒙着眼睛。我们只能告诉他:"你现在海拔352米。"他得靠推理来猜应该往哪走。他可能会问上一步海拔是多少、走的是哪个方向,然后做出不错的判断。但他始终在"猜",而梯度下降在"算"。
在一个三维空间里,聪明人靠猜也许不会比传感器差太多。但我们面对的是一个70亿维的空间。维度每上升一个数量级,靠推理来猜方向的难度指数级增长,而梯度下降靠公式算方向的成本只是线性增加。
差距不是百分之几十,是好几个数量级。
所以问题的关键其实在这里:大模型确实有判断力,但梯度下降手里有链式法则这个"数学外挂"。在超高维的参数空间里,精确的数学公式碾压了基于语义的推理。
智能的边界在哪里
说到这里,好像大模型在训练这件事上完全没用了。但再想一层,也不全是这样。
大模型的智能建立在语义理解上。它理解"这段话写得好不好""这个推理有没有逻辑漏洞""这个分类结果对不对"。这些判断都发生在人类概念的层面上。
但单个参数的值,比如0.00137,代表什么意思?什么都不代表。一个权重值只有跟其他几十亿个权重放在一起协同工作时才有含义。单独拿出来,就是一个抽象的数字。大模型的判断力在这个层面上找不到抓手,因为这里没有语义可以抓。
但如果我们缩小问题的规模呢?
假设要优化的参数量不是70亿,而是几千个。比如一个微型的分类器,或者一个很小的adapter(适配器模块)。这个尺度下,所有参数都能放进大模型的上下文窗口。我们可以把当前的权重、模型的输出、期望的正确输出一起给大模型看,让它分析差距出在哪里,推理出应该怎么调整。在这个小得多的空间里,大模型的推理能力可能真的用得上。
Google有一篇论文叫OPRO(Large Language Models as Optimizers),做了一件类似的事。它让大模型来优化提示词:把几个候选的提示词和它们各自的效果得分放在一起给大模型看,让大模型推理出一个更好的版本。结果在很多任务上,大模型优化出来的提示词比人工精心设计的更好。
这个实验验证了一件重要的事情:大模型确实可以充当优化器。前提是优化的空间足够小,而且优化对象有语义含义。提示词恰好同时满足这两个条件,所以效果很好。
顺着这个思路再往前推一步。LoRA这类技术已经可以把微调所需的参数量压缩到几百万甚至更少。如果是一个极小版本的adapter,只有几千个参数,让大模型直接去搜索它的最优权重值,虽然效率比不上梯度下降,但在理论上并非完全不可行了。
到这里我们能看到一条边界线:大模型的智能在有语义结构的、维度可控的空间里强于暴力搜索,但在无语义的超高维空间里远弱于数学公式。这条边界线决定了大模型在训练中到底能扮演什么角色。
重新理解"训练"
走到这一步,可以退后一步来想想"训练"这件事到底是什么。
我们平时说训练模型,指的是通过反向传播来更新权重。但训练的目的从来就不是"更新权重"本身。训练的真正目的是让一个系统的行为变得更好、更准确、更符合我们的需求。更新权重只是达成这个目的的一种手段,碰巧是目前效率最高的一种。
如果从目的出发来想,大模型其实可以在很多环节上让一个AI系统整体变得更好。
选什么数据来训练,这个决策对最终效果的影响巨大,大模型能做得很好。模型的结构应该怎么设计,大模型能给出有理有据的建议。训练过程中如果损失曲线出现异常,大模型可以分析原因并建议调整策略。训练完之后找出模型的短板在哪里,大模型能做系统性的测评分析。然后根据分析结果生成针对性的补充数据,进入下一轮迭代。
在这整条链路上,大模型承担的是总工程师的角色。它不去拧每一颗螺丝,但它决定了蓝图怎么画、材料怎么选、进度怎么排、质量怎么验。一个优秀的总工程师对最终产品的影响,往往比流水线上任何一个单独工种都大。
还有一种更彻底的思路。大模型可以维护一个不断增长的记忆库。每一次交互之后,总结哪些策略有效、哪些无效,把新发现的规律、犯过的错误写进长期记忆。下一次面对类似问题时,把相关记忆调出来注入上下文。模型的参数一个都没动,但系统作为一个整体在持续进步。MemGPT项目走的就是这个方向,让大模型自主管理多层级的记忆结构,实现了类似"持续学习"的效果。
也可以用进化的思路。大模型生成一批处理问题的策略或规则,在测试集上评估表现,分析哪些好、哪些差、差在哪里,然后基于分析结果生成新一代策略。这个过程循环下去,就是一套用推理能力驱动的进化算法。"进化"出来的虽然不是神经网络的权重,而是一套规则或流程,但它确实是系统自己"学到"的。
站在边界上
回到最初那个念头:能不能用大模型来训练大模型?
如果严格按照"训练"的传统定义,让大模型通过反向传播去更新另一个大模型的权重,目前做不到。70亿维的参数空间远超大模型的推理能力所及,而梯度下降拿着链式法则这把数学利器,在这个尺度上的效率领先了好几个数量级。
但如果我们把视野放开,"训练"的目标本来就是让系统变好。大模型作为总工程师来掌控整个训练流程的决策层,作为进化引擎来搜索最优策略,作为记忆管理者来实现持续学习,甚至对于足够小的参数空间直接上手做优化,这些都是已经被验证或正在被探索的真实路径。
最终的架构可能是一个冻结的大模型作为核心智能,搭配一套不断进化的记忆和策略系统,再加上一个参数量极小的、可以被大模型直接优化的本地模块。这个系统不需要传统意义上的"训练",但它确实在不断学习、不断变好。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。