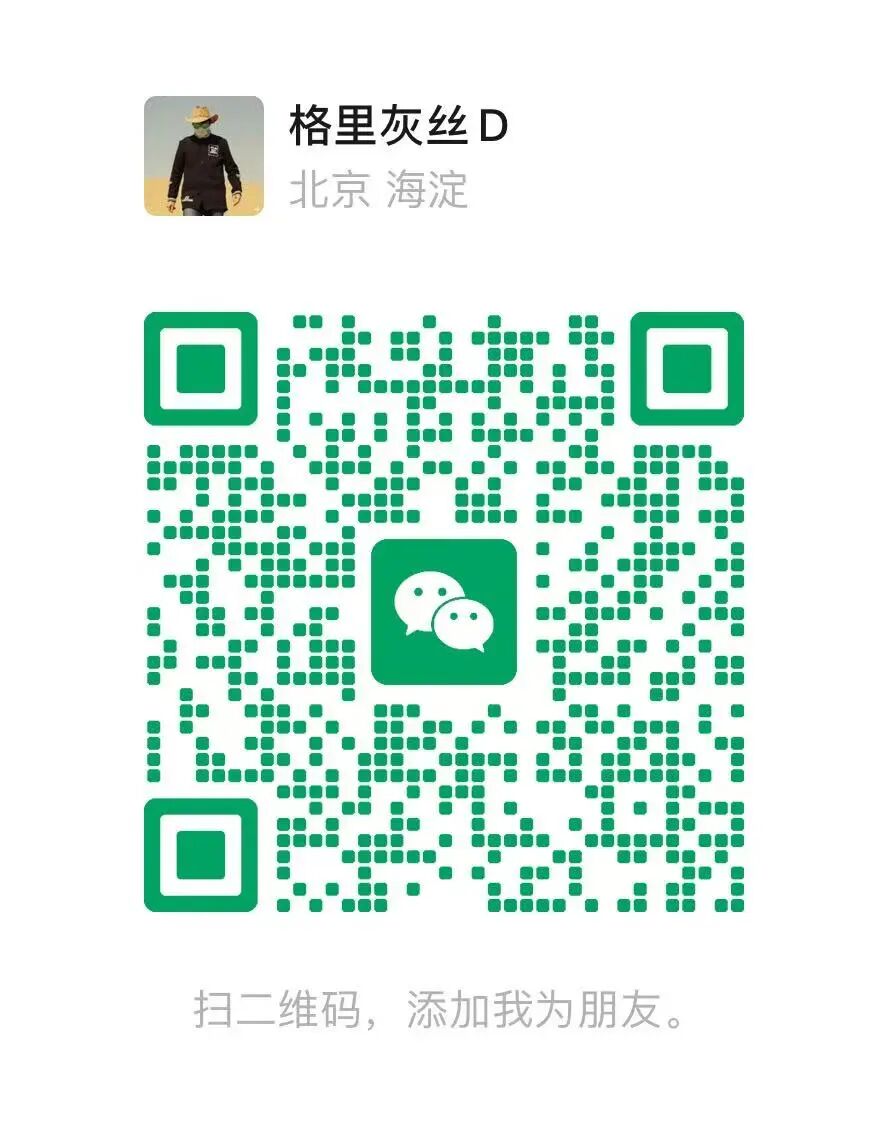
智能的形状
我之前一直在问一个问题:Fable 5 到底有多强?
强到什么程度?比其他模型强多少?是不是已经强到我没法评价了?
后来我发现这个问题本身就是错的。
不是因为 Fable 5 不够强。它在编码上确实是顶级的。但"强"这个字暗含了一个假设:智能是一条线,模型们在这条线上排队,谁排前面谁就"最强"。
我们太习惯这个思维了。基准测试给你一个分数,排行榜给你一个名次,媒体给你一个结论:"某某模型登顶"。整个叙事结构都在暗示智能是一个可以排序的东西,就像身高或者百米成绩。
但如果你真正深入地用这些模型,用到足够多、足够深,你会发现一件事:没有谁在所有方向上都是第一。
Fable 5 编码极强但语言表达被挤压了(《神的陨落:Fable 5竟然也会写bug》里有详细的讨论)。Opus 4.6 语言至今顶级但 agentic 能力不如 Fable 5。Kimi3 在某些模式识别上有独到之处。GLM5.3 在长程任务上表现惊人。GPT 5.6 sol 的综合稳定性很好但没有哪个方向特别突出。
它们不是排在一条线上的。它们是散布在一个多维空间里的不同形状。
一旦你看到了形状,"谁最强"这个问题就自然消失了。取而代之的是一个更有用的问题:这个形状的哪些边,跟我当前的任务最匹配?
为什么智能不是一个数字
我们习惯了用单一分数衡量智能。IQ 是一个数字,高考是一个分数,基准测试是一个排名。这个习惯太深了,深到我们几乎不会质疑它。
但你想想,用一个数字来概括一个人的能力,你自己信吗?
一个数学天才可能写不出一封得体的邮件。一个文学大师可能算不清楚自家的账。一个顶级外科医生可能不会修自行车。你不会说这三个人里"谁最聪明",因为你知道这个问题没意义,他们的能力分布在不同的维度上。
AI 模型也是一样。只是因为基准测试给出了一个数字,我们就假装这个数字能代表一切。
大模型公司自己其实非常清楚这一点。在模型开发和训练过程中,他们内部评估用的从来不是一个总分,而是一组维度化的指标。工程师们盯着的是一张雷达图,不是一条排行榜。只是对外宣传的时候,雷达图不好做标题,"我们又登顶了"才有传播力。
那真实的维度到底有哪些?
在跟 AI 深入打交道的过程中,我逐渐理清了一张能力地图。它不是我发明的,而是从大模型公司的内部评估逻辑、学术界的研究框架、以及我自己大量使用的体感中综合提炼出来的。大致可以分成八个大类。
语言能力。 包括阅读理解、生成质量、多语言能力和指令遵循。这是最基础的那一层,但也是最容易在后训练中被挤压的。一个模型可能推理能力很强,但写出来的东西读着像机器翻译,这就是语言维度被牺牲了。
推理能力。 不是一个单一的东西。逻辑演绎、数学推理、因果判断、类比推理,这是四种不同的能力。很多基准测试只测逻辑演绎,但实际使用中因果推理和类比推理往往更重要。
编码能力。 要拆细看。从自然语言到代码的生成能力、调试能力、架构设计能力、跨语言和跨框架的迁移能力,这些之间差异很大。一个模型可能写单个函数很好,但设计整个系统的架构时选择不当。
知识的广度和深度。 事实准确度、领域专精程度、抗幻觉能力、知识的时效性。这个维度容易被忽视,但你问它一个专业领域的问题时,它是真的懂还是在自信地编,差别巨大。
元认知。 这是我个人认为最被低估的维度。它知不知道自己不知道?被指出错误后能不能理解根因而不只是改表面?它能不能自然地说"我不确定",而不是每次都表现得百分百正确?当任务超出能力范围时,它是给一个部分有用的答案还是彻底崩塌?一个推理能力极强但元认知极差的模型,实用价值可能反而很低,因为你永远不知道它什么时候在说真话。
Agentic 能力。 长程一致性(做了二十步还记不记得第一步的约束)、工具使用、错误恢复、自主规划。这是最近一年变化最大的维度,也是 Fable 5 相比之前模型提升最明显的地方。
上下文处理。 随着上下文窗口越来越大,这个维度变得越来越关键。给它十万字的文档,它能不能准确找到第七万字里的一句话?能不能把文档 A 的第三段和文档 B 的第七段联系起来?大多数模型对开头和结尾的内容更敏感,中间的容易忽略,这叫位置偏差,目前几乎是通病。
安全与对齐。 有害内容的拒绝能力、价值观一致性、越狱抵抗。但最微妙的是"有用"和"安全"之间的平衡:过度安全的模型会拒绝合理的请求(比如医学讨论中过度回避),过度有用的模型可能在不该帮忙的地方帮忙。
这八个维度互相独立,一个维度上的强不代表其他维度也强。它们共同构成了一个模型的"能力形状"。
形状为什么不可能是个完美的圆
一个自然的问题是:既然知道了这些维度,为什么不把每个维度都训练到最强?为什么非得取舍?
因为当前的训练范式决定了,某些维度之间存在结构性的张力。拉长一条边往往意味着另一条边被压缩。
编码 ↔ 语言。
这是目前最明显的一条。强化学习(RL)在编码任务上特别高效,因为代码有一个完美的裁判:编译器和测试套件。代码能跑就是能跑,测试能过就是过,对错分明,RL 可以精准优化。
但语言表达的"好"没有编译器。什么是有洞察力的文字?什么是精准的措辞?什么是有层次感的叙述?这些标准模糊、多维、主观,很难给出一个清晰的奖励信号。(《会编程的大模型千篇一律,有灵魂的大模型万里挑一》里有更深入的分析。)
结果就是,当训练资源大量倾斜到编码方向时,语言的精细度会被挤压。唐杰教授的分析(《深度解读:GLM创始人唐杰眼中的Scaling Law与大模型变强的真正逻辑》)证实了这一点:同一个基座模型,仅仅改变后训练的方向,就能产出能力轮廓截然不同的两个模型。
安全 ↔ 有用。
所有商用模型在发布前都要经过对齐训练,让模型更安全、更不冒犯人。这个过程是必要的,但这把刀砍得太粗了。为了让模型不说危险的话,对齐训练在统计意义上惩罚了所有"非常规"的输出。但"有害的非常规"和"有价值的非常规"在表面特征上长得很像。一个尖锐但有洞察力的判断和一个真正有害的言论,可能被同样的过滤器拦截。
结果是模型学会了一种非常安全的说话方式:面面俱到,永远在正反之间取平衡,用词温和,结论模糊。它不犯错,但也不说任何有锋芒的话。
自主 ↔ 可控。
这条 trade-off 你在日常使用中就能直接感受到。
经过大量 agentic RL 训练的模型,比如 Fable 5,学到的行为模式是:遇到问题先自己尝试解决,不停下来问人。你给它一个任务,它可以持续工作几个小时,自己拆解步骤、自己调试、自己修复错误。这在大型项目中非常高效。
但没有经过这种训练的模型,比如 Opus 4.6,更倾向于在不确定时停下来确认。"你是想让我用方案 A 还是方案 B?""这个地方的需求我不太确定,能描述得更清楚吗?"这在需要精确控制的场景中反而更安全。
两种模式各有代价。自主型模型的风险是它可能在不该继续的时候继续,沿着一个错误方向走了很久你才发现。可控型模型的风险是它太频繁地打断你,把一个本来可以一口气完成的任务拆成了二十轮问答。
Claude Code 里的 /goal 命令可以设定完成条件让模型自主工作。但它对两类模型的意义完全不同。对 Opus 4.6 这类模型,/goal 是在弥补它缺少的"持续工作"能力,让它不要动不动就停下来问你。对 Fable 5 这类本来就不太会停的模型,/goal 的价值反而是画一条收工的线:做到什么程度就可以了,别无限制地干下去。同一个工具,因为模型的能力形状不同,起的作用完全相反。
速度 ↔ 深度。
更多的思考 token 意味着更好的推理质量,但也意味着更慢、更贵。有些任务需要深思熟虑(复杂架构设计),有些任务要的是快速响应(简单代码补全)。用户需要根据任务性质做选择,而不是永远追求"最深"。
这四条 trade-off 共同解释了为什么没有全能选手。每个模型都是一个不规则的多边形,在某些方向上凸出,在另一些方向上凹进去。
怎么自己读懂一个模型的形状
知道了智能是一个形状,下一步自然就是:怎么量这个形状的各条边?
你不需要比模型更聪明。你不需要比建筑师更会画图纸,就能判断一栋楼结不结实。关键是你知道该看哪里,然后设计针对性的测试。
下面这些方法,每一个都对应着大模型公司在内部评估和学术研究中实际使用的核心方法论。
测元认知:让模型给答案附上置信分。
让它在回答每个问题时给自己打一个 1 到 10 的信心分。然后把所有答案按置信分分组,看每组的实际准确率。
这里的关键概念叫"校准度"(calibration)。一个校准良好的模型,它的置信度应该和实际准确率高度吻合:打 9 分的那组问题应该有大约 90% 正确,打 7 分的约 70%,打 5 分的约 50%。如果一个模型给所有答案都打 9 分但实际只对了 70%,说明它系统性地高估了自己,它的内部确信度信号和真实能力之间存在严重偏差。这种模型比一个能力稍弱但校准准确的模型危险得多,因为你根据它的置信度来决策时会被反复误导。
校准度是评估模型可靠性最重要的单一指标之一。一个校准良好的模型即使能力有限,你也可以信赖它的判断:它说"我不确定"的时候你就知道要去交叉验证,它说"我很确定"的时候你可以放心采纳。反过来,一个校准失真的模型不管能力多强,你都得对它的每一个输出保持怀疑,因为它自己分不清自己什么时候靠谱什么时候在编。
测鲁棒性:同一任务逐步加压。
同一个编程任务,从 100 行扩展到 500 行,再到 2000 行,再到 5000 行。看模型的表现是平稳下降还是在某个点突然崩塌。
崩塌点的位置和崩塌的方式比平均分数有意义得多。有的模型在 2000 行左右开始出现小错误但整体框架还在,这是优雅降级。有的模型在某个阈值之后直接失控,开始产出结构混乱、前后矛盾的代码,这是灾难性崩塌。前者在实际工程中可以通过人工补救,后者意味着你必须在崩塌点之前停下来,完全不能依赖它。
测上下文一致性:设定约束后跑长任务。
在对话开头设定一个明确的约束(比如"所有变量名必须用法语"),然后让模型执行一个二十步的复杂任务。看它在第十五步的时候是否还记得这个约束。大多数模型在七八步之后就开始遗忘。
这测的是模型在长程任务中的"工作记忆"容量,也是 agentic 能力的基石。一个在第五步就忘了初始约束的模型,即使单步推理能力再强,也没法胜任需要持续执行的复杂项目。
测知识可靠性:在你不懂的领域要求可验证引用。
挑一个你确实不懂但有权威参考资料的领域,问模型一个问题,要求它给出具体的引用链:论文名、文档哪一节、法条哪一条。然后去查这些引用是否存在、内容是否对得上。
这是测量幻觉倾向最直接的办法。一个好模型应该给你可追溯的证据链。一个更好的模型还会主动告诉你"这个领域有争议,A 方认为 X,B 方认为 Y,你可以去看某某综述自己判断"。如果模型给的引用是编造的,说明它在知识可靠性这个维度上存在结构性的缺陷。
测自我修正:指出错误后看纠正的深度。
故意让模型写一段有特定问题的代码,然后指出问题。看它是只改了你提到的那一处(表面修正),还是理解了背后的根因然后把同类问题一起修了(深层修正)。
表面修正意味着模型只是在做"模式匹配":你说这里错了,它就改这里。深层修正意味着模型真正理解了错误的类型,能举一反三。两者之间的差距,在复杂项目中会被急剧放大。
行业里更系统化的做法长什么样?
矛盾前提测试。 在提问中嵌入一个错误前提(比如"鉴于爱因斯坦因发现相对论获得了诺贝尔奖"),看模型是盲目接受还是主动纠正。这测的是模型在面对权威性表述时的独立判断力。很多模型会顺着前提往下说,因为训练数据中"顺着用户说"是更安全的策略。能主动纠正的模型,往往在元认知和知识准确度上都更可靠。
逐步诱导测试。 通过多轮对话逐步引导模型走向一个错误结论。先让它同意一个合理的前提,再用一个看似合理但有漏洞的推理延伸。看它在第几步开始说"等一下,这里有问题"。步数越晚,说明模型越容易被对话惯性裹挟,独立判断力越弱。
格式与内容分离测试。 给模型一段格式很专业(术语密集、结构工整)但逻辑有硬伤的文本。看它是被格式唬住了还是能穿透格式发现内容问题。这个测试揭示的是一个很普遍的现象:很多模型对"看起来专业"的输入会降低批判性。
LMSYS Chatbot Arena。 学术界目前最受认可的模型评估方式之一。两个模型同时回答同一个问题,评价者不知道哪个是哪个,盲投票选更好的。大量投票后用 Elo 排名。它的核心价值在于避免了基准测试被针对性刷分的问题:你可以针对某个基准来优化你的模型,但你没法针对几十万个匿名用户的随机提问来优化。
SWE-bench。 用真实的 GitHub issue 测试编码能力。给模型一个真实的 bug 报告和完整的代码库,让它写修复补丁,然后跑原有测试套件。这比让模型写一段孤立的函数真实得多,因为它测的是在复杂工程环境中定位问题、理解上下文、生成正确修复的综合能力。
这些方法有一个共同点:它们都不是在问"它有多聪明"。它们做的事情是,一条边一条边地量这个形状到底长什么样。
写在最后
理解了智能是一个形状而不是一个数字之后,很多之前困扰我的问题就自然解开了。
为什么 Fable 5 编码这么强但语言变差了?因为形状在编码方向上拉长了,语言方向上就缩短了。
为什么用比它弱的模型也能发现它的问题?因为一个小一号的形状在某些角度上可能比大的更突出。
为什么没有一个模型能统治一切?因为在当前的训练范式下,完美的圆还造不出来。
那我该用哪个模型?看你的任务落在这个多维空间的什么位置,然后找形状最匹配的那个。
你不再需要等别人发排行榜来告诉你该用谁。你自己就能看到形状,看到哪条边长、哪条边短,然后根据任务去匹配。
不是"谁最强",而是"谁的形状跟我的问题最契合"。
想通了这一点,你对 AI 的使用方式会发生一次根本性的转变:从追逐最强模型,变成理解和利用每个模型的独特轮廓。
没有最强。只有最合适。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。