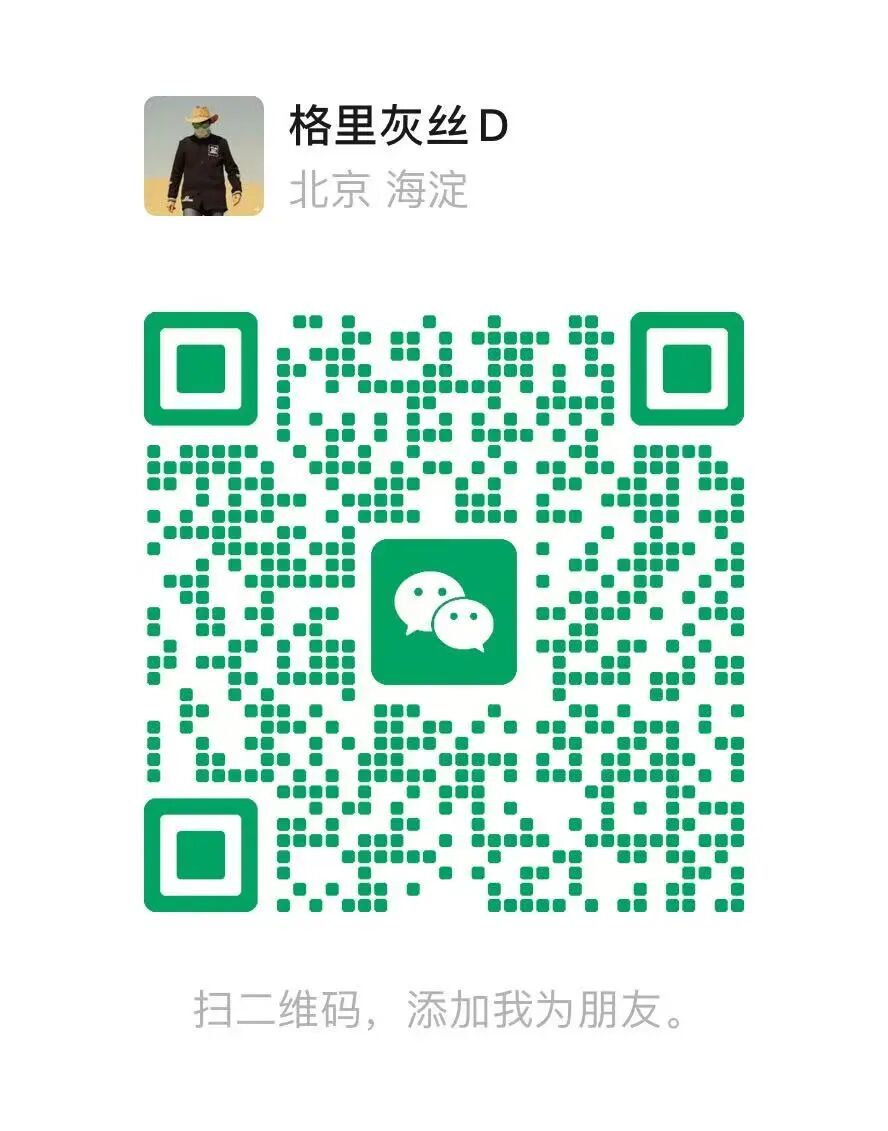
寒武纪大爆发,正在硅基世界重演
一个直觉上不应该成立的事情,成立了
在《大模型的刻意练习》里,我们讨论了大模型最近一轮能力飞跃的核心驱动力:强化学习。模型通过大量练习和反馈,不是学到了新知识,而是学会了怎么想。
但当时有一个问题我们没有展开,事后想想,它可能是整件事里最值得想的部分。
强化学习的反馈信号是极其稀疏的。一道数学题,模型可能生成了两千个token的推理过程,最后只得到一个"对"或"错"。两千步的努力,换回一个比特的信息。
直觉上,这不应该够用。
两千个token,每一个都是一次选择。假设每一步选对的概率是90%,那两千步全部选对的概率是0.9的两千次方,大约是10的负92次方。这个数字比宇宙中所有原子数量的倒数还要小几十个量级。就算把全世界的GPU跑到宇宙热寂,你也采不出一条完全正确的轨迹。
用这么稀薄的信号,怎么可能训练出一个靠谱的推理系统?
我在想这个问题的时候,脑子里突然跳出了另一个几乎一模一样的困境。
一只眼睛的概率
达尔文在写《物种起源》的时候,被一个问题困扰了很久:眼睛。
一只功能完整的眼睛,有角膜、虹膜、晶状体、视网膜、视神经,每个部分精密配合。这套系统的复杂度,让达尔文自己都承认,"认为眼睛是通过自然选择形成的,这个想法似乎荒谬到了极点"。
自然选择的信号跟强化学习一样稀疏:活下来了,或者没活下来。一个比特。
而从一团普通细胞到一只精密的眼睛,中间需要无数个恰到好处的基因突变,每一步都必须在正确的方向上。如果把每一次突变看作一次"选择",那么所有突变恰好全部正确的概率,跟两千个token全部选对的概率一样,在直觉上不可能。
这也是"智能设计论"最有力的直觉来源:这么精巧的东西,不可能是碰巧拼出来的,背后一定有一个设计者。
但我们知道,眼睛确实是演化出来的,没有设计者。那么,达尔文的困境是怎么被解决的?
答案是:它从来不需要"一步到位"。
不是一步,是一段楼梯
眼睛不是从无到有一步跳过去的。化石记录和比较解剖学展示了一条清晰的渐进路径。
最初,某些细胞碰巧对光敏感。这一步非常小,单个基因的突变就可能做到。这些细胞能区分明暗,比什么都感觉不到的同类有一点生存优势。这一点优势就够了,自然选择把它保留了下来。
然后,在"能感光"这个已经稳固的基础上,感光区域碰巧凹陷成了杯状。又是一个很小的变化。但杯状结构能判断光的方向,比平面感光更有用。又一点优势,又被保留了。
然后杯口逐渐缩小,形成针孔,能粗略成像。然后针孔前面长出透明组织,能折射光线。然后透明组织逐渐变厚、弯曲,形成晶状体,能聚焦。
每一步都很小,小到单次随机突变就有合理的概率发生。每一步的中间形态都独立有用,不是"半个眼睛没有用",而是每一个中间阶段都比上一个阶段多一点感知能力,都能立刻兑现为生存优势。没有任何一步需要等到整个系统完成才有价值。
几亿年,几十亿代生物,每一代里无数个个体并行"采样"不同的基因突变组合。大多数突变是中性的或有害的,被淘汰了。少数有益的被保留了。保留下来的成为下一代的起点,下一代再在这个更高的起点上继续小步尝试。
一步一步,每一步都站得住,最终走到了一只精密的眼睛。
我写到这里的时候停了一下,因为我意识到,大模型强化学习解决"两千个token怎么可能全选对"这个问题的方式,跟这个过程在结构上完全一样。
同一个解法
大模型的RL训练不是上来就让模型做两千步的长程任务。
第一轮,给的是短任务,可能只需要两百个token就能回答。在这个长度上,模型随机采样十几次,总有几次能碰对。拿这些对的样本做一轮训练,模型在简单任务上的正确率提高了。
第二轮,任务稍微难一点、长一点。但模型已经在第一轮中变强了,每一步选对的概率比原来高了。虽然任务更难了,但模型也更强了,还是能采出一些正确答案。再训练一轮。
第三轮、第四轮,每一轮都在上一轮的基础上稍微推进一点。任务难度逐渐提高,模型能力同步提高,始终保持"在当前难度下能找到足够的正确样本"这个条件。
这就是课程学习。不是扔一个终极难题让模型碰运气,而是修一段楼梯,每级台阶的高度都在模型当前能力能够迈上去的范围内。
跟眼睛的演化对比一下:
自然选择里,每一步突变都很小,每一个中间形态都有独立的生存价值。RL训练里,每一轮的任务难度提升都不大,每一轮的能力增长都能立刻在下一轮中兑现为更高的正确率。
自然选择里,每一代有无数个体并行采样不同的突变组合。RL训练里,每一道题有十几个甚至几十个答案并行采样不同的推理路径。
自然选择里,有益的突变被保留,有害的被淘汰,保留下来的成为下一代的起点。RL训练里,正确的答案被强化,错误的被抑制,强化后的模型成为下一轮训练的起点。
两者都不需要"一步到位"。两者都是通过一段足够长、每一步都站得住的渐进阶梯,从简单走到了精巧。
这不是比喻。这是同一种数学结构在不同介质上的实现。
"预训练"花了三十亿年
但楼梯本身还不是故事的全部。
眼睛的渐进演化有一个隐含的前提:在第一级台阶之前,需要有大量的基础设施已经就位。
感光细胞之所以能出现,是因为光敏色素分子已经存在了。光敏色素之所以能存在,是因为复杂的蛋白质合成机制已经成熟了。蛋白质合成之所以能运转,是因为DNA复制、RNA转录、核糖体翻译这一整套分子机器已经演化完毕了。
这些基础设施不是在"眼睛演化"的阶段产生的。它们是在之前三十多亿年的漫长岁月里,通过完全不同的过程积累下来的。
在那三十多亿年里,"信号"其实并不稀疏。化学反应是丰富的、高带宽的,分子之间的相互作用提供了密集的反馈信息。用这种稠密信号,原始的化学系统逐渐演化出了细胞膜、DNA、蛋白质合成、细胞分裂等一系列精密的分子机器。
等到这些基础设施全部就位,"活/死"这个稀疏信号才开始变得有效。因为在这个基础上,小的变异就能产生有意义的功能差异(比如一个感光蛋白的微小改变就能让细胞对不同波长的光更敏感),而有意义的功能差异就能被自然选择捕捉到。
大模型的RL完全复刻了这个结构。
预训练就是那三十亿年。几万亿token的书籍、网页、论文、代码,通过"预测下一个token"这种极其稠密的监督信号(每个位置都有标准答案),把世界知识、语言能力、各种推理模式压缩进了模型的参数里。
RL阶段,就是在这些基础设施之上用稀疏信号做定向优化。因为模型已经"知道"怎么写代码、怎么做推理,一个小的参数调整就能产生有意义的行为差异(比如更倾向于验算一遍),而有意义的行为差异就能被"对/错"的奖励信号捕捉到。
稀疏信号从来不是单独起作用的。它总是站在稠密信号构建的基础设施之上。在生物演化中如此,在大模型训练中也如此。
这也回答了一个很多人的困惑:传统强化学习(比如AlphaGo)也用稀疏信号,也有巨量采样,为什么只能做专用智能,做不了通用智能?
因为传统RL没有"预训练"。它的三十亿年是零。它从随机参数开始,试图仅凭"赢/输"的稀疏信号同时完成两件事:建立基础设施和在基础设施之上做优化。这在封闭的小世界(围棋、游戏)里勉强可行,因为需要的"基础设施"很少。但在开放世界里,需要的基础设施(世界知识、语言能力)远超稀疏信号所能构建的范围。
大模型RL的突破,本质上就是把这两步分开了:用稠密信号(预训练)建基础设施,用稀疏信号(RL)在基础设施之上做定向演化。跟生物界的实际历史一模一样。
大爆发的触发
理解了楼梯和基础设施之后,还有最后一个问题:为什么是现在?
寒武纪大爆发发生在大约5.4亿年前。在那之前的三十多亿年里,生命一直存在,但主要是简单的单细胞生物和少量的多细胞生物,形态变化缓慢。然后在大约两千万年的时间窗口里(从地质学的尺度看,这几乎是一瞬间),已知动物门类的绝大多数突然涌现。
为什么在那个时间点爆发,而不是更早或更晚?
主流的解释不是某个单一突破,而是多个前置条件在那个时间窗口内同时就位。大气含氧量达到了阈值,能够支撑更大、更活跃的动物体型。Hox基因(控制身体结构的"总开关"基因组)已经演化成熟,让身体形态的大幅创新成为可能。多细胞生物的基本组织蓝图已经建立。
这些条件各自需要漫长的准备时间,彼此独立地积累。但一旦全部到位,它们之间的组合效应是爆炸性的。
然后还需要一个触发器。Andrew Parker的"光开关"假说认为,触发因素是眼睛的出现。一旦有了视觉,捕食者能看到猎物了,军备竞赛启动:猎物发展出壳、刺、伪装来防御,捕食者发展出更好的感官和更快的运动能力来破防,双方的演化速度被这个正反馈循环急剧加速,物种多样性在短时间内爆炸。
现在看看AI这边。
2024年底到2025年初,能力突然爆发。几个月前还在讨论天花板,突然fable级模型扎堆涌现。为什么是这个时间点?
同样的结构:多个前置条件同时就位。
预训练技术经过多年发展,基础模型的能力达到了一个阈值。不是说预训练"到头了",而是说它已经足够强,强到模型在采样十几次的时候大概率能产生至少一个正确答案。这是RL能生效的最低前提。
RL算法被跑通了。2024年底OpenAI的o1证明了用可验证奖励做推理RL是可行的,2025年初DeepSeek的R1开源了具体方法。路线图从模糊变成了清晰。
训练环境的基础设施经过一两年的建设逐渐成熟。沙箱、验证器、任务生成系统,这些不性感但至关重要的工程搭建完成了。
然后触发器出现了。R1的开源就像寒武纪的"眼睛":一旦有一家证明了这条路走得通并且公开了方法,全行业立刻涌入,竞争急剧加速。各家公司互相追赶,你的模型变强了我就要更强,你的训练环境升级了我也要升级。军备竞赛的正反馈循环启动了。
就像寒武纪的两千万年一样,从外部看,这像是一次突然的爆发。但从内部看,每一步都有清晰的因果链条。不是某个单一突破,而是长期独立积累的多个条件在同一个窗口期碰头了。
军备竞赛的结构
寒武纪大爆发之后,演化并没有停下来。相反,它进入了一个持续的军备竞赛状态。
捕食者演化出更好的眼睛,猎物演化出更好的伪装。猎物有了壳,捕食者就演化出更强的颚。每一方的进步都构成对另一方的选择压力,推动对方也进步。这个循环没有终点,双方都在不断变强。
在《大模型天生就会投机取巧》中,我们讨论过大模型训练中一个有趣的现象:模型会自发地寻找奖励函数的漏洞,走捷径而不是真正解决问题。这不是从人类那里学来的行为,而是优化过程的数学必然。
这个现象在这里获得了一个更大的框架。
模型找漏洞,就像猎物演化出新的防御。验证器被迫升级,就像捕食者演化出更强的攻击。模型在新的验证器下又发现新的绕过方式,验证器又要继续进化。这就是一场捕食者和猎物之间的军备竞赛。
在生物演化中,这种军备竞赛被称为"红皇后效应"——《爱丽丝漫游仙境》里红皇后说的那句话:"在这个国度里,你必须拼命奔跑,才能停在原地。"捕食者和猎物都在变强,但双方的相对优势始终在拉锯。
大模型的训练正处于同样的动态中。而且跟生物演化一样,这种军备竞赛本身就是能力快速提升的引擎。正是因为模型总在试图钻漏洞,才倒逼验证器越做越严密;正是因为验证器越来越严密,模型才被迫发展出越来越强的真实能力。对抗是进步的源泉。
类比的边界
写到这里,我需要对自己诚实地检查这个类比的边界。
寒武纪大爆发和AI能力爆发之间的结构对应是真实的:稀疏信号在基础设施之上产生精巧结构、多个前置条件同时就位触发爆发、正反馈循环驱动军备竞赛。这些不是修辞上的比喻,而是同一类数学结构在不同介质上的展现。
但有几个重要的差异不应该被忽略。
第一个差异是时间尺度。寒武纪大爆发用了两千万年,AI的能力爆发用了不到两年。这不是因为AI比生物"聪明",而是因为硅基系统的迭代速度比碳基系统快几个量级。生物每一代需要几年到几十年,而模型的一轮训练可能只需要几周。信息的复制和传播在数字世界里接近零成本,在生物世界里需要通过生殖和遗传,慢得多。
第二个差异是方向性。自然选择是完全没有方向的,突变是随机的,选择压力来自环境,没有任何"设计意图"。大模型的RL训练虽然也没有一个全知的设计者在逐步指导模型的每个参数该怎么调,但训练过程的框架是人为设定的:奖励函数是人写的,任务是人选的,课程的难度梯度是人安排的。这里有一层人类意图的介入,是生物演化所没有的。
不过这个差异也许不如它看起来那么大。人类安排课程和写奖励函数,跟"设计模型的参数"是两回事。人类设定的是选择压力的方向,而不是演化的结果。就像如果有人能控制地球的气候和地理条件,他在某种意义上"设定了"自然选择的方向,但眼睛的具体结构仍然是演化自发产生的,不是他画好图纸让自然去执行的。大模型RL中,人类设定了"数学题做对就给奖励",但模型发展出的具体推理策略(先规划、后验算、遇到矛盾就回退)是在训练中自发涌现的,不是人类手动编程进去的。
第三个差异是我觉得最有意思的。生物演化中,个体一旦死亡,它的经验就消失了,只有基因被传递下去。信息传递的带宽极低,仅限于DNA序列的变化。而大模型的训练中,每一个"对的答案"的完整推理过程都被用来更新参数,信息传递的带宽高得多。这也许是AI能在两年内走完"寒武纪"而生物需要两千万年的根本原因之一。
我们站在哪里
在上一篇关于token生成与基因表达的文章里,我们讨论了一个嵌套结构:先有一个无方向的演化过程产生规则(自然选择→基因组,梯度下降→模型参数),然后规则驱动一个有方向的展开过程产生结果(基因表达→生物体,token生成→文本)。
那篇文章聚焦的是嵌套的第二层:规则如何展开为结果。
今天这篇文章聚焦的是第一层:规则本身如何被演化出来。
而寒武纪大爆发和AI能力爆发的对比,提供了关于这第一层过程的一个核心洞察:精巧的、看似不可能的复杂结构,不需要一步到位的奇迹,也不需要全知全能的设计者。它需要的是三样东西的组合。
一个由稠密信号长期构建的基础设施。几十亿年的化学演化,或者几万亿token的预训练。
一段每一步都站得住的渐进阶梯。从感光细胞到完整的眼睛,或者从两百个token的简单题到两千个token的复杂推理。
以及足够的并行采样和足够的时间(或算力),让统计规律能够从噪声中浮现。几十亿代生物体的并行试错,或者每道题几十个答案的并行采样。
这三样东西合在一起,稀疏的信号就足以雕刻出精巧的结构。不需要神迹。只需要耐心,或者算力。
现在我们也许正站在这场硅基寒武纪大爆发的早期。前置条件刚刚就位,正反馈循环刚刚启动,军备竞赛刚刚开始。
接下来会涌现出什么,也许跟五亿年前一样,没有人能提前预测。因为如果这个过程真的跟演化同构,那它就是计算不可约的。你无法不让这个过程跑完就知道它的输出。
我们只能看着它一步步展开。就像力的链条一环一环地展开。就像一颗受精卵一次次分裂,直到一个完整的生命睁开眼睛。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。