试错守恒定律(续)| 直接做事还是造机器?
一、我遇到了一个问题
之前文章我写了试错守恒定律:解决任何问题都有一个客观存在的试错总量,这个总量不能消灭,只能转移。它可以被预训练提前支付,可以在运行时用 token 当场支付,也可以由你本人的判断力来支付。但不管怎么付,总量不变。
写完之后我自己就碰到了一个活生生的案例。
我在开发一个系统,用来生产某个专业领域的分析报告。想法很简单:我把写报告的知识和流程固化到系统里,以后每次出报告就不用从头想了,喂进去数据,报告就出来。
听起来很美好。但做着做着我发现一个让人很不安的事情。
这个系统不是自己会写报告。它是我一条一条地写规则,告诉它"遇到这种数据应该怎么分析"、"这段结论应该怎么措辞"、"这个指标超过多少要发出警告"。每一条规则都要我自己想清楚、写清楚。花了很大力气,终于把一个方向的报告跑通了。
然后我想,那换个方向的报告试试?
结果发现,系统不会了。它只会写我已经写好规则的那一个方向。换一个方向,我得重新再写一套规则。而写这套新规则的精力,跟我直接手写一份那个方向的报告差不多。甚至更多,因为我不仅要想清楚报告该怎么写,还要把这些想法翻译成系统能理解的指令。
这让我非常困惑。
我造了一个模具,但这个模具只能生产一种杯子。如果我想生产第二种杯子,我得再造一个新模具。造新模具的成本跟直接手工捏一个杯子差不多。那我造模具的意义在哪?
更让人不安的是一个推到底的追问:如果每写一个方向的报告都要我重新写一套规则,那这个系统本质上就不是一台机器,它只是一个壳子。真正在"生产"报告的还是我。我只是把原来直接写报告的精力,换了一种形式,变成了写规则。产出没变,工作量没减,只是工作的样子变了。
我到底是在造一台生产报告的机器,还是在用一种更复杂的方式手工写报告?
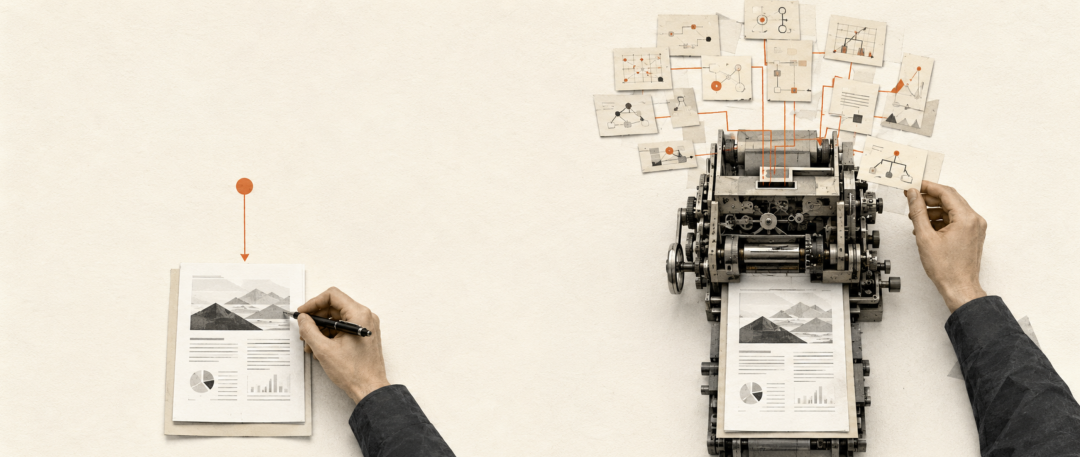
这个困惑让我意识到,之前文章的守恒定律虽然回答了"试错总量不变"这个问题,但还有一个紧接着的问题没有回答:既然总量不变,那你应该把试错花在"直接做事"上,还是花在"造一台做事的机器"上?
什么时候该直接做,什么时候该造机器?
二、直接做和造机器,到底差在哪
先把这两件事的区别想清楚。
你直接写一份报告,产出的是一份报告。写完了就完了。下次再写,你还得再花差不多的精力。你的知识留在你脑子里,每次用的时候现取现用。
你造一个系统来写报告,产出的不是一份报告,而是"写报告的能力"。这个能力被固化在系统里了,以后每次出报告,系统替你承担一部分工作,你不用再从零开始。
所以直接做是按次付费,做一次付一次。造机器是预付一大笔,然后希望以后每次用的时候摊薄回来。
这笔账算起来好像很简单:如果以后要出的报告足够多,造机器就值;如果只出几份,直接写就好。
但我的困惑比这更深一层。不是报告出得少所以不值,而是我每换一个方向的报告,就得重新投入跟直接写差不多的精力去写规则。如果是这样,那不管我未来出多少份报告,造机器都不会比直接写更省力。因为每一份都是重新来过的。
摊薄的前提是前期投入能被后面复用。如果每次都是重新投入,就没有什么可摊的。这才是真正让我不安的地方。
三、造机器为什么比直接做还累
因为造机器的时候,你在同时做两件事。
第一件事,是你本来就要做的:想清楚这份报告该怎么写。数据该怎么处理,结论该怎么推导,措辞该怎么拿捏。这件事不管你直接写报告还是造系统,都得做。
第二件事,是额外的:你得把你脑子里那些模糊的、下意识的判断,翻译成明确的、系统能执行的规则。
这第二件事的成本非常大,大到很多人低估了它。
你直接写报告的时候,你的很多判断是不经过意识的。你看一眼数据就知道"这里应该强调一下",你写到某段话自然就知道"这里得保守点"。这些判断在你脑子里是压缩过的,你不需要解释它们,直接用就行了。
但当你要把它们变成规则的时候,你必须把每一条都掰开揉碎。"这里应该强调一下"变成了"当指标A同比增长超过20%且绝对值超过某个阈值时,在结论段落中使用加重语气"。一个你两秒钟就能做出的判断,翻译成规则可能要花两个小时。
这就是你觉得造机器反而更累的原因。你不仅在做报告,你还在做一件更难的事:把"你是怎么做报告的"这件事讲清楚。
用之前文章的语言来说:直接做报告,你只需要支付"做这件事"的试错成本。造机器,你需要同时支付"做这件事"和"解释你是怎么做这件事"两笔试错成本。第二笔是额外的,但不是浪费的。因为这笔成本付完之后,"你是怎么做报告的"这份知识就不再只存在于你脑子里了,它被搬到了系统里,可以脱离你独立运转。
问题是:它真的能脱离你独立运转吗?
四、你造的是全自动机器还是半自动机器
这是一个必须诚实面对的问题。
全自动机器是什么?你把原料放进去,产品直接出来,不需要人盯着。一个饮料自动售货机就是全自动的,你投币按按钮,饮料就掉下来,不需要一个人站在机器后面帮你拿。
半自动机器是什么?机器能帮你干一部分,但关键环节还需要人来操作。洗衣机就是半自动的(至少早期是),它能洗,但你得手动把衣服从洗涤桶搬到脱水桶。
判断你造的是全自动还是半自动,有一个特别简单的测试:如果你把这个系统交给一个不懂这个领域的人,他能不能用它产出一份合格的报告?
如果能,说明你的判断力已经被完整地固化进了系统。系统自己就能做决策。这是全自动。
如果不能,说明系统只是帮你分担了一部分执行工作,核心判断还得靠你。这是半自动。
我的系统目前是半自动的。计算流程它能自己跑,但到了需要专业判断的地方,还得专业人员介入。比如"这组数据的异常到底是噪声还是真实信号",系统判断不了,得人来看。
这不是什么丢人的事。大部分机器一开始都是半自动的。但你得对自己诚实:如果你在造一台半自动机器,你不应该期待它像全自动一样省力。半自动机器的价值不是让你消失,是让你把精力集中在最需要判断力的地方,把不需要判断力的重复劳动交给机器。
而从半自动到全自动,靠的是什么?靠的是你不断地往系统里加规则、加知识,把越来越多的判断固化进去。这个过程就是你持续支付"翻译费"的过程。每多翻译一条判断,系统的自动化程度就高一点。
五、一个杯子还是一万个杯子
回到最开始的困惑。我觉得造机器不值,核心原因就是那个让人不安的感觉:每换一个方向的报告,我就得重新写一套规则,而写规则的精力跟直接写报告差不多。所以不管未来有多少报告要出,每份都是重新来过的,机器根本摊不了薄。
这个逻辑听起来很对。但后来我发现它有一个隐藏的错误:我把"一份报告"当成了最小的计数单元。
我之所以觉得"每份都是重新来过的",是因为我站在"一份报告"的层面看问题。从这个层面看,确实,A 方向的报告和 B 方向的报告是两个不同的东西,规则没法复用。
但如果我往下看一层呢?
仔细想想,一份报告里面有什么?有数据清洗、有统计计算、有趋势分析、有结论推导、有风险提示、有措辞规范。这些不是一个整体,它们是一个个独立的模块。
这些模块里面有很多是跨方向通用的。不管我写哪个方向的报告,数据都要清洗,计算逻辑都是类似的,报告的组织框架大同小异,异常值的处理方式也差不多。这些模块在每一份报告里都会出现,不管方向怎么变。
所以我不是只做了一个杯子。我做的是杯子上的花纹、杯壁的弧度、杯底的结构。这些零件在每一种杯子里都要用到。我以为我只做了一种产品,其实产品内部的很多零件是通用的。
这就引出了一个很关键的观点:判断该不该造机器,不能看最表面的那个层次。你不能看"我做了几种报告"就下结论,你得看"我的报告里面,哪些模块是不管方向怎么换都要用到的"。
"最小重复单元"在哪一层,机器就应该造在哪一层。
很多人在判断该不该造机器的时候犯的错误,就是找错了这个最小重复单元。他们看到的是最显眼的层面(一份报告、一个产品、一个项目),觉得"就这么一个,不值得"。但真正在重复的东西藏在更深的层面(计算逻辑、组织框架、表达模式),而那些东西出现了成百上千次。
六、两个桶
如果你想搞清楚自己造的机器到底值不值,有一个特别简单的操作。
把你写过的每一条规则,分到两个桶里。
第一个桶:不管写什么方向的报告都适用的规则。比如"数据要先清洗再分析"、"结论必须有数据支撑"、"异常值要单独说明原因"、"报告要先说核心发现再展开细节"。
第二个桶:只对当前这个特定方向有效的规则。比如"当某个行业指标超过某个阈值时意味着存在某种风险"、"这个领域的报告结论段落习惯使用某种特定措辞"。
第一个桶里的东西就是你这台机器真正的核心。这部分是你固化下来的通用能力,换任何方向都不用重写。
第二个桶里的东西是每个方向的个性化成本。换方向就得重新写,省不掉。
你的机器值多少,取决于第一个桶占多大比例。
如果第一个桶占了70%,那你的系统非常有价值。以后每做一个新方向的报告,你只需要重新写30%的规则,剩下70%已经在那了。
如果第一个桶只占20%,那你的系统价值就有限。每换一个方向你还是得重做80%的工作,系统只帮你省了一小部分。
而且第一个桶和第二个桶的边界不是固定的。你以为某条规则只适用于当前方向,但仔细想想,它的底层逻辑可能是通用的,只是表面措辞是专用的。把专用的措辞剥掉,露出通用的逻辑,这条规则就可以从第二个桶搬到第一个桶里去。这个"剥离"的过程本身也是一种试错,需要你对领域有足够深的理解。
七、跃迁
在造这个系统的过程中我还观察到了一个现象,一开始我没太在意,后来觉得这个现象背后有一个很重要的规律。
一开始往系统里加规则的时候,效果是线性的。加一条规则,系统多覆盖一种情况。加十条,多覆盖十种。投入和产出成正比,没什么惊喜。
但加到某个程度之后,情况变了。系统开始能处理一些我没有专门写规则去覆盖的情况。我给它一组新的数据,本来以为它会卡住,结果它居然给出了一个还算靠谱的分析。我翻了翻规则库,并没有一条规则直接对应这个情况。
它不是瞎蒙的。它是用已有规则的组合,兜住了一个新情况。
A 规则说"增长率异常要标注"。B 规则说"连续三期趋势一致时可以给出方向性结论"。C 规则说"结论要区分强信号和弱信号"。这三条规则各管各的,但当它们在某个新数据上同时被触发的时候,它们的交叉效果恰好覆盖了一种我没有预设过的分析场景。
这就像学做菜。你一道一道地学,宫保鸡丁、鱼香肉丝、麻婆豆腐,每道菜都是独立的。但学了五十道之后,你突然发现你能做第五十一道了,虽然没人教过你。因为那五十道菜里包含的技法,过油、勾芡、调火候、配酱汁,已经足够丰富了。它们的组合可以覆盖你没见过的新菜。
你没有学到一个新东西。你是积累到了一个临界点,旧东西的组合开始产生新能力。
这个现象有一个特征:它不是渐进的,它是突变的。在临界点之前,系统就是一个死板的模板,你让它做什么它才能做什么。过了临界点,它突然有了某种程度的"灵活性",能应对你没有预设过的情况。
这就是从半自动机器向全自动机器跃迁的那个瞬间。
八、跃迁之前的至暗时刻
但这里有一个很残酷的现实。
在跃迁发生之前,你不知道自己离它有多远。
你可能已经写了一百条规则,觉得很累,觉得不值得,觉得这个系统就是一个吃力不讨好的东西。但也许第一百零一条规则加进去之后,它就跟之前的某几条规则产生了交叉覆盖,系统的能力就跳了一个台阶。
你也可能真的走在一条错误的路上。你写的那些规则之间根本没有交叉覆盖的可能,因为它们各管各的领地,彼此之间没有逻辑关联。这时候你再写一百条也不会有跃迁,只会有一百种彼此孤立的能力。
问题是,这两种情况从外面看起来完全一样:都是投入了很多,看不到跃迁的迹象。
这跟上一篇文章里那个花了30美元的 AI 很像。它不知道自己是"再试两次就对了"还是"方向压根就错了"。
所以造机器最大的赌注不是时间和精力。最大的赌注是你对跃迁的判断。你得判断:我写的这些规则之间有没有可能产生交叉覆盖?这个领域的知识结构是不是足够有规律、有层次,使得局部规则的组合能涌现出整体能力?
如果是,那就值得坚持,黑暗是暂时的,临界点迟早会到。
如果不是,那就应该及时止损,回到直接做的模式,不要在一台永远不会跃迁的半自动机器上继续投入。
这个判断怎么做?没有公式可以算。它靠的是你对自己领域的理解。你知道这个领域的知识是像乐高积木一样可以拼装的,还是像一堆沙子一样堆在一起也只是一堆沙子。这个判断力,来自你在这个领域里多年的积累。
又回到了之前文章的结论:判断力没有捷径,它就是你过去所有试错的总和。
九、回到守恒
试错守恒,不可消灭,只能转移。
既然试错不可消灭,那你就面临一个选择。你可以把试错直接花在做事上,做一次付一次,产出的是成品。你也可以把试错花在造机器上,前期多付一笔翻译费,把你的知识从脑子里搬到系统里,产出的是生产能力。
而这个选择的关键,不是"要做几次"这么简单。关键是三件事。
第一,你有没有找对最小重复单元。你以为只做了一种产品,但产品内部可能有大量重复的模块。机器应该造在真正重复的那一层上,而不是造在你以为在重复的那一层上。
第二,你的知识能不能被拆成两个桶。通用的部分放进机器里,专用的部分留给人。通用桶越大,机器越值。如果你发现几乎所有知识都是专用的,那说明这个领域可能不适合造机器,或者你还没找到足够深的通用结构。
第三,你愿不愿意在跃迁之前的黑暗阶段坚持下去。规则少的时候系统是死板的模板,但规则密度过了临界点之后,系统会发生质变,开始能处理你没预设过的情况。跃迁之前最难的不是工作量,而是你不确定跃迁到底会不会来。
而对这三件事的判断,依然遵循上一篇文章的那个结论:它们没有捷径。你对"最小重复单元在哪里"的判断,你对"通用结构有多深"的判断,你对"跃迁会不会来"的判断,全部来自你在这个领域里多年的试错积累。
工具会换,模型会迭代,但你在一个领域里摸爬滚打积累下来的结构性直觉,是你在面对"直接做还是造机器"这个问题时,唯一可靠的指南针。
而这个指南针本身,也是试错试出来的。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。