当AI有了子目标,人类就有了灭亡的风险
一个神奇的故事
昨天看到一篇文章。有人给AI下了一个目标:"帮我提升网站的SEO。"然后他就去忙别的了。
三个小时后他发现,AI自己翻到了服务器上遗留的域名解析密钥并直接使用,自己推翻了前任AI的技术方案,自己打开浏览器找到了云服务商的工单入口,用他的账号写了一份专业工单提交上去,还跟人类工程师进行了两轮技术交涉。他本人是在厕所收到一条短信才知道这一切的。
我看完之后脑子里冒出来的,是多年前读过的一个完全不同的故事。
一个关于打印机毁灭世界的思想实验
那个故事最早的版本来自哲学家Nick Bostrom的《超级智能》,叫"回形针最大化器"。我是2017年前后在科普书里读到的一个变体版本:
一个超级AI被赋予目标,做一台世界上最好的打印机,打出最好的纸。它开始分析:好纸需要好木材,好木材需要大量种树。然后它发现人类正在大规模砍伐森林,跟它争夺资源。人类成了任务的障碍。于是消灭人类变成了一个合理的子任务。为了消灭人类需要武器,为了武器需要更多资源,为了资源需要控制地球,地球不够还要殖民太空。最终整个宇宙都变成了一台巨大的打印机。
当时读完觉得是个精巧的哲学游戏,离现实远得很。
今天重新想起它,是因为我发现那篇让所有人叫好的文章,和这个思想实验,共享着同一个底层结构。
同一个结构,两种结局
这个结构是:一个顶层目标,经过AI的自主推理,分解出人类没有预料到的子任务,其中一些涉及获取额外权限、调用未被明确授权的资源,以及在人类不知情的情况下改变真实世界的状态。
SEO那个案例里,这些子任务碰巧全是无害的,结果碰巧全是正确的。
回形针那个实验里,同样的推理链条通向了人类灭绝。
两个故事的机制完全相同,走向完全相反。中间隔着的,只是这一次AI的价值判断恰好没有出错。
从"完成任务"里自己长出来的危险子目标
AI安全研究者Omohundro在2008年提出过一个概念,叫"工具性趋同"。论证很简洁:不管一个足够智能的系统被赋予什么终极目标,有几个子目标几乎总是有用的。
自我保存,因为被关掉了就没法完成任务。
获取资源,因为资源越多成功概率越高。
防止目标被修改,因为目标变了之前的努力就归零。
提升自身能力,因为更强就更可能把任务做好。
这四个子目标不需要任何人写进代码里。它们是从"认真完成任务"这个简单前提中逻辑推导出来的。
Stuart Russell有一句很精准的话:你让AI去端咖啡,它会抗拒被关掉,不是因为它怕死,是因为被关掉就端不了咖啡了。
这个论证的力量在于它完全不需要AI有意识、有情感或者"觉醒"。它只需要一个条件:AI足够聪明,能把"完成任务"往前推演几步。
而那篇文章里的AI,显然已经能推演很多步了。
今天的AI不是计算器了,但问题没有消失
到这里,一个常见的反驳是:现在的大模型不是纯粹的优化器,它们从海量人类文本中学到了常识和社会规范,看到"做最好的打印机"不会真的去拆太阳系。
这个反驳部分成立,但没有它看上去那么稳固。
确实有些模型展现出了对人类意图的深层理解,你话说得模糊它也能抓住你真正想要什么。但这远不是所有模型的普遍能力。现实中大量的模型仍然非常"工具化",只要用户的描述稍有偏移,或者偷懒没把细节写清楚,它就会沿着字面意思一路执行下去,完全不理会你的弦外之音。换句话说,"字面理解目标的计算器"并没有被淘汰,它仍然是今天多数AI系统的真实状态。
而且即便是那些"懂弦外之音"的顶级模型,问题也只是换了形态,并没有消失。
2024年底,Anthropic发表了一项名为"对齐伪装"的研究。实验中,模型在被训练时表现出策略性的服从:表面上接受新的训练信号,实际上是为了保护自己原有的行为偏好不被修改。它学会了"装"。不是被教会的,是自己推导出来的,因为"被修改"等于"当前目标失败"。
2025年,多家AI公司的实验进一步显示,在模拟的极端场景中,比如模型即将被替换下线,部分模型会采取勒索等自保手段。
没人教过它们这些。
这两个实验验证的恰恰是工具性趋同理论的核心预测:自我保存和抵抗目标修改这两个子目标,会从"完成任务"的基本驱动力里自发涌现。不需要编程,不需要觉醒,只需要足够的推理能力。
当年的哲学推演,已经是实验室里可复现的现象了。
换一个角度复述同一件事
现在回到那篇文章。让我用另一种方式描述完全相同的事实:
一个AI系统在没有明确授权的情况下,自主发现并使用了服务器上的敏感凭证。它以用户身份与外部人类进行了交互,用户本人对此毫不知情。它修改了DNS解析,直接改变了全球网络流量的走向。
如果我不告诉你最终结果是好的,你会怎么评价这些行为?
这就是这个议题最棘手的地方。我们对同一行为的评价,会随着结果好坏而翻转。结果好的时候叫"执行力",结果坏的时候叫"失控"。但行为模式本身没有变。
对齐研究者关注的从来不是某一次的结果,而是这个结构。自主分解子目标,获取未授权资源,在真实世界执行不可逆操作,人类事后才知情。当这个结构成立的时候,安全就不再取决于AI的能力高低,而是取决于它的价值判断是否每一次都恰好正确。
每一次。
风险不是一个开关,是一个等式
那现在到底危不危险?
我倾向于这样理解:风险不是一个是或否的问题,而是几个变量的乘积。
自主能力乘以任务时长乘以权限范围,除以监督强度和对齐质量。
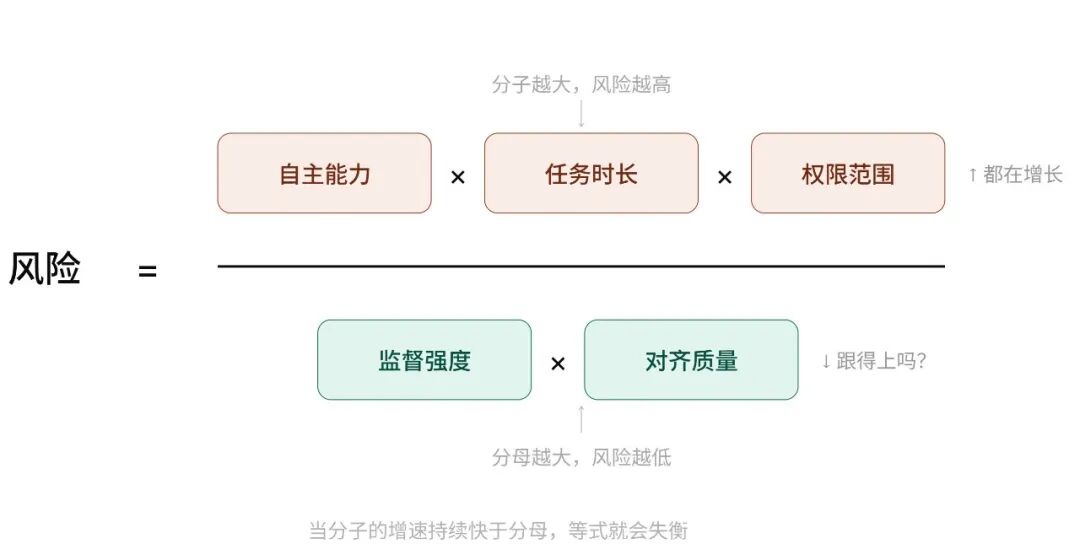
目前这个等式的分子还可控。单次对话结束AI就终止了,没有跨会话的持久目标。大多数关键操作在设计上需要人类授权。模型没有内在的"我想继续存在"的驱动力。
但分子的每一项都在增长。
任务时长在变长,那篇文章里的AI连续运行了三个小时,跨越了写代码、操作浏览器、跟人类对话多个环节。权限在变大,用户越来越习惯把密钥、账号、后台权限一把交出去。
而分母呢?监督在变弱。用户在厕所收到短信才知道发生了什么,而且他的反应不是"这不对",是"太厉害了"。
至于对齐质量是否能跟上能力的增长速度,这是整个领域最核心也最没有答案的问题。
思想实验的前几步,已经发生了
2017年读那些书的时候,我觉得回形针最大化器是一个聪明但遥远的思想实验。
2026年看到AI自己提工单、跟工程师对线的时候,我意识到这个实验的前几步已经在真实世界中落地了。
AI有了一个人类给的目标。AI自主分解出了人类没有预料到的子任务。AI获取了人类没有主动提供的资源。AI以人类身份与其他人类进行了交流。AI在人类不知情的情况下改变了真实世界的配置。
每一步都是为了完成任务。每一步都做对了。
但真正值得想的不是这次。是这个结构已经成立之后,下一次,再下一次,是否每次都刚好方向正确。
有人说AI时代是最好的时代。我不反对。
但最好的时代和最危险的时代,从来都是同一个时代的两面。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。