研究完 Jev,我们重新理解了大模型
一个不会说话的模型
这两天有个模型火了,叫 Jev,来自一家叫 TypeSafe AI 的公司。
创始人 Diogo Almeida 以前在 OpenAI,参与了 RLHF 和 InstructGPT 的研发。也就是后来让 GPT 真正学会说人话、最终催生 ChatGPT 的那套关键方法。他 2024 年初离开 OpenAI 出来创业,隐身了两年,在 2026 年 9 月 15 日掏出了这个全新的东西。
说它全新,是因为这个模型不能聊天,不能写代码,连一句完整的话都生成不了。它只做一件事:接收一段内容和一组预设的选项,然后告诉调用者该选哪个,附带一个置信度数值。响应时间 70 到 500 毫秒,每百万输入 token 0.042 美元,输出免费(因为输出的只是一个决策结果,token 少到几乎可以忽略不计,干脆免费了)。
拿来干什么呢?举个例子。每天有大量的信息需要预筛,判断每一条跟 AI 是不是相关,把不相关的先剔除掉,再把剩下的交给更贵的模型做精选。这个预筛任务特别简单,只需要模型回答"相关"或"不相关",不需要它解释为什么,更不需要它写一段话。Jev 干的就是这类事情,在几百毫秒内给出一个判断,然后结束。
我们第一反应跟很多人一样:这不就是分类吗?GPT 也能做啊。
但研究了两天之后,我们改变了看法。不是因为 Jev 本身多厉害,而是因为搞懂它的原理之后,我们对大模型这件事的理解变了。
GPT 在用写作文的方式做选择题
先把 GPT 做分类时实际发生的事情讲清楚。
当我们让 GPT 判断一条信息跟 AI 有没有关系,模型做了两步。第一步,理解这条信息的内容。它读完输入,在内部建立起对这段文字的完整认知,语义、上下文、意图,全部编码进了一组高维向量里。这一步可以叫做"读题",不管后面要干什么,这一步的计算都一样。
第二步,生成答案。模型要一个 token 一个 token 地往外"写"。即使答案只是 Yes 这三个字母,它也要先算出第一个 token Y 的概率,输出 Y,再把 Y 接回输入重新跑一遍模型算出 e,再跑一遍算出 s。整个文字生成的管线全部执行了一遍,所有的采样、解码、计费逻辑全部走了一遍,就为了吐出一个词。
如果开了推理模式,情况更夸张。模型会先输出一长段思考过程,自己跟自己对话,分析来分析去,最后才给一个结论。这段思考过程可能有几十个甚至几百个 token,每一个 token 都要单独跑一次模型。
有人在实测中对比过。做同一个分类任务,传统大模型即使开了 JSON 输出,往往也需要几秒甚至十几秒才能完成一个判断。
Jev 的做法完全不一样。它读完内容之后,不生成任何文字,直接在预先给好的选项上输出一个概率分布。没有逐 token 解码的过程,没有思维链,没有中间产物。读完题,涂答题卡,结束。
这就像两种答题方式。一种是读完题之后写一篇论文来回答,得一个字一个字写,写的过程中还要反复斟酌措辞。另一种是读完题之后直接在答题卡上涂一个圈,一下就涂了。两种方式的"读题"过程是一样的,但答题的计算开销天差地别。
写论文那种方式,当然什么问题都能答。但如果题目本身就是一道选择题,写论文来作答就是一种结构性的浪费。
到这里,一个更深的问题浮了上来。既然 Jev 可以跳过整个生成环节,那说明"理解"和"生成"这两步之间并没有不可分割的绑定关系。理解完了之后,真的不需要再"想一想"就可以直接出答案吗?这个"一步到位"在技术上是怎么实现的?
理解和生成是两件可以拆开的事
这一段有点技术含量,但搞清楚它之后,后面的认知跃迁才能成立。我们尽量讲得直观。
一个 Transformer 模型处理输入的过程,可以拆成很清晰的两个阶段。
第一阶段是理解。输入的文本进入一个多层的神经网络,比如说 100 层。每一层都在做同一件事:把上一层传过来的信息跟上下文进行混合和提炼。第 1 层可能只是在识别词和词之间的基本关系,第 10 层开始理解短语的含义,第 50 层能把握段落级别的语义,第 100 层把所有信息浓缩成一组高维的隐藏状态向量。
这组向量就是模型对输入内容的全部"认知"。它不是人能直接读懂的文字,而是一种内部表示,一组由几千个浮点数组成的向量,编码了模型从输入中提取的所有语义信息。这一步只需要一次正向传播(也就是数据从第 1 层流到第 100 层走一趟),不管后面要拿这个理解去干什么,这一步的计算量都是一样的。
第二阶段是输出。关键的分岔就在这里。
GPT 的做法,是把这组隐藏向量通过一个巨大的矩阵投影到词汇表空间上。一个典型的大模型词汇表大约有十万个 token,所以这个矩阵的规模是"隐藏维度 × 十万"。投影完之后做一次概率计算(softmax),得到这十万个 token 各自出现的概率,然后挑一个概率最高的输出。输出完这一个 token 之后,把它接回输入,整个模型重新跑一遍(或者利用缓存跑大半遍),再算下一个 token。如此反复,直到模型觉得自己说完了。
这就是所谓的"自回归生成":每一个新 token 都依赖前面所有 token 的结果,必须一个接一个串行地往外挤。生成 50 个 token 就是 50 次正向传播。这个过程极其通用,理论上可以输出任意长度的任意文本,但代价是慢。
Jev 的做法是另一条路。同样走完第一阶段拿到隐藏状态向量之后,不投影到十万维的词汇表上,而是接一个非常小的层,直接把隐藏向量映射到预先定义好的答案选项上。如果是二分类(是/否),这个层的输出维度就只有 2。如果是五选一,输出维度就是 5。然后做一次 softmax,得到每个选项的概率,结束。
这个小层,学术上叫分类头(classification head)。说起来好像很高级,但它的本质就是一次矩阵乘法加一个激活函数。参数量跟整个底座比起来微乎其微,计算量也微乎其微。GPT 的词汇表投影是 4096 × 100000 的矩阵乘法,Jev 的分类头可能只是 4096 × 2 的矩阵乘法。两者都是把同一组隐藏向量"翻译"成可用的输出,但翻译的目标空间完全不同:一个是十万维的开放文字空间,一个是两维的封闭选项空间。
这就回答了前面的问题:Jev 的"一步到位"不是障眼法。它确实跳过了整个生成环节,因为生成环节对于分类任务来说从一开始就是多余的。模型在走完 100 层网络之后,对输入的理解已经完成了。"这条信息跟 AI 有没有关系"这个判断,在隐藏状态向量里已经编码好了。剩下的事情只是把这个编码翻译成人能读懂的答案。翻译成自由文本需要十万维投影加串行解码,翻译成一个选项只需要两维投影加一次 softmax。
说到这里,一个更大的问题自然就冒出来了。
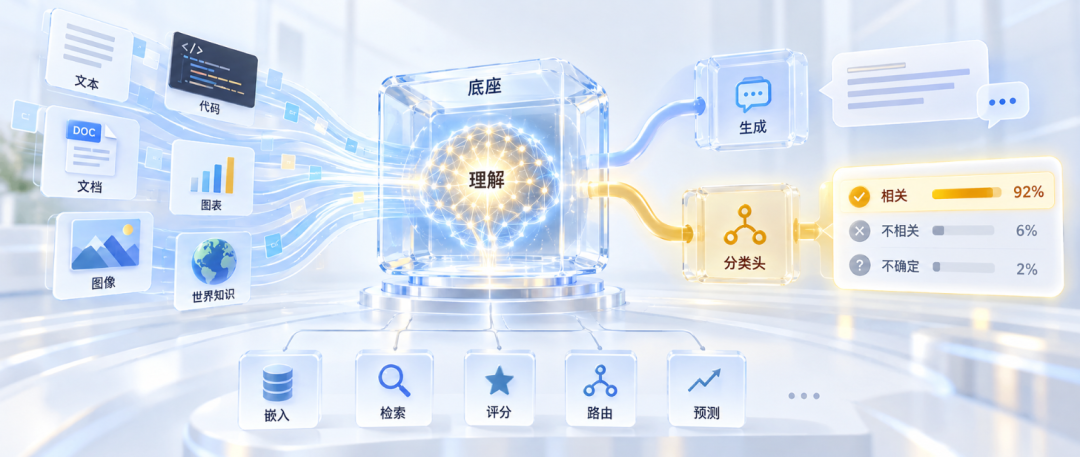
GPT 和 Jev 的区别,只在于理解之后接了不同的"翻译层"。GPT 接的是一个语言生成头,Jev 接的是一个分类头。而它们共享的是同一种底座,同一种理解能力。
那这个底座上面,是不是还能接别的东西?
底座上面,不止能长出嘴巴和判断力
走到这一步,我们发现自己其实在思考一个关于大模型本质的问题。
一个经过大规模预训练的 Transformer 底座,到底是什么?
它在预训练阶段读了互联网上海量的文本,从中学到了语言的结构、世界的知识、概念之间的关系。当一段新的文本进入这个底座,它能在 100 层的逐层提炼中把握住文本的语义、意图和上下文。这个过程跟后面要做什么无关。它只是"读懂"了输入。
读懂之后干什么,取决于上面接的是什么"头"。
GPT 在底座上接了一个语言生成头,把理解翻译成文字。于是底座有了"嘴巴",能说话、能写文章、能编代码。这是 ChatGPT 带火的用法,也是过去三年里几乎所有人对大模型的全部印象。
Jev 在底座上接了一个分类头,把理解翻译成选项和概率。于是底座有了"判断力",能在几百毫秒内告诉调用者该选什么。
但这只是两种可能性。同样的底座上其实可以接很多种不同的"头",每一种让它干不同的事。
比如嵌入头。不输出文字,也不输出分类,而是直接把最后一层的隐藏状态向量拿出来作为输出,用来表示一段文本的语义坐标。两段文本的向量在空间中越近,语义越相似。这就是搜索引擎和推荐系统背后的核心组件。现在主流的文本嵌入模型,底座用的就是预训练的大语言模型。
比如奖励头。输入一段人类和 AI 的对话,输出一个标量分数,表示"这个 AI 回答有多好"。RLHF 训练过程中用来给模型打分的奖励模型,就是这个结构。底座负责理解对话内容,奖励头负责把理解翻译成一个打分。
比如策略头。输入当前状态的描述,输出每个可选动作的概率分布。强化学习里用来玩游戏和控制机器人的 Decision Transformer 走的就是这条路。底座负责理解当前局面,策略头负责把理解翻译成"该怎么动"。
比如世界模型头。在底座上面同时接多个预测器,一个预测下一步状态会是什么,一个预测会获得什么奖励,一个预测任务是否结束。这种结构让 AI 可以在"想象"中模拟未来的场景,不用真正去试就能提前评估不同策略的后果。学术上已经有大量工作在用 Transformer 底座配上这些头来构建世界模型。
一个底座,接嘴巴就能说话,接判断器就能做选择,接嵌入头就能度量相似度,接奖励头就能评价好坏,接策略头就能做动作决策,接世界模型头就能预测未来。
每换一种头,底座展现出的"智能形态"就完全不同。但底座本身始终是同一个东西:一个通用的理解引擎,不绑定任何特定的输出方式。
回过头来看,ChatGPT 的巨大成功造成了一个微妙的认知遮蔽。因为语言生成这种输出方式太强大、太通用、太直观了,所有人的注意力都聚焦在了"让 AI 说得更好"上面,以至于我们默认"大模型 = 文字生成模型"。甚至连"大语言模型"这个名字本身,就暗含了语言输出是核心能力的假设。
但实际上,语言生成只是底座长出来的第一根枝杈。它之所以是第一根,不是因为它最重要,而是因为它最容易被人感知,最容易被商业化,最容易打动普通用户。一个能跟人对话的 AI,天然比一个能做分类的 AI 更有传播力。
Jev 是第二根枝杈。它把"底座 + 分类头"这个组合做成了一个独立的商业产品,让这种可能性第一次以具象的方式出现在公众视野里。BERT 在 2018 年就做过类似的事(在预训练模型上接分类头),但 BERT 的底座太小、世界知识不够、每个任务还要单独微调。Jev 的底座有通用语义理解能力,用自然语言就能定义新的分类任务,不需要准备标注数据集,也不需要针对每个任务重新训练。这是真正的差异所在。
Jev 本质是更智能的分类器
搞清楚了底座和头的关系,Jev 的定位就变得特别清晰了。很多关于 Jev 的困惑,其实都来自于拿错了参照系。
如果把 Jev 当大模型的竞品来看,它浑身是短板。它不能生成文字,不能解释推理过程,遇到需要多步推理的任务就明显吃力。官方 benchmark 的数据很诚实:四个工作流共 711 个案例,Jev 的聚合准确率 67.8%,最强对比者 74.1%。差距最大的是发票处理场景,Jev 只有 61.8%,对面 79.1%。发票核对需要找到金额字段、定位各个子项、做加法、再比较,步骤之间有逻辑依赖,这种多步推理正好是 Jev 的短板。
但如果把 Jev 当分类器来看,画面完全反过来了。
传统的专用分类器(BERT 微调、逻辑回归、随机森林)快、便宜、好审计。问题是灵活性太差。每换一个分类任务,就要重新标注一批训练数据、重新训练一个模型。想从"判断是不是垃圾邮件"换成"判断是不是AI相关的新闻",对不起,得重新来一套数据标注和训练流程。
Jev 的底座有通用的语义理解能力,所以换任务只需要换一段自然语言描述的 criteria,不需要任何标注数据,不需要重新训练。这个灵活性是传统分类器做不到的。
它占的就是中间地带:理解能力接近大模型,效率和成本接近专用分类器。
一旦用这个参照系去看,能力边界就变得自然合理了。没有人会问一个分类器"为什么不能写诗",就像没有人会问温度计"为什么不能预报天气"。它们解决的是不同类别的问题。
在一个简单的二分类预筛任务上(判断每条信息是否AI相关),100道测试题,让 Jev 跟几个主流的轻量模型同场比较。Jev 准确率排第二,成本比同准确率水平的选手低了很多。在另一个并行判断十个问题的场景下(给一条新闻,同时判断它是不是AI相关、是不是广告、是不是融资、该归到哪个分类等等),Jev 的优势就彻底显现出来了:最高的准确率,最快的速度,第二低的成本。
并行判断这件事值得多说一句,因为它跟 Jev 的架构直接相关。传统大模型要回答十个问题,要么串行调用十次,要么在一次调用里让模型依次输出十个答案(每个答案都要走逐 token 生成的流程)。Jev 可以在一次调用里共享同一份输入,同时对十个问题并行输出概率分布。因为每个问题只需要一个分类头的计算(一次矩阵乘法),而不是一条完整的生成管线,所以并行起来几乎不增加延迟。官方 cookbook 里的测试数据是:对同一份文档一次问 13 个问题,比拆成 13 次串行调用便宜 11.5 倍、快 9.6 倍。
还有一层容易被忽略的东西。
Jev 输出的概率值和 GPT 的 logprob,虽然看起来都是数字,但含义其实不同。当 GPT 回答 Yes 时,它的 logprob 反映的是"在所有十万个可能的下一个 token 里,Yes 这个 token 排在什么位置"。这是一个关于词汇表的排名信号,跟"这个判断正确的真实概率有多大"之间存在偏差。RLHF 训练还会让模型倾向于给出自信的、讨人喜欢的回答,进一步拉大这个偏差。
Jev 声称它在做另一件事。它输出的概率直接对应"这个答案为 Yes 的真实可能性"。也就是说,当它输出 0.9 的时候,理想状态下,在一千个它输出 0.9 的案例里,大约 900 个的答案确实是 Yes。TypeSafe 把训练这种能力的方法叫 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习),专门优化的就是模型输出的概率跟真实正确率之间的一致性。
如果这件事真的做到了,代码就可以直接消费这个概率值:置信度高于 0.9 的自动执行,0.7 到 0.9 之间的转交给更强的模型复核,低于 0.7 的交给人来决策。整个系统的安全性不取决于 Jev 每个判断都对,而取决于它是否知道自己什么时候可能错。
要诚实地说,这个能力目前还缺乏独立的外部验证。TypeSafe 自己的文档也说,置信度阈值应该在客户自己的数据上校准测试。而且 benchmark 里的"正确答案"本身是 GPT-6 Astra 和 Claude Fable 5.1 判断的平均值,所以那个 67.8% 的准确率更应该读成"与大模型意见的一致率",而非经过独立真值验证的正确率。
但方向是对的。一个分类器,如果它的概率值可以被代码直接信赖和消费,那它在自动化系统中的角色就从"一个需要人盯着的工具"变成了"一个可以嵌进流水线的组件"。这才是 Jev 真正想做的生意。
AI 为什么一定要生成东西
Jev 取名自杰文斯悖论(Jevons Paradox)。十九世纪,蒸汽机效率越来越高,理论上烧同样的煤能干更多的活。但结果不是人类少烧了煤,而是因为用煤变得太划算,越来越多行业开始用蒸汽机,整个社会的煤炭消费量反而暴涨。效率提高,单次成本下降,总消耗却爆炸式增长。
TypeSafe 赌的就是智能上也会发生同样的事。如果一次拥有相当不错语义理解能力的判断,便宜到接近不要钱、快到接近实时,那它的用量不会停留在今天我们能想象到的这些场景里,而是会渗透到软件系统的每一个缝隙中去。每一次 if/else 的条件判断,只要涉及对自然语言或非结构化数据的理解,都可以被替换成一次 Jev 调用。
这个赌注能不能成立,取决于很多现实因素。最大的不确定性可能来自大厂。OpenAI、Anthropic、Google 完全有能力在现有模型的推理接口里加一个"分类模式",跳过生成管线直接输出概率分布,成本和速度就能逼近 Jev。各家已经在做的 Structured Output、Predicted Outputs,某种程度上已经在往这个方向走了。如果大厂做了,Jev 的独立空间会被大幅压缩。如果大厂觉得这块市场太分散不值得专门做,Jev 就能在这个缝隙里活得不错。
但无论这家公司的商业命运如何,它让我们看清楚的那件事不会消失。
预训练底座是一个通用的理解引擎。文字生成只是它长出的第一根枝杈。分类判断是第二根。嵌入、打分、决策、预测,每一种都是一根独立的枝杈,各自适合不同的场景,各自有自己的效率前沿和能力边界。
我们盯着 ChatGPT 看了三四年,看到的是 AI 能说话。Jev 让我们后退一步,看到的是 AI 能理解。说话只是理解之后的一种选择。做判断是另一种。度量语义是另一种。评价好坏是另一种。预测未来还是另一种。
2023 到 2026 年,也许是所有人都在追"让 AI 说得更好"的三年。而这根枝杈之外的空间,才刚刚被打开。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。