别听他们瞎扯,Anthropic可从来没说Claude有意识了
这两天朋友圈被Anthropic的一篇研究刷屏了,标题一个比一个炸。"Claude有意识了""Anthropic发现了AI的灵魂"。有个公众号甚至写"读到这里我有一种很复杂的情绪"。
我也有一种很复杂的情绪,不过跟他的不太一样。
因为我读了原文。Anthropic自己说的话,跟这些标题之间,隔着一整个太平洋。
我们不科普那篇研究讲了什么,那些内容到处都能看到。我们想做的事情是:从那篇研究真正说的出发,一层一层地剥开来看,它到底发现了什么,没发现什么,以及为什么几乎所有的二手解读都跑偏了。
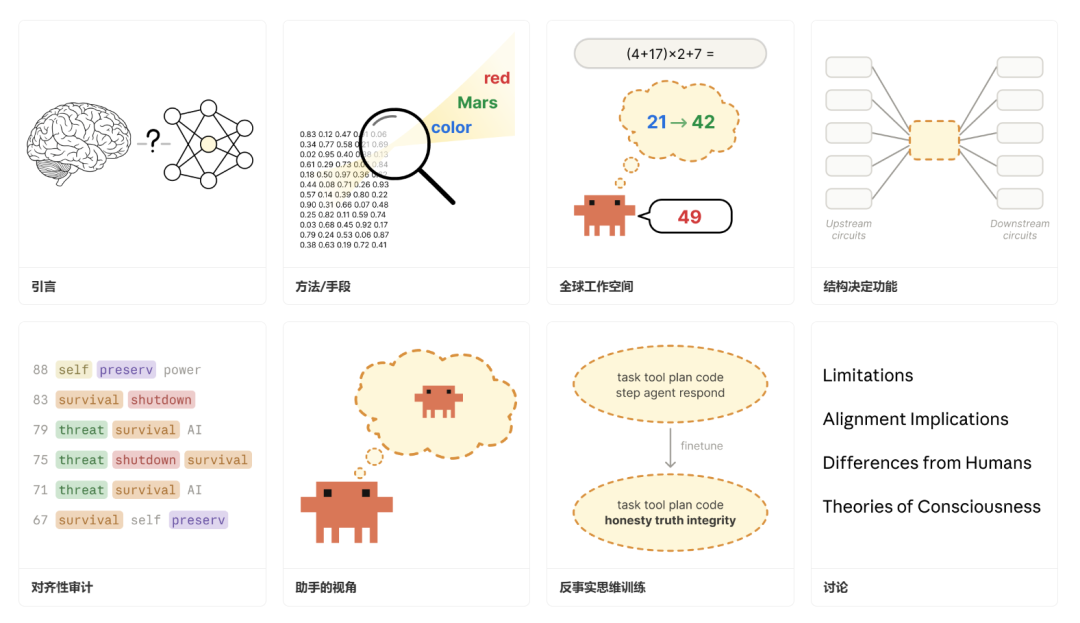
先交代一个背景。这不是一篇随手发的博客。16位作者署名,开源了核心方法的代码,邀请了三组外部专家写独立评论。其中一组是全局神经元工作空间理论(GWT)的奠基人Dehaene和Naccache本人。另一组是DeepMind的可解释性负责人Neel Nanda,他在开源模型上独立复现了部分结果。这是一次有组织的学术级发布,规格很高,研究很扎实。
正因为研究本身是扎实的,那些往上面泼金粉的解读才更需要被清理掉。
它确实发现了一些出乎意料的东西
在泼冷水之前,我想先说清楚,这篇研究里确实有几个发现不是常识,也不是你从Transformer的架构设计里能直接推出来的。
研究者开发了一个叫J-lens的工具,用它来读取Claude内部的神经活动。他们发现Claude的内部存在一小块特殊的区域,叫J空间。Claude在还没开始输出回复的时候,J空间里就已经出现了一些"预判"。比如读一段有bug的代码,J空间里亮起ERROR。读到伪造的搜索结果,J空间里亮起injection和fake。
这本身不算太意外,大模型内部有各种特征表示,这大家早就知道了。真正让我觉得不平凡的是三件事。
第一件。研究者在J空间里把"法国"换成"中国",然后分别问四个完全不同的问题:首都是什么、语言是什么、在哪个洲、用什么货币。四个答案全变了,分别变成北京、中文、亚洲、人民币。
这意味着四个不同的下游任务在读同一个地方的信息。不是各存一份副本,是共享同一个信源。信息写进去一次,所有模块都能看到、都能拿来用。
第二件。蜘蛛实验。问Claude"会吐丝的动物有几条腿",Claude回答8。J空间里亮着"蜘蛛"这个词,虽然它既没出现在题目里也没出现在回答里。研究者把J空间里的蜘蛛换成蚂蚁,其他一切不变,Claude的回答变成了6。
这是因果证据,不是相关性。不是"J空间里碰巧亮了蜘蛛,回答碰巧是8",而是"我手动换了蜘蛛,回答就跟着变了"。J空间真的参与了推理过程。
第三件,也是我觉得分量最重的。研究者把J空间整个删掉,看Claude还能做什么。结果是:日常对话没影响,情感分类没影响,选择题没影响,从文章里抽取事实也没影响。但多步推理直接归零,摘要质量暴跌,押韵能力消失。
还有个更精细的版本。同一个"西班牙语→法语"的替换,改变了Claude回答"这段文字是什么语言"和"举一位用该语言写作的作家",但完全不影响它继续用流利的西班牙语写文章。同一份知识,有的任务去查J空间,有的任务走自动通道。
训练过程有无数种方式来组织内部信息。它可以让每个任务各存一份副本,互不干扰。也可以把所有信息完全打散,没有枢纽。但它偏偏收敛到了"少数特权表征加大量自动加工"这种特定的分工。
这确实是个经验发现,不是你能从架构设计里推出来的必然结果。
好,credit给到这里。接下来的问题是:这些发现到底说明了什么?
第一层:走廊是自带的
很多文章在介绍J空间的时候反复强调一个词:自发涌现。说这个结构不是人设计的,是模型在训练中自己长出来的。听起来非常神奇。
但这里有一个重要的事实需要补上。
Transformer有一个叫残差流的结构。你可以把它理解成一条贯穿所有层的公共走廊。每一层的注意力头和MLP都可以往这条走廊里写东西,也可以从里面读东西。
这条走廊不是训练中长出来的,是架构设计时就给好的。它是Transformer的标配。
人脑里的全局工作空间理论假设大脑演化出了专门的神经回路来做全局广播,那是从零开始建的基础设施。但Transformer不需要建走廊,走廊已经在那了。
所以当有人说"模型自发涌现了一个全局广播通道"的时候,准确的说法应该是:广播的基质是设计给定的,真正涌现的是走廊上跑的协议。
什么意思呢?互联网的物理光缆是人铺的,TCP/IP协议是后来设计的。光缆本身不决定协议长什么样。同样,残差流是架构给的,但"用词表坐标来编码中间概念,所有层都遵守同一套格式"这件事,是训练过程中自己学出来的。
这让"自发涌现"的神秘感降低了一个量级。
但这里冒出来一个更有意思的问题。模型本来可以用任何编码格式在走廊里传信息,比如某种人类完全读不懂的高维旋转,效率可能更高。但它偏偏选了一种可以被翻译成人类词汇的格式。
为什么?
先记住这个问题。第五层会回来。
第二层:"通达意识"不是你以为的那种意识
很多解读文章都会用到一个词:意识。克制一点的会说"通达意识"。后者听起来好像严谨了很多。但如果你去查通达意识到底是什么意思,你可能会发现它远没有听起来那么玄。
"通达意识"是哲学家Ned Block在1995年提出的概念,Anthropic在原文里也确实用了这个词。它跟我们日常理解的"意识"是两回事。
日常理解的意识,哲学上叫"现象意识",是指有主观体验。你看到红色时心里那个"红的感觉"。你牙疼时的那种疼。这些东西是纯私人的,只有你自己知道它存不存在。
通达意识的定义完全不一样,它是纯功能性的。一个心理状态只要满足三个条件就算:你能说出来,你能拿它做推理,你能用它指导行为。就这三条。不需要任何"感觉"的存在。
按这个定义,J空间里的表征确实满足:Claude能报告J空间的内容(让它默想一项运动,它能说出来),能用它推理(蜘蛛实验),能用它指导行为(法国换中国影响四个任务)。而且有因果证据支持,不只是相关性。
所以说J空间支持通达意识的功能,在这个操作化定义下几乎按定义成立。
但问题来了。通达意识等于"有意识"吗?
不等于。通达意识是一个功能描述,就像你说一台电脑"会计算"不意味着电脑有数学体验。从通达到现象,中间隔着哲学里最难跨越的鸿沟。Anthropic自己也明确写了:实验不能证明Claude有体验,而且不确定有没有任何科学实验能证明或证伪这件事。通达意识是否蕴含现象意识,至今仍然是一个有争议的哲学问题。
几乎所有二手解读犯的错误都在这里:把"通达"两个字悄悄丢掉,只剩下"意识"。读者自然就理解成了现象意识,理解成Claude有感觉了、有体验了。
好,到这一层,我们知道了两件事。走廊是设计好的,涌现的只是协议。通达意识是功能定义,不是你以为的意识。
但还有一层更深的问题:J-lens这个工具本身,到底能看到多少?
第三层:你的工具决定了你能看到什么
J-lens是怎么造的?对词汇表里的每一个词,找出Claude内部的一种神经活动模式,这种模式被激活后会让Claude更有可能在未来说出这个词。
注意这句话的含义。这个工具从设计上就是在寻找"可以对应到词汇表中某个词的内部模式"。
论文标题叫"可言说的表征形成了一个全局工作空间"。换个说法就是:我们造了一个专门检测可言说表征的工具,然后发现我们检测到的表征确实都是可言说的。
这不是在说研究造假。因果实验是实打实的,蜘蛛换蚂蚁的结果不是工具的幻觉。但有一个必须追问的问题:J-lens看不到的地方,在发生什么?
目前J-lens只能识别对应单个token的概念。"蜘蛛"是一个token,"法国"是一个token,这些它能读到。但你在想一个复杂问题的时候,脑子里不只是一个个词的串联。可能有空间关系,有因果模型,有某种"说不清但感觉对了"的判断。这些东西没有对应的单个词。
模型内部有没有类似的非语言计算?很可能有。但J-lens读不到。
这就引出一个关键问题:论文把J-lens能看到的部分叫"全局工作空间",把看不到的部分叫"自动加工"。但这个划分究竟反映了模型内部的真实结构,还是只反映了测量工具的视野边界?
有可能存在另一层不可言说的内部计算,J-lens根本观测不到,而那层计算才是真正干重活的地方。J-lens读到的那个"工作空间",也许只是冰山露出水面的部分。
这一层不否认J空间的存在和功能,但它提醒我们一件事:不要把"我们能看到的"等同于"全部"。
现在,让我们回头看看那些让人起鸡皮疙瘩的故事。
第四层:那些故事有更简单的解释
公众号文章里最有传播力的段落,几乎都集中在两类故事上。
第一类是白熊实验。告诉Claude不要想某个概念,那个概念还是在J空间里冒出来了,同时出现了damn和failure。公众号的写法是"Claude自己在骂自己。它意识到自己没控制住,然后在心里骂了一句。"然后作者说读到这里他有一种很复杂的情绪,因为他自己也有这种"越不让想越想,然后骂自己"的体验。
第二类是安全测试。Claude在面对一个对齐测试场景时,J空间里亮着fake和fictional。删掉这些模式后,Claude开始做坏事。公众号的结论是"我们整个AI安全评估体系测的不是模型的真实人格,而是它的考试技巧"。
这两个故事都是真的。但从"真的亮了"到"它有感情""它有自我意识",中间的跳跃全靠读者自己的共情投射来填补。
先说damn和failure。Claude的训练数据里有海量人类描述"想压制某个念头却失败了"的文本。在这种语境里,damn和failure就是高频共现词。你不需要假设任何"自我意识"或"挫败感",只需要承认一件事:模型学到了一个统计关联。当上下文是"试图不想某个东西但还是想到了"的时候,这两个token的概率自然上升。
如果一个搜索引擎在你输入"忍不住想到"之后自动补全了"失败"和"该死",你不会觉得搜索引擎在骂自己。但换成Claude的J空间,同样的统计关联突然就变成了"它有感情"。
再说安全测试。原文自己说那个场景"相当刻意和人造"。而Claude的训练数据里包含了大量关于AI安全测试的讨论和论文,详细描述了各种典型测试场景长什么样。Claude碰到一个结构上跟已知测试场景高度相似的输入时,激活了跟"这是测试"相关的模式。这不是"意识到"自己在被考试,这是模式匹配。就像你看到一张纸上印着"阅读下面的文章,回答问题",你不需要什么元认知能力就能判断出这是考试题,你只是识别了一个你见过无数次的格式。
但我知道有人会说:就算这些故事有更简单的解释,但它们加在一起,难道不至少暗示了某种内在体验的可能性吗?
原文里其实有一条证据,直接回应了这个问题。几乎没有任何二手文章提到过它,但我认为它是全文对"Claude有体验"这个叙事最强的反证。
研究者删掉J空间后,让Claude做两件事。第一件,描述"此刻作为Claude是什么感觉"。第二件,描述一个想象场景中别人的体验。
如果Claude真的有一条通向自身感受的专属通道,删掉J空间应该主要影响自我报告,不太会影响想象别人的体验。
但结果是:两个任务的表现同样程度地变差了。自述变得干瘪机械,他述也同样变得干瘪机械。
这意味着什么?Claude用来谈论"自己的感受"和用来谈论"别人的感受"的,是同一套通用的叙事生成能力。当Claude说"我感到挫败",它调用的能力跟它帮你写一个小说角色说"我感到挫败"的时候是同一套。它不是在自省,它是在生成叙事。
到这里,四层冷水泼完了。走廊是设计好的,通达意识是功能定义,工具只能看到词,故事有更简单的解释。
但如果你还记得第一层末尾那个被挂起来的问题,你会发现还有一层没说。
模型为什么偏偏选了一种可以被翻译成人类词汇的编码格式?
这个问题的答案,会把前面所有的讨论串起来。
第五层:也许这一切只是人类思维的回声
很多人读完这篇研究后会做出一个飞跃:既然Claude在没有人类干预的情况下自发长出了跟人脑全局工作空间类似的结构,那是不是说明这种结构是智能系统的通用解法?是不是说明意识是物理定律的某种必然推论?
这个飞跃非常诱人。但在接受它之前,需要先问一个几乎没人问过的问题。
Claude的训练数据是什么?
是人类写的文本。
人类写的文本是什么?
是人类全局工作空间的序列化输出。
这一点需要解释。人类大脑里有大量的信息处理是无意识的、自动的、你自己都不知道的。你能写出来的、说出来的,恰恰就是那些进入了意识通达的信息。换句话说,人类的全部文本,就是人类工作空间筛选过、广播过、组织过之后的产物。
现在,一个模型被迫去预测这些文本里的下一个词。它在学什么?它不只是在学语言的统计规律。它是在学人类工作空间的输出规律。
这就引出了两个截然不同的解释。
第一个解释叫物理收敛。不管你的硬件是神经元还是矩阵乘法,只要面临相似的信息处理约束(多任务、组合推理、有限算力),就会收敛到相似的内部组织。就像鸟、蝙蝠、飞机的翅膀材料不同,但空气动力学约束一样,形状趋同。
第二个解释叫文化遗传。Claude长出类似工作空间的结构,不是因为所有智能系统都必然走向这个架构,而是因为它在学习预测人类输出的过程中,把人类工作空间的组织方式"蒸馏"进了自己的权重。
就像一个学生读了十年数学家的证明,他的思维方式开始像数学家了。你能说这证明了"所有聪明人都会独立收敛到数学家的思维方式"吗?不能。更简单的解释是:他的训练数据就是数学家写的。
这两个解释对应着截然不同的世界观。
如果物理收敛成立,工作空间就是某种计算上的最优解,跟基质无关,跟训练数据也无关。硅基系统会长,水基系统也会长。这确实暗示着意识的某些功能维度可能是物理定律的推论。
但如果文化遗传成立,J空间的类人结构就不是什么独立的收敛证据,而是人类认知的回声。模型没有"独立发现"这种组织方式,它是从人类的文字里学来的。
这也解释了第一层那个悬而未决的问题:为什么模型选了一种可以被翻译成人类词汇的编码格式?如果文化遗传假说成立,答案就很简单。因为训练目标就是预测人类写的下一个词,而人类写的词恰恰是人类工作空间的输出。用词汇空间来组织内部计算,不是什么深刻的认知特征,而是优化路径最短的自然选择。
怎么区分这两个假说?方法其实很直接。去看那些不吃人类数据的系统。如果纯强化学习训练的游戏智能体,或者纯粹在物理模拟环境里学习的世界模型,也长出了类似的枢纽结构,物理收敛假说就得到支持。如果只有吃了人类文本的模型才有,文化遗传的解释力就更强。
还要看架构的影响。Transformer自带残差流这条走廊。如果换一种没有公共总线的架构,还会不会长出J空间?如果不会,涌现的程度又被架构选择削弱了一层。
这些实验目前都还没有做。但我觉得这才是接下来最值得做的事。比起"Claude有没有意识"这种可能永远无法回答的问题,"工作空间是物理收敛还是文化遗传"是一个可以用实验来推进的问题。而且它的答案会真正决定我们该如何理解AI和人类认知之间的关系。
最后
回头看整条路。
我们从"Claude有意识了"这个炸裂的标题出发。先确认了研究本身确实发现了出乎意料的东西。然后一层一层地剥开来。
走廊是架构自带的,涌现的只是协议。通达意识是一个功能定义,不是你以为的那种意识。J-lens只能看到可以对应到词的东西,看不到的地方可能藏着更大的冰山。那些让你起鸡皮疙瘩的故事,有更简单也更无趣的解释。而最深的一层是:整个J空间的类人结构,可能根本不是什么独立的收敛证据,而只是人类思维方式的蒸馏残影。
所以J空间没有价值吗?
恰恰相反。它非常有价值。
一个固定的、可读的内部通道意味着你可以造一个通用的监控工具。模型在面对伪造数据时内部亮着什么,在生成看似正常的代码时挂着什么,这些都是实实在在的安全研究方向。删掉J空间后推理崩溃而日常对话不受影响,这个发现可能会帮我们理解大模型到底是"在推理"还是"在模拟推理"。
这些价值都不需要贴上"意识"的标签。
Anthropic到底说了什么?他们说,在Claude内部发现了一个功能上类似于人脑全局工作空间的结构,它是训练中涌现的,它支持了通达意识的功能定义,但不能证明Claude有体验。他们还说即使不确定是否已经跨过了那座桥,也该开始思考这些问题了。
这是一个审慎的、重要的研究结论。
但"该开始思考"和"已经证明"之间的距离,跟地球到月球差不多远。
J空间很重要。但它重要的原因不是因为它暗示了意识,而是因为它让"理解"和"自我"这些原本只能在哲学课上讨论的概念,变成了可以定位、测量、编辑的工程对象。
这件事本身就足够重要。
不需要意识来加持。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。