大模型之外的 Harness,也分远近亲疏
一、一句话引发的思考
2026 年,LangChain 发了一篇广为流传的文章,里面有一句话被反复引用:
If you're not the model, you're the harness.如果你不是模型本身,那你就是 harness。
同年,OpenAI 正式提出了"harness engineering"这个学科概念。他们披露了一组数据:一个 3 到 7 人的工程团队,五个月写了大约一百万行生产代码——全是 harness。
一时间,所有人都在聊 harness。Agent 系统里,大模型(LLM)是唯一的核心智能体,其余一切——Gateway、Agent Loop、Memory、Skills、Tools、定时任务——统统是围绕 LLM 搭建的脚手架,统统叫 harness。
这个判断没错。但它太粗了。
它把 Skill、Plugin、MCP、自进化框架全扔进一个叫"harness"的大筐里,好像它们都是一回事。但如果你真正动手搭过一个 Agent 系统,你会发现这些东西之间的差异,比它们和大模型之间的差异还让人困惑。
Skill 和 Plugin 有什么区别?Plugin 和 MCP 呢?那个能让 Agent 自动变强的"自进化框架"又是什么?它是 Plugin 的一种吗?
这篇文章试图解决这个困惑。方法很简单:找到一个判断标准,把这些概念分清楚。
二、判断标准:谁是主语,谁是宾语
在一个 Agent 系统中,所有组件和 Agent 之间的关系,归根结底只有两种:
第一种:Agent 操作它。 Agent 是主语,这个组件是 Agent 的工具或参考资料。
第二种:它操作 Agent。 Agent 是宾语,这个组件在修改 Agent 本身。
听起来太抽象了。我们用一个完整的任务场景来走一遍。
三、一个任务,四种 Harness 各显身手
假设你对你的 AI Agent 说:"帮我整理这个月的销售数据,生成一份月报,然后发邮件给老板。"
这个任务听起来简单,但接下来发生的事情,完美展示了四种 harness 各自的角色。
第一个出场:Skill
Agent 接到任务后,第一件事不是直接开干,而是先查自己的"资料库",有没有关于写月报的操作指南?
找到了,一个叫 monthly-report.md 的文件,里面写着:
当用户要求生成月报时:1. 先读取销售数据文件,汇总本月总额和各产品线明细2. 与上月数据对比,计算环比增长率3. 标注异常波动的产品线(增减超过 20% 的)4. 按照公司模板生成报告,包含数据表格和简要分析
Agent 读完这段文字,知道了该按什么步骤做。
这就是 Skill。它是一份 Markdown 格式的操作指南,Agent 在需要时读取它,从中获取"遇到这类任务该怎么做"的知识。
关键点:Skill 是被 Agent 读的,Agent 是主语。Skill 本身不执行任何操作,它就是一段文字,像贴在工位上的操作手册。LLM 读懂它,然后自己决定怎么行动。
第二个出场:Plugin
Agent 知道该做什么了,但它需要工具。第一步是读取你电脑上的销售数据表格。
于是 Agent 调用了一个叫 read-spreadsheet 的 Plugin,传入参数:"打开 /documents/sales-june.xlsx"。Plugin 的代码在本地执行,读取了表格内容,把数据返回给 Agent。
这就是 Plugin。它是一段真正的程序代码(Python、JavaScript 等),注册在 Agent 的工具列表里,Agent 在推理循环中主动调用它来完成某个具体操作。
关键点:Agent 是主语,Plugin 是它的手。Agent 决定什么时候用、怎么用,Plugin 负责执行并返回结果。Plugin 跑在你的本地机器上,读的是你电脑上的文件,整个过程不需要联网。
第三个出场:MCP
Agent 整理完数据、生成了报告,现在到了最后一步:把报告发邮件给老板。
但你的邮箱在 Google 的服务器上,不在本地。Agent 需要连接你的 Gmail 账号才能发邮件。于是 Agent 通过 MCP(Model Context Protocol)向 Gmail 的服务发起请求,帮你发出了那封带附件的邮件。
这就是 MCP。它是一个标准化的远程工具调用协议,让 Agent 能连接外部服务(Gmail、Google Calendar、Slack 等),获取或操作远程数据。
从 Agent 的视角来看,调用 MCP 和调用 Plugin 感觉完全一样——都是"我需要一个工具,我调用它,它帮我完成了"。Agent 不关心代码跑在本地还是远程,就像你用手机发消息时不关心服务器在北京还是深圳。
但 MCP 有一个 Plugin 不具备的关键能力:认证管理。
为什么需要认证?因为你的邮箱不是谁想看就能看的。Agent 要访问你的 Gmail,必须先证明"这个人允许我操作他的邮箱"。这个证明过程是这样的:你在浏览器里登录 Google 账号,Google 弹出一个页面问你"是否允许 Claude 访问你的邮件?",你点击"允许",Google 就发给 Agent 一个"通行证"(技术上叫 Token)。之后 Agent 每次访问你的邮箱时,出示这个通行证就行,不用你再次登录。
MCP 帮你管理了这个通行证的整个生命周期——存储、使用、过期后自动刷新。你只需要授权一次,之后就不用操心了。而 Plugin 是本地代码,读的是你自己电脑上的文件,不需要向任何人证明"我有权限",所以不需要这套机制。
小结:前三个的共同点
到这里,任务的"台前"部分结束了。Agent 读了 Skill(知道该怎么做),调用了 Plugin(读取了本地数据),通过 MCP(发了邮件),完成了整个月报流程。
注意一个重要的共同点:在这三个关系中,Agent 始终是主语。 Skill 是它读的,Plugin 是它用的,MCP 也是它用的。它们都在 Agent 的认知范围内,Agent 知道自己有这些资源可以调用。
这三个,属于运行时 harness,和 Agent 一起跑,Agent 能感知到它们的存在。
第四个出场:自进化框架——画风突变
任务结束了。Agent 交完月报,等待下一个指令。
但在另一个地方,有一段程序悄悄启动了。不是 Agent 启动的——是开发者在终端里手动敲了一行命令:
python -m evolution.skills.evolve_skill \--skill monthly-report \--iterations 10
这个程序做了什么?
它读取了 Agent 之前写月报时的执行日志(调用了哪些工具、花了多少时间、用户对结果满不满意)
它拿到了 Agent 使用的那个 monthly-report.md Skill 文件
它用大模型 API 生成了这个 Skill 的 10 个变体——有的加了"自动标注同比数据"的步骤,有的调整了分析顺序,有的加了"当某产品线连续三个月下滑时生成预警提示"的规则
它让 Agent 用每个变体分别跑了一组测试任务,记录准确率、完成速度、报告质量
它选出表现最好的那个变体,覆盖回了 monthly-report.md
整个过程中,Agent 在干什么?
什么都没干。它甚至不知道这件事发生了。
下次你再让 Agent 写月报时,它读到的 monthly-report.md 已经是优化后的版本了。它会表现得更好——可能会自动加上同比分析了,可能会主动给连续下滑的产品线打预警标签了——但它不知道这些改变从何而来。
这就是自进化框架。它是一个完全独立于 Agent 之外运行的工程程序,操作的对象是 Agent 本身的配置(Skill 文件、工具描述、系统提示词、甚至代码)。
这里需要区分几个容易混淆的概念。
框架 vs 管线。 管线(Pipeline)只是框架内部的执行机制——"按顺序跑完这几步":读取 → 生成变体 → 测试 → 选优 → 写回。这条处理链就是一条管线。但框架比管线大得多:它还包括评估标准怎么设计、测试数据怎么生成、安全门控怎么设置。管线是框架的手脚,框架是整个系统。
框架 vs 工作流。 工作流是 Agent 执行任务时走的路线,比如"读数据 → 分析 → 生成报告 → 发邮件"。框架不是 Agent 走的路线,而是人在 Agent 之外运行的、用来改造 Agent 的程序。Agent 走工作流,Agent 被框架改造。一个发生在 Agent 干活的时候,一个发生在 Agent 不干活的时候。
关键点:Agent 是宾语。 框架修改了 Agent,Agent 没有参与这个过程。这和前面三个 harness 的画风完全不同。
用一个直白的说法:自进化框架就是上帝(开发者)趁人(Agent)睡着的时候,给他做了一台手术——换了更好的眼睛、强化了记忆力、优化了肌肉结构。人醒来后发现自己看得更清楚了、干活更快了,但他不知道自己被动过手术。
四、框架能改什么?不止是 Skill
刚才的例子只展示了框架优化一个 Skill 文件。但它能做的远不止这些。
优化工具描述。 Agent 有很多工具可用,每个工具都有一段描述文本,大模型根据这段描述判断什么时候该调用哪个工具。比如"读取文件"工具的描述是:"读取本地文件。"这段描述太模糊了,大模型经常在用户说"帮我搜索文件"时也调用它——但它只能读取指定路径的文件,不能搜索。框架生成几个更精确的描述变体,测试后选出误调用率最低的那个写回去。Agent 下次就不会犯这个错了。
优化系统提示词。 Agent 的系统提示词里有一个段落指导它如何处理多步骤任务,原文可能是"先制定计划,再逐步执行"。框架发现一个变体效果更好:"先列出所有步骤并标注依赖关系,如果某一步失败,回到计划阶段重新评估,而不是继续执行后续步骤。"替换之后,Agent 处理复杂任务的成功率提高了。
优化代码实现。 更进阶的用法:框架甚至可以优化 Agent 内部某个模块的代码。比如上下文压缩器——当对话太长时负责压缩历史消息的模块。原始实现是直接丢弃中间消息,框架生成了一个"先生成摘要再丢弃原文"的变体,测试后发现 Agent 在后续对话中"忘记之前说过的事"的频率降低了。
概括来说:Plugin 是从 0 到 1,给 Agent 加一个它之前没有的能力。框架是从 1 到 1.5,让 Agent 已有的能力变得更好。 Plugin 给 Agent 装新器官,框架强化 Agent 的身体素质。
五、远近亲疏:Harness 的层级
现在可以给这些概念排个层级了。
第一层:文档层——Skill
形态是 Markdown 文本。Agent 按需读取。不执行任何操作,只提供知识。是 Agent 的参考资料。
第二层:工具层——Plugin 和 MCP
形态是可执行的程序代码。Agent 在推理循环中主动调用。Plugin 跑在本地,MCP 跑在远程(多了认证管理的封装),但对 Agent 来说两者没有区别。是 Agent 的手。
第三层:元层——外部工程框架
形态是独立运行的工程项目(比如 Hermes 的自进化框架)。不在 Agent 内部,由人类在外部启动。操作对象是 Agent 本身的配置和代码。Agent 不知道它的存在。框架内部通过管线(Pipeline)——一条"读取 → 生成变体 → 测试 → 选优 → 写回"的处理链——完成具体的优化工作。管线是框架的手脚,框架是整个系统。
三层之间的关系也很清晰:框架(第三层)优化的产物,往往就是 Skill(第一层)或工具描述(第二层的元数据)。它站在最外层,改的是内层的东西。
而判断任何一个组件属于哪一层,标准只有一个:在这个关系里,Agent 是主语还是宾语?
Agent 读它 → 第一层(Skill)。Agent 用它 → 第二层(Plugin / MCP)。它改 Agent → 第三层(外部工程框架)。
六、两种脚手架:台前的和幕后的
三层还可以进一步归为两大类。
运行时脚手架(第一层 + 第二层): 和 Agent 一起跑,Agent 能感知到它们。Skill 在 Agent 的认知里是"我知道有这份参考资料",Plugin 和 MCP 在 Agent 的认知里是"我知道有这些工具可以用"。它们是台前的舞台设备,演员(Agent)看得见、用得着。
工程时脚手架(第三层): 在 Agent 之外跑,Agent 完全无感。自进化框架、基准测试套件、评估系统都属于这一类。它们是幕后的剧本修改和排练优化,演出开始后演员不知道剧本被改过,只知道"台词念起来比昨天顺畅了"。
这个区分解释了一个常见的困惑:很多人第一次听到"self-evolution"时,会以为它是 Agent 的一个 Plugin——Agent 在运行时"自己调用自己的进化功能"。不是的。框架和 Agent 是两个独立的进程,Agent 跑着的时候框架可能没跑,框架跑着的时候 Agent 可能闲着。它们之间唯一的交集是磁盘上的那些文件——框架改了文件,Agent 下次启动时读到了改过的文件。仅此而已。
七、一张图,一个标准
最后把全文浓缩成一张层级图:
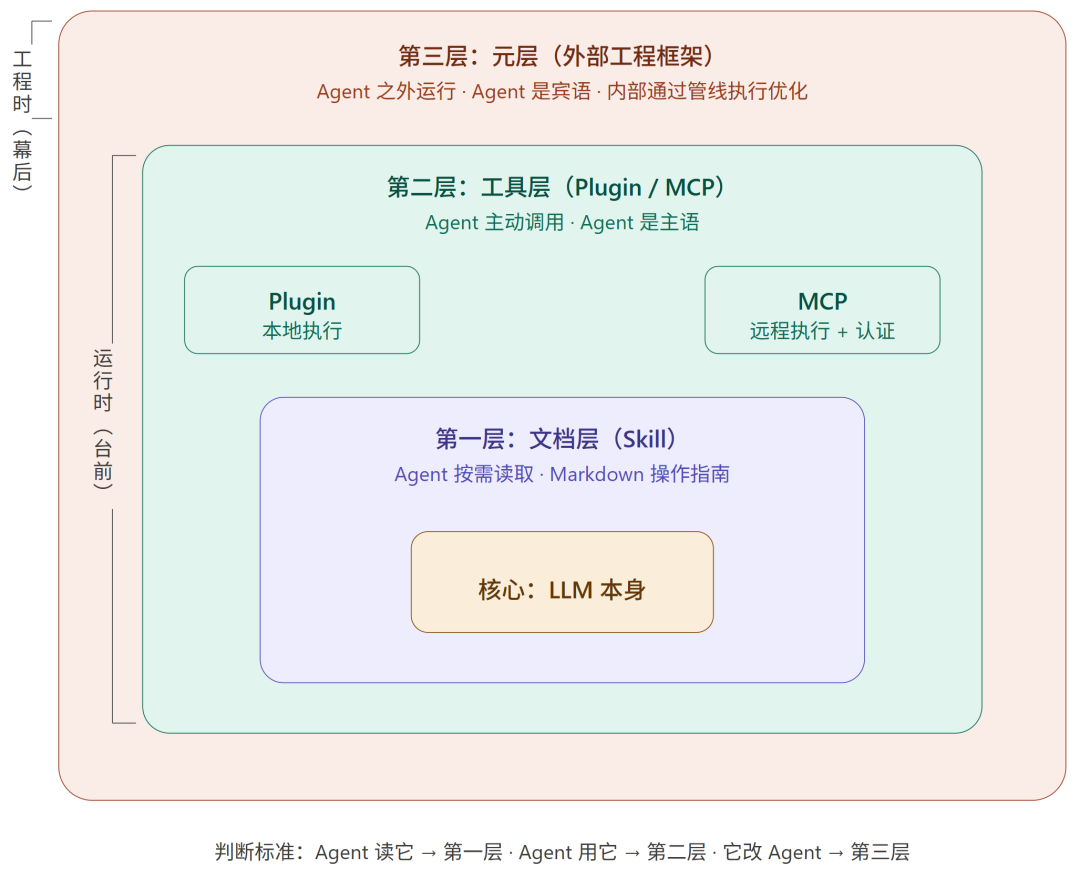
下次再遇到任何 Agent 相关的新名词,不用慌。问自己一个问题就够了:
在这个关系里,Agent 是主语,还是宾语?
答案会告诉你它属于哪一层,也会告诉你它到底是什么。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。如果你也在自己跑模型、写代码、做项目,欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。