不要随便用子代理(subagent)模式啊
背景
我最近在做一个叫"涌现实验室"的个人项目,每个主题需要一篇详细的项目文档。一篇文档大概1000-1500行,内容要求比较高。手动写太慢,所以决定用Claude Code来批量生成。
这个过程中我在"怎么组织AI代理"这件事上走了一些弯路,记录一下经验教训。
· · ·
一开始的做法
Claude Code有一个子代理功能。你可以在对话里启动多个子代理,每个子代理独立完成一个任务,并行跑。听起来很理想——8个代理同时写8篇文档,5分钟全部出来。
我就这么干了。第一批4个,第二批8个,第三批8个。每批确实是并行的,速度很快。
但跑了几批之后我开始算账。
每个子代理的token消耗大概在25000-30000之间。8个代理一批就是20多万token。而每篇文档的实际内容只有大概4000-5000 token。剩下的那两万多花在哪了?
拆开看:
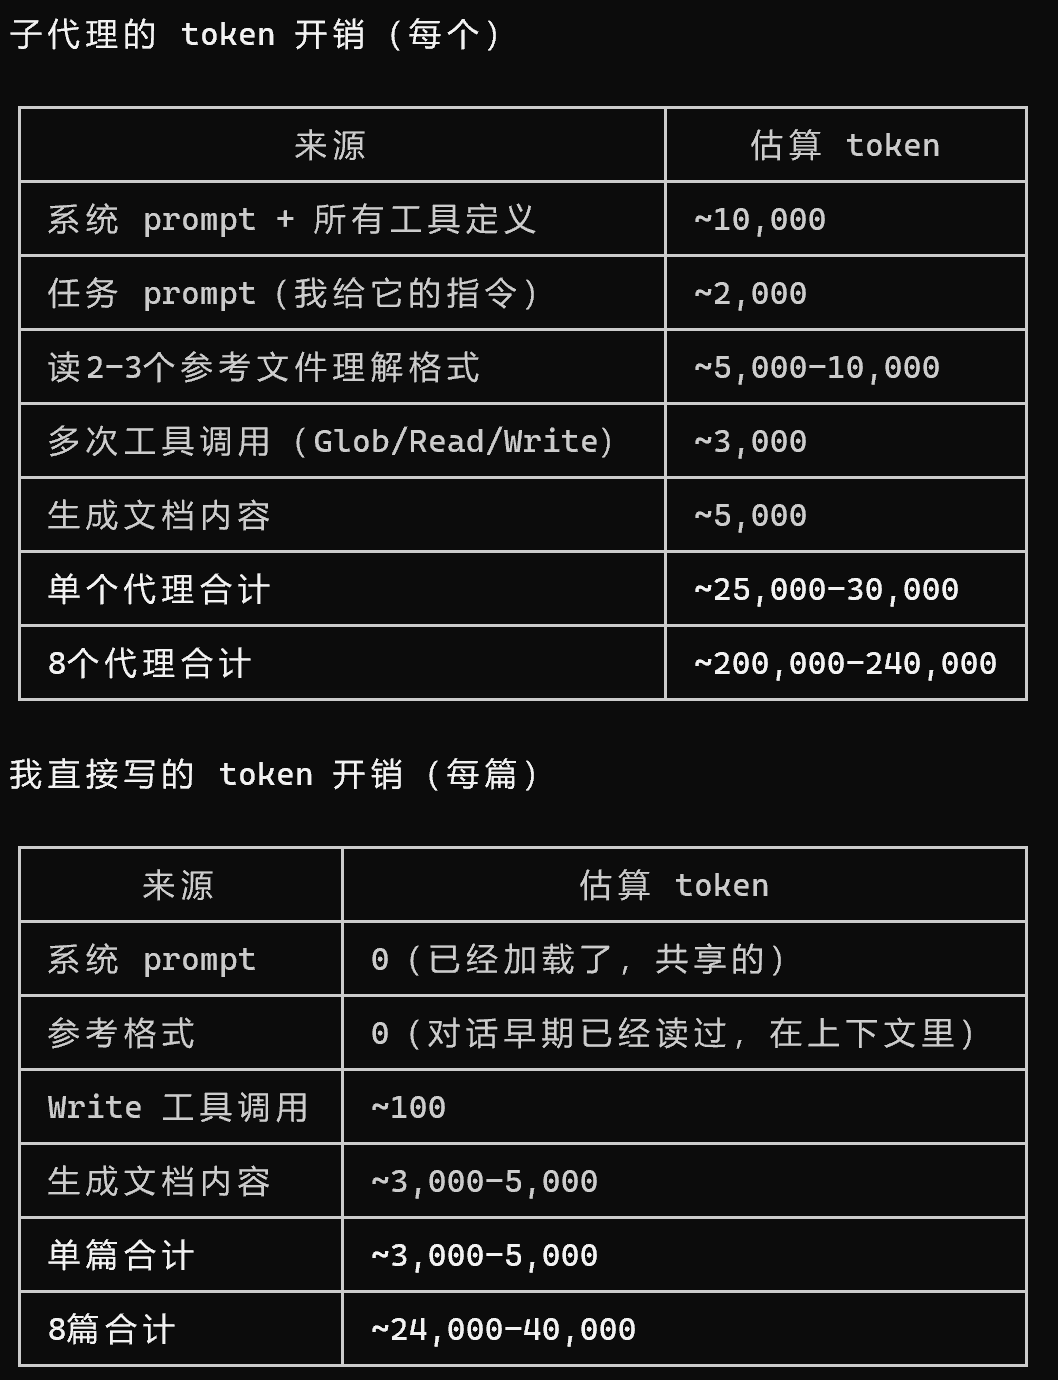
系统提示词和工具定义:约10000 token。每个子代理都要重新加载一遍。
读参考文件:约5000-8000 token。每个子代理为了理解文档格式,都要去读一两篇已有的文档。
工具调用开销:约3000 token。Glob找文件、Read读文件、Write写文件,每次调用都有额外的格式开销。
8个子代理就是8份系统提示词、8次读同一份参考文件、8套工具调用。同样的东西复制了8遍。
打个比方:我本来想让8个人同时干活提高效率,但每个人上岗前都要花半小时读同一本操作手册。8个人就是4小时在读手册,而真正干活的时间每人只有半小时。
· · ·
切换之后
后来我改成了最朴素的方式——主Agent自己直接写,一篇一篇来。
用Write工具直接把文档内容写到文件里。不启动子代理,不读参考文件(因为格式已经在对话上下文里了),不做多余的工具调用。
结果:
成本降到了原来的1/6到1/8。
而且直接写还有一个子代理做不到的好处:上下文是连续的。写EP134的时候,我知道EP133写了什么,能主动避开重复的论证思路和案例。子代理之间是完全隔离的,互相不知道对方写了啥,偶尔会撞车。
当然,代价是速度。子代理8篇并行5分钟出来,直接写8篇大概要15-20分钟。但token开销差了7倍。对我来说,这个取舍是值得的。
· · ·
到底什么是子代理、什么是Agent Team
经过这次实践,我觉得有必要说清楚这几个概念。
直接生成,就是你和一个AI对话,所有事情在一个对话里完成。上下文共享,知识不需要重新加载。就像你自己一个人做饭——食材在哪、调料在哪你都清楚,不需要跟任何人沟通。
子代理,是主AI调度出多个"分身"。每个分身拿到一个任务,独立干完交回来。分身之间不通信,互相不知道彼此的存在。就像你同时叫了8份外卖——每个餐厅独立做,做完送到你手上。快,但每份外卖不知道其他餐厅做了什么,可能点出8份差不多的菜。
Agent Team,是多个AI扮演不同角色,像团队一样协作。比如一个负责调研、一个负责写代码、一个负责审查代码质量。前一个的输出是后一个的输入,有明确的分工和交接。就像开一个餐厅——有人负责采购、有人负责切配、有人负责炒菜、有人负责摆盘,分工协作出一道菜。
三者的核心区别:
Agent Team比子代理还贵,因为除了每个代理各一份上下文之外,还有角色之间传递中间产物的开销。比如调研代理写了一份5000 token的调研报告,编码代理要把这5000 token全部读进去才能开始工作,审查代理又要把代码和报告都读一遍。信息在链条上被反复复制。
· · ·
什么时候该用哪种
这不是一个理论问题。从这次的经验里,我倒推出了一个判断方法:
看任务之间共享多少上下文。
如果8个任务用的是同一套格式、同一批参考资料、同一种思路——那就直接做。因为这些共享的东西在你的对话里只需要存在一份,子代理却要复制8份。我的文档生成就是这种情况。
如果8个任务各自需要不同的文件、不同的代码库、不同的知识——那子代理反而可能更省。因为你把8个任务的上下文全塞进一个对话里,对话会膨胀得很大,每一轮都要处理这个巨大的上下文。子代理各自拿一小份上下文,反而轻便。比如审查8个不同模块的代码,每个模块几百行,子代理各读各的比你在一个对话里读全部代码更高效。
如果任务不只是"分头干",而是确实需要不同的角色——一个调研、一个编码、一个测试、一个审查——那才是Agent Team的场景。典型的例子是做一个完整的功能:需要有人查API文档、有人根据文档写代码、有人写测试验证代码、有人从安全角度独立审查。每个角色需要不同的思维方式和关注点。
但Agent Team有一个前提条件——任务的产出必须是可以客观验证的。代码可以跑测试、API可以检查schema、数据可以校验格式。如果产出是一篇文章、一个方案、一段创意内容,没有什么东西能自动判断"对不对",Agent Team就很危险。因为链条上每个代理都可能引入偏差,没有验证器,你直到最后才发现跑偏了。
简单的判断流程:
同一种活干8遍?→ 直接做8种不同的活,各自独立?→ 子代理不同角色协作,有测试/编译器兜底?→ Agent Team不同角色协作,没有自动验证手段?→ 别用Agent Team,人盯着做
· · ·
多代理最大的坑:跑偏
这个问题在子代理里不太明显(因为各干各的,顶多质量参差不齐),在Agent Team里是致命的。
Agent Team本质上是一个链条:A的输出喂给B,B的输出喂给C。每一次传递都会损失信息、引入偏差。就像传话游戏——"明天下午三点在公园门口集合"传五个人之后变成"后天上午在商场集合"。
不是代理故意歪曲,是信息传递本身就有损耗。每个代理对指令的理解都有微小偏差,这些偏差在链条上累积。三个代理串联,最终产出可能已经偏离你的原始意图20-30%。
我总结了几个有效的对策:
锚定文档。不要让代理从上一个代理那里获取需求,让所有代理都直接读同一份需求文档。这样即使A的输出有偏差,B不会被A带偏,因为B是从源头获取需求的。链式传递变成星形结构,误差不累积。
人在关键节点。不是每一步都盯,而是在"方向可能分叉"的地方看一眼。调研做完了,花30秒看看方向对不对,再让编码代理动手。这30秒可能省掉后面几千token的返工。人是最高效的纠偏器。
严格的接口。代理之间传递的不应该是一大段自由文本,而应该是结构化的数据。比如调研代理输出一个JSON(API地址、认证方式、速率限制),编码代理只需要解析JSON就行。格式越严格,代理能"自由发挥"的空间越小,跑偏的概率越低。
可验证的产出。这是最关键的一条。如果你让代理写代码,可以跑测试来验证对不对。如果你让代理写文章,没有什么东西能自动判断好不好。代码重构适合Agent Team,因为有编译器和测试套件兜底。写公众号文章不适合,因为"写得好不好"只有人能判断。
有没有客观验证器,是决定多代理方案能不能用的分水岭。
· · ·
几句实话
跑完这些文档之后,我的感觉是:
多代理不是什么高级技巧。大多数时候,一个代理直接做就是最好的方案。简单、可控、省钱。
子代理的价值主要在并行加速。如果你赶时间,愿意用token换速度,它是有意义的。但要清楚你在为什么付费——很大一部分钱花在了重复加载上下文上。
Agent Team的价值在独立审查。一个代理写代码,另一个代理独立审查,这个"第二双眼睛"确实能发现问题。但前提是有客观的验证标准,否则审查代理可能只是在制造另一种偏差。
token不是免费的。架构选择就是成本选择。选择多代理之前,先算一下:这个任务的共享上下文有多少?重复加载的开销值不值得?有没有更简单的方式?
最后,至少在现阶段,人在loop里不是退步。AI代理很强,但它们在主观判断、方向把控、质量兜底这些事情上还需要人。把人从loop里拿掉不是效率提升,是质量风险。
这些是我从一次具体的批量生成任务中得到的经验。不一定适用于所有场景,但至少是真实的。
我建了一个AI学习群,目前几十来人,都是在真正动手学AI的人。如果你也在自己跑模型、写代码、做项目,欢迎加我微信,备注"你在做的AI方向",我拉你进群。纯围观的就不加了,群里大家都在真搞。