搞懂 Agent 架构,只需要想明白这 7 个问题
最近在啃一篇关于 Agent 工程实践的长文,边读边把不懂的地方拎出来反复追问,问完之后发现,整篇文章最核心的设计思想,其实就藏在这几个问题里。
如果你也在用 Claude Code、Cursor 或者自己搭 Agent,这些问题大概率你也会遇到。
· · ·
1. Agent 的"记忆"为什么不能只靠对话?
很多人以为 Agent 就是一个能调工具的聊天机器人,聊天记录就是它的全部记忆。但你仔细想,一个对话窗口只有 128k (或1m) token,Agent 每调一次工具,返回的 JSON 可能就几千 token。调三五次工具,搜两次代码库,上下文就满了一大半。
更要命的是,这些 JSON 里大部分内容 Agent 根本不需要,但它们一直占着位置,把真正重要的信息(比如你一开始说的需求、之前做的架构决策)挤到了注意力的边缘。
这就是所谓的 Context Rot——上下文里噪声越来越多,Agent 的决策质量就越来越差。很多看起来像"模型变笨了"的问题,其实是上下文被垃圾信息淹没了。
解决思路:把上下文当内存,把文件系统当硬盘。
工具返回的大量数据,不要直接塞进对话,而是写成文件存到磁盘。Agent 需要的时候用 grep 或脚本按需读取,只把需要的几行拉进上下文。Cursor 把这种方式叫 Dynamic Context Discovery——默认少给,需要时再读。
他们做过 A/B 测试,MCP 工具调用的总 token 消耗减少了 46.9%。
2. Session 是什么?为什么任务会"做不完"?
Session 就是一次对话会话。你跟 AI 聊天,从开始到关闭,这就是一个 session。对于 Claude Code 这样的编程 Agent,从启动到退出也是一个 session。
问题在于:上下文窗口是有限的,但任务可能是无限的。
你让 Agent 搭一个完整的电商网站,它可能写了用户登录模块,上下文就快满了。Session 不得不结束,但支付、订单、后台管理都还没做。
更糟的是,下一个 session 启动时,Agent 的记忆是空白的。它不知道上个 session 做到哪了,哪些文件已经写好了,接下来该干什么。结果要么从头再来,要么做了重复的事,要么以为任务已经完成了。
3. 怎么让任务跨 Session 继续?
答案是:把进度从 Agent 的脑子里搬到文件里。
具体做法是把长任务拆成两个角色:
Initializer Agent(项目经理)只跑一次,负责规划:
把大任务拆成子任务清单(feature-list.json)
搭好项目骨架(init.sh)
创建进度文件(claude-progress.txt)
做第一次 git commit
Coding Agent(程序员)反复跑很多轮,每次:
读进度文件,找到下一个没做的任务
实现它
跑测试
更新进度,git commit
退出
下次启动新 session,Coding Agent 读一下文件就知道该从哪继续。即使中途崩溃,也能从文件系统里恢复,而不是靠"回忆"上一轮对话。
为什么要分两个 Agent?因为规划和执行混在一起,一个 session 可能光规划就用完了上下文。分开之后,规划只跑一次,执行每次只做一件事,职责清晰,出错好排查。
4. 在 Claude Code 里,我需要哪些文件?
三个文件就够了:
CLAUDE.md——项目规范和约束。技术栈是什么、代码风格怎样、测试怎么跑。它回答"怎么做"。
todo.md(或 progress.json)——任务清单和完成状态。哪些做了,哪些没做。它回答"做什么,做到哪了"。
.claude/commands/next-task.md——自动化每轮工作流。这是一个自定义命令,内容是一段提示词,告诉 Agent 每次该怎么操作那张清单。
有人会问:todo.md 和 next-task.md 能不能合成一个?不建议。todo.md 是数据,每完成一个任务就改一次;next-task.md 是指令,定好就基本不变。读写频率完全不同的东西放一起,Agent 改清单时容易误改指令。
而且自定义命令必须放在 .claude/commands/ 目录下,天然就是独立文件。有了它,你每次启动 Claude Code 只需要输入 /next-task,不用手动重复描述工作流。
5. 记忆整合失败了怎么办?
Agent 对话越来越长,上下文总会接近上限,这时候需要"压缩"——把旧消息变成摘要,腾出空间。
但压缩是有风险的。如果摘要生成失败了(比如 API 报错),旧消息岂不是丢了?
好的设计是这样的:系统只移动指针,永远不删除原始数据。
成功路径:LLM 把旧消息压缩成摘要 → 追加到 MEMORY.md → 更新指针(标记这些消息已处理)
失败路径:摘要失败 → 把原始消息完整写入 archive/ 目录 → 数据不丢,下次可以重试
这就是"有损但可追溯"——平时只看摘要(有损),但原始数据一直在文件里,需要时可以找回来(可追溯)。和直接截断删除相比,这是一个本质的区别。
6. 为什么框架内部消息不能全给 LLM 看?
Agent 框架运行时会产生很多内部事件:"第 30 轮触发了上下文压缩""调用搜索工具超时已跳过""给用户推送了一条通知"。
这些信息框架自己需要记住,方便调试和回溯。但大模型完全不需要知道这些——它看到"压缩发生了"也不知道该怎么处理,白白浪费 token。
所以框架层要分两种消息:AgentMessage 给应用层用,可以带任意自定义字段;Message 给 LLM 用,只保留 user、assistant、tool_result 三种标准类型。发给 LLM 之前过滤一遍,内部事件不传。
类比一下:公司内部系统记录了"小王请假导致任务延期""服务器挂了重启了一次",但给客户看的邮件里只有正式的项目进展,内部细节不需要暴露。
7. 为什么 Agent 还需要后台架构?
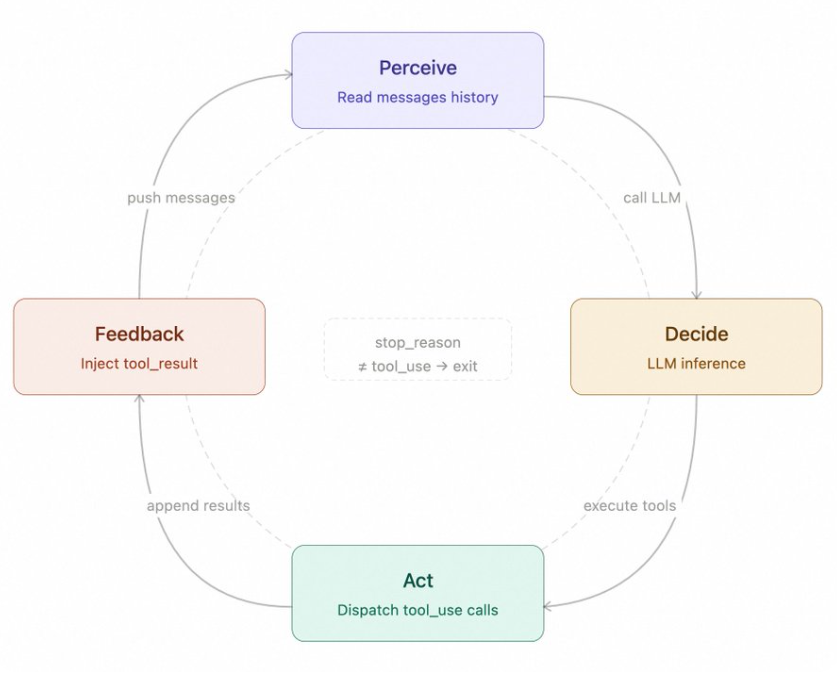
Agent 的主循环是:LLM 思考 → 决定下一步 → 执行 → 拿到结果 → 再思考。
问题出在"执行"这一步。如果 LLM 说"跑一下测试",测试要跑 3 分钟,整个循环就卡住了——干等 3 分钟什么都不做。
解决方法是把慢操作扔到后台线程跑,主循环继续做别的。后台跑完了把结果丢进一个通知队列,主循环每轮开始前瞄一眼:"有新结果没?有就拿来用,没有就继续。"
就像你是厨师,炖汤要 40 分钟,你不会站在锅前干等。汤放灶上(后台线程),你去切菜炒别的(继续循环),定时器响了(通知队列)再回来处理。
· · ·
写在最后
回过头看这 7 个问题,其实都在指向同一个核心思想:
Agent 的能力上限,不是由模型决定的,而是由围绕模型的工程基础设施决定的。
上下文管理、文件系统、进度持久化、消息分层、后台调度——这些看起来不性感的工程问题,才是决定 Agent 能不能稳定跑起来的关键。
模型是引擎,但没有底盘、变速箱和刹车系统,引擎再强也跑不远。