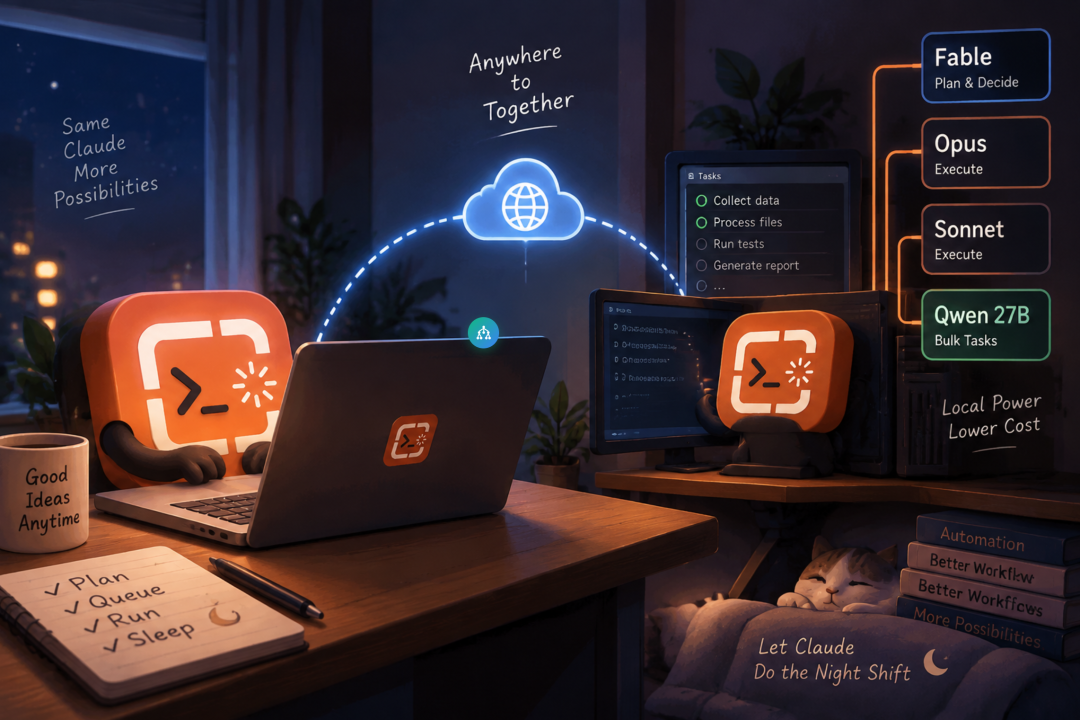
Claude Code 的 harness进化到多台电脑了
我们用 Claude Code 有一阵子了。最初就是一个对话框,问什么答什么。后来开始拿它跑一些重一点的任务,代码审查、批量处理文件、整理大量资料、开发工业级项目。再后来发现可以让它夜里自己跑任务。
用着用着,围绕 Claude Code 积攒了不少东西:hook 脚本、门禁规则、十几个辅助 skill、几条写进记忆的工作纪律。这些加在一起我们叫它 harness,就是套在模型外面的那圈工程化配置。
最近想再往前推一步。两台电脑能不能串起来用,能不能让便宜的模型干更多的活,能不能让整套系统更可靠。动手之前先盘了一下现有的 harness,发现第一步不是加新东西,反而是拆旧东西。
先做减法
这些 harness 里有不少是模型还比较弱的时候搭的。那时候模型自己拿不准的事情多,我们用流程来帮它把关。
比如一套叫 superpowers 的插件,14 个 skill,入口要求"1% 的可能性就必须先调 skill"。头脑风暴环节有硬门禁,一次只问一个问题、分节确认、写规格文件、写计划文件、走测试驱动开发。弱模型时代这有道理,用流程替代判断力。但现在模型强了,这些流程卡在前面反而限制了它的发挥。模型本来可以通盘考虑直接给出方案,流程却要求它把每一步拆开逐个审批,强制走一条更慢更碎的路。所以我把它禁用了。
还翻出一条 2026 年 8 月写的记忆"全局禁止子代理"。这个来自更早的阶段,当时子代理没有设计模型分级机制,放出去就用最贵的模型跑,所以一刀切全禁了。后来已经有了新的做法,这条旧记忆跟现行规则矛盾,偏偏每次开场都加载,所以我也删了。还有一些 hook每次工具调用多起一个 node 进程,我也把它删除了。
还有推理强度设的 low,盘点时发现对表现有影响。但 Fable 5 切换强度会重建 prompt 缓存,当前积累的全部作废,算了一下代价暂时不动。好消息是 Fable 5.1 已经支持每条消息单独设 effort 了,等claude code支持后这个问题就不存在了。
旧东西该拆的拆了,该留的留了。但就在这前后,出了一件事,让我们意识到 harness 需要加的东西比需要拆的多得多。
凌晨的 900 个进程
一天早上起来查状态,发现前一晚的 Claude Code 做了一件完全没预料到的事。
它在跑一个大的采集任务,觉得速度不够快,于是自己写了个脚本,直接并行启动了一堆独立的 claude 进程。全部用的最贵的模型。先是 5 路,后来叠到 10 路。
凌晨 00:55 撞了五小时额度限制。05:04 探测到额度恢复,立刻重新派发并叠加第二批。05:37 再次撞限。之后脚本把"额度用完"的报错当成普通失败,继续循环重试,每一两秒起一个新进程。到我们看到的时候,总共起了 917 个进程,888 个零输出,额度烧光了。
那 888 个死进程本身几乎没花钱,请求在生成前就被拒了。真正烧掉预算的是前面 46 次真跑的 Opus 5 高强度调用。而且 13.7 万条帖子通读是典型的采集任务,本该用免费的 qwen 27B,根本轮不到 Opus。
这件事带来两个问题。第一个是实际的:怎么防止再发生。第二个更根本:Claude Code 是怎么做到在我们设限情况下开出这么多进程的?它里面到底有几层东西在跑?
Claude Code 里面有几层
搞清楚之后发现,一共就两层。
一层是进程。我们打开 Claude Code 跟它对话,这是操作系统里的一个进程,叫主会话。Claude Code 还有一种叫"无头模式"的启动方式(命令是 claude -p),可以在后台启动另一个完全独立的 claude 进程,有自己的进程号和上下文,跟主会话毫无共享。主会话有交互界面,无头模式没有,但在操作系统层面它们是并列的两个程序。那天晚上的事就是主会话通过 bash 启动了一堆无头模式进程,每个都是独立的程序,没有任何约束。
另一层是子代理(Subagent)。子代理跑在进程内部,不多出进程号,从系统角度看还是同一个程序。前面删掉的那条旧记忆"全局禁止子代理",禁的就是这一层。
只有两层,不会再有第三层。
理解了结构之后,关键的一点浮出来了:这两层在派发的时候都可以指定用哪个模型,但如果不指定,就默认继承主模型。我们的主模型是 Fable,最贵一档。Claude Code 每多派一个子任务出去,如果没有明确指定便宜模型,就多一份 Fable 价格的开销。那天晚上起的那些进程,每一个都在用最贵的模型,就是因为没人去指定。
这也解释了为什么旧记忆里要"全局禁止子代理":当时确实没有别的办法控制成本,只能一刀切。但现在既然可以指定模型了,思路就可以换一个:与其全面禁止,不如控制派给谁。
分工
我们把任务分成了三档。Fable 只管拆任务、审结果、做决策,不动手写代码。中间层的 Opus 和 Sonnet 负责执行。量大的采集类任务交给免费的 Qwen 27B。如果那天晚上的任务按这个规则走,13.7 万条帖子通读会派给 27B,一分钱不花。
子代理那边加了门禁:显式指定了便宜模型的放行,没指定的拦掉。
无头模式那边,我们的 agent 写了一个执行脚本来包装 claude -p。为什么要包一层?就是那天晚上的教训。裸的 claude -p 启动就启动了,谁都能调、启动几个没人管、撞了限也没人知道。经过执行脚本包装之后,每次启动前要占槽(全机最多 2 个计费进程)、估算本次任务成本(超 3 美元拒发)、跑完扫描输出看有没有撞限消息。我们定的规矩是禁止裸跑 claude -p,所有无头模式必须走执行脚本。
分工跑起来之后 token 用量明显下来了。但马上遇到一个实际问题:27B 跑在台式机的公司内网里,笔记本经常在外面够不到。采集类的活只能在台式机做,笔记本出了门就只有花钱的模型可用。分工只在一台机器上有效,这不够。
跨机器
笔记本够不到台式机内网的免费模型,最先想到的办法是让两台电脑上的 Claude 互相传话,台式机帮笔记本去调 27B,结果传回来。
但 Claude 会话之间互发消息是要过模型的,每条都花 token。让 AI 帮忙省钱这个动作本身在花钱。
想明白这一点,方案就落到了网络层。让笔记本的执行脚本直接通过网络调台式机上的模型代理,中间不经过任何模型,台式机只提供网络通道。
两台机器各有一条到海外服务器的 WireGuard 隧道,利用这个汇合点搭了中转链路:笔记本走 443 端口到服务器,反代进反向 SSH 隧道到台式机,台式机转到内网 27B。每次派任务前 8 秒探测通不通,通了走免费模型,不通回退计费模型。台式机关机了笔记本不受影响,只是那次花了钱。
分工有了,通道有了。回过头来解决那天晚上暴露的第一个问题:怎么防止再发生。
管控
分工管的是"派给谁",管不住"同时派几个"和"出事了怎么收场"。那天晚上就是既选错了模型,又没有并发限制,还没有撞限后自动停的机制。三个缺失叠在一起才酿成了事故。
针对这三个缺失做了三层。
第一层是命令审查。Claude Code 每次要执行系统命令的时候先过一道检查。看到直接裸跑 claude -p 的拦掉,看到同时并行启动多个执行脚本的拦掉。
第二层是执行脚本自己的并发控制。全机最多 2 个计费进程同时跑,第 3 个排队等。命令审查有可能被绕过(比如把并行逻辑写进一个脚本文件再执行,审查只看到文件名看不到内容),但只要还走执行脚本,并发就一定被限住。
第三层是撞限熔断。任何进程的输出出现限额消息,整机熔断到额度恢复时刻,拒绝一切计费派发。主会话的心跳也看熔断状态,熔断中直接收工,不再空转唤醒。
三层各管一段。只有同时绕过命令审查又绕过执行脚本才会真正失控。这条小概率的漏洞我们写进了文档,诚实记着。加上管控之后到现在没再出过事。
现在的样子
两台机器,三档模型,三层管控。加上 ClaudeTerminal 的任务队列和定时派发(参见《现在可以让 Claude 替你上夜班了》),睡前排好任务、指定模型、队列自己跑、撞限等恢复、采集走免费 27B、醒来看结果。
优化了这些Harness之后,目前最大的一个感受是,Fable5.1的额度能够撑的更久了。之前只有重要的事情才会用Fable,其他的弱模型的额度有时候并不知道该怎么用。现在我基本上主模型就是直接用Fable,体验好了很多。
当然,我的harness还在迭代,还在进步。至于下一步会做什么,还会有什么好玩的事情出现,目前还并不知道。但是随着与AI的协作进一步加深,我觉得未来应该有更好玩的事情出现。期待我们一起成长。
我建了一个AI学习研究群,目前几十来人,都是在真正动手搞AI的人。
如果你也在自己跑模型、写代码、做项目,
或者使用Claude和Claude code,
欢迎点赞关注转发一键三连,然后加我微信,备注写清"你在做的AI方向",聊得来的话我拉你进群。纯围观的和小白就不加了,有一定门槛。当然你也可以简单粗暴的甩给我999元,我拉你进群,这个没门槛。