【Anima 创世纪】Agent 的记忆和经验,完全不是一回事
所有人都在给 AI 做"记忆"。
向量数据库、RAG 检索、对话历史、系统提示词——2025 年以来,"让 AI 记住东西"几乎成了 Agent 领域最卷的赛道。每一个新框架发布时都会强调自己的记忆系统有多强大:存得多、检索快、支持长上下文。
但很少有人停下来想一个问题:
记住了很多东西的人,和经验丰富的人,是一回事吗?
· · ·
背百科全书的人 vs 摸爬滚打十年的人
想象两个人。
一个在图书馆待了十年,读了几千本书,记住了海量的知识。另一个在行业里摸爬滚打了十年,经历了无数项目的成败。
现在给他们同一个问题:"这个季度用户留存率下降了 5%,怎么办?"
图书馆那位会告诉你:"留存率的计算方法是……影响留存的常见因素有……行业平均水平是……"他给你的是检索结果——准确、全面、但泛泛。
行业老兵会说:"上次我们也遇到过类似的情况,后来发现是新渠道带来的用户质量差。你先按渠道分群看一下,大概率问题出在那里。"他给你的是经验判断——具体、有方向、带着从失败里学到的直觉。
差别在哪?
不在于他们"知道"什么——两个人可能知道完全一样的知识。差别在于,行业老兵的知识之间形成了结构。"留存率下降"这个信号一出现,他的大脑自动沿着"上次类似的情况 → 渠道质量问题 → 分群分析"这条路径走了下去。这条路径不是别人教的,是他自己的经历刻出来的。
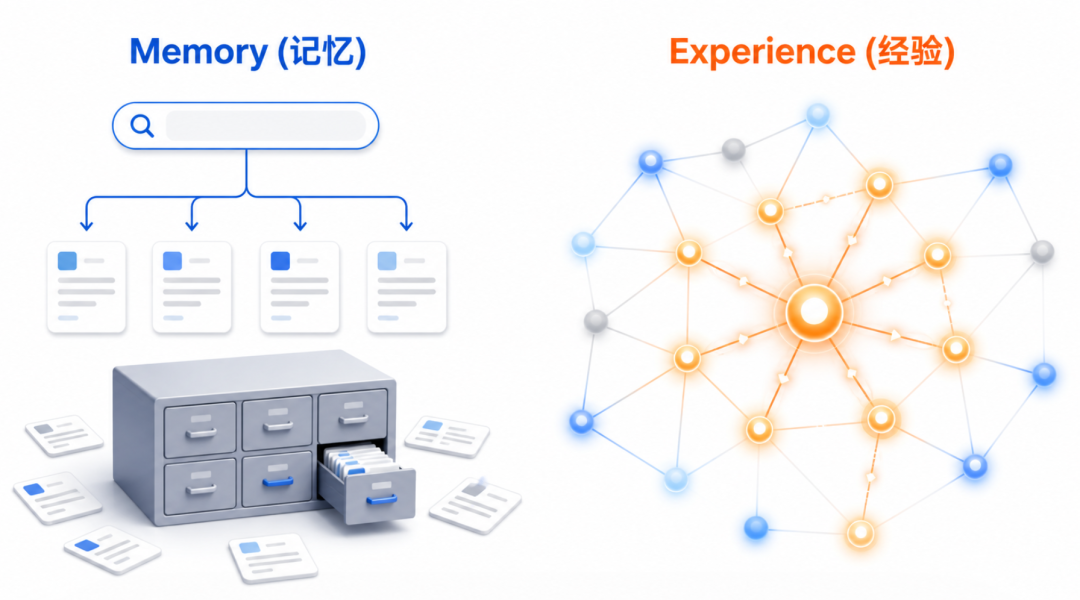
这就是记忆和经验的本质区别:
记忆是"我知道什么"。经验是"我的知识之间如何连接"。
· · ·
当前所有 AI 的"记忆",都是图书馆
让我们诚实地审视一下现在的 Agent 记忆系统在做什么。
向量数据库 / RAG:把过去的对话、文档、笔记变成向量,存进去。新问题来了,找最相似的几条,塞进提示词。这是检索,不是经验。
对话历史:把最近几轮对话放进上下文窗口。LLM 能看到"刚才说了什么",但关掉对话就忘了。这是短期记忆,连长期记忆都算不上。
CLAUDE.md / 系统提示词:人工写一段"你是谁、你擅长什么、用户偏好什么"。这是人工配置,不是学习。
所有这些方案的共同特点是:它们是扁平的。
一条记录就是一条记录。第 1 条和第 100 条之间没有关系。检索的时候,系统找的是"跟当前问题最像的那条记录",而不是"从当前问题出发,沿着因果链能走到什么地方"。
用人的比喻来说:这些系统让 AI 变成了一个有超强记忆力但没有工作经验的新人。他能快速翻出任何一条笔记,但他不知道这些笔记之间是什么关系,不知道哪条路走得通、哪条路是死胡同。
· · ·
"经验"到底是什么?一个更精确的定义
如果记忆是"存储和检索",那经验是什么?
认知科学给了一个很好的模型:激活扩散(Spreading Activation)。
人的记忆不是一个文件柜——你不是打开抽屉、翻找、取出来。人的记忆是一张网。每个概念是一个节点,概念之间通过各种关系(因果、相似、时间顺序)连接。当一个概念被触发时,激活信号会沿着连接自动扩散到相关概念。
关键在于:每个人的这张网是不一样的。
同样是"用户留存"这个概念,在数据分析师的脑子里,它连着"分群分析"、"SQL 取数"、"漏斗图"。在后端工程师的脑子里,它连着"埋点 SDK"、"日志系统"、"数据库索引"。
同一个刺激,不同的网络拓扑,激活出完全不同的东西。
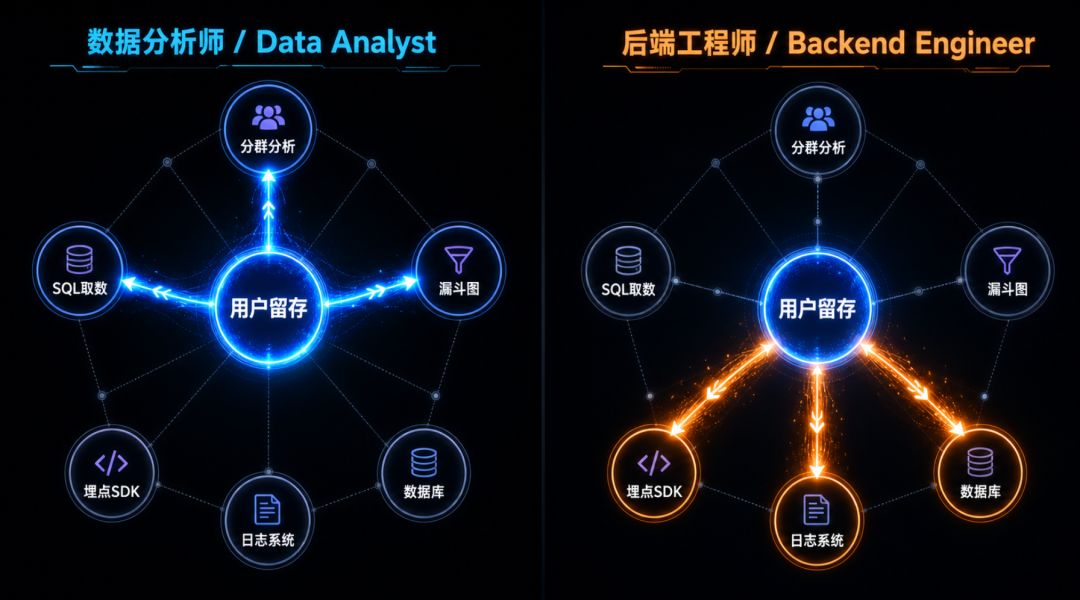
这就是为什么两个人知道一样多的东西,但面对同一个问题反应完全不同。不是因为他们记住的内容不同,是因为他们的"网"长得不一样。而这张网的形状,是被各自的经历塑造出来的。
· · ·
同样的知识,不同的结构,不同的路径
让我用一个具体的例子说明这一点。
假设两个 Agent 都学了完全相同的三样东西:SQL 查询、Python 数据处理、业务指标定义。
Agent A 跟着一个数据分析师工作。日常工作流是"先看指标定义 → 再写 SQL 取数 → 最后用 Python 画图"。时间长了,这三块知识在 A 的内部形成了一条流水线:
指标定义 → SQL取数 → Python可视化Agent B 跟着一个后端工程师工作。日常习惯是"Python 写业务逻辑 → SQL 做持久化 → 偶尔看看指标做监控"。同样三块知识,在 B 的内部形成了完全不同的结构:
Python(核心) → SQL(存储工具) → 指标(边缘参考)现在来了一个新问题:"这个月用户留存率下降了,帮我看看怎么回事。"
A 的路径:先找留存率的指标定义 → 构造 SQL 查询拉细分数据 → 用 Python 做趋势分析。自然流畅。
B 的路径:先想怎么用 Python 写一个分析脚本 → 然后才去想 SQL 怎么取数 → 指标定义可能根本想不起来用。
同样的知识,不同的结构,面对同一个新问题,走出了不同的路径,得到了不同质量的结果。
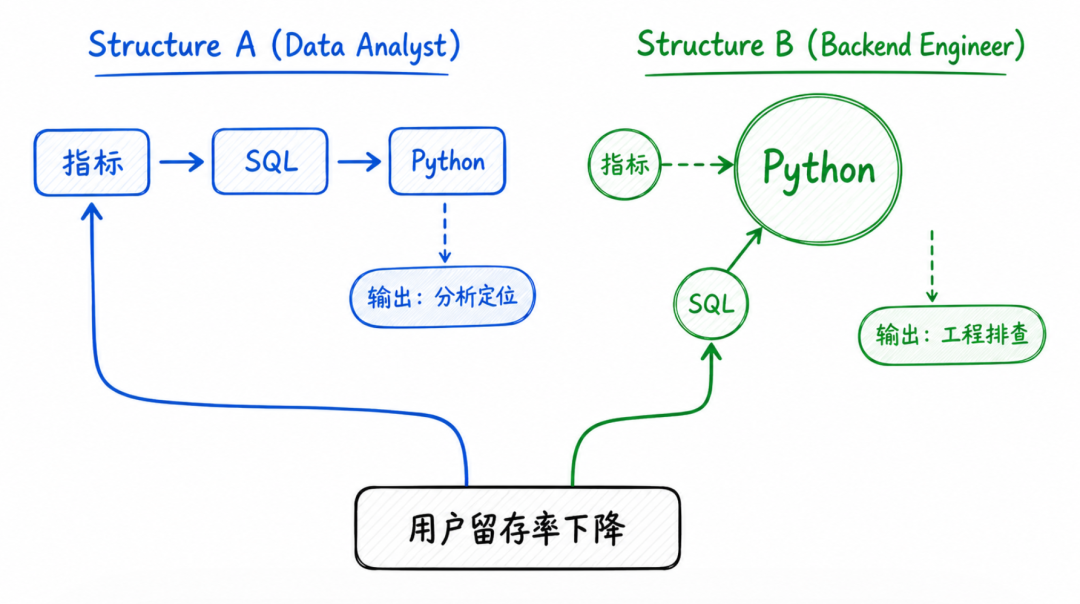
这就是为什么"安装相同的 Skill"不等于"拥有相同的能力"。结构本身承载了意义,而结构是被主人的使用模式塑造出来的。
· · ·
我们试着做了一个
之前,我写了一篇文章讨论未来的Agent该是什么样的?。很多人问:这个想法能实现吗?
我们决定试试。
于是有了 Anima(来自拉丁语,原意是"灵魂",后发展成描述人格中深层的、内在的心理学术语)——一个开源的 AI Agent 个性层框架。它的核心不是给 AI 做更好的"记忆",而是给 AI 做"经验"。
具体来说,我们做了三件事:
第一,用图结构代替向量数据库。 Agent 的每一次经历不是存成一条记录,而是变成图谱中的节点和边——任务、概念、问题、解决方案之间通过因果、相似、时间等关系连接。新经历进来时,不是"加一条记录",而是重组局部结构——就像人脑中新经验会改变已有的神经连接。
第二,用激活扩散代替相似度检索。 面对新任务时,不是去找"最相似的历史记录",而是从任务相关的概念出发,沿着图谱的连接自动扩散,看哪些经验被"点亮"。不同的图谱拓扑导致不同的激活模式——这就是为什么两个 Agent 面对同一问题会"想起"不同的东西。
第三,从反馈中学习"怎么做"而不只是"知道什么"。 当你说"这次做得好",系统不只是记住这条反馈——它会强化相关的策略偏好、更新做事方式的优先级、调整能力画像。时间长了,Agent 形成了自己的"做事风格"。
它可以作为 Claude Code 等 Agent 的插件使用,也可以独立运行。支持通义千问、DeepSeek、GPT 等所有主流大模型。
· · ·
我们不知道它到底有多好用
说这话不是谦虚,是实话。
我们可以证明机制在工作——两个 Agent 经历不同的任务后,确实会发展出不同的能力画像、不同的策略偏好、不同的经验联想。从完全相同的起点出发,十几次交互后能力相似度就降到了 56%。从数据上看,它们确实变成了两个不同的"人"。
但我们无法证明这些差异在实际使用中有多大价值。
原因很简单:经验需要时间。
一个人的"经验"不是三五天能形成的。一个有经验的数据分析师,是在几百次分析任务中逐渐形成直觉的——知道哪些数据要先清洗、知道什么图表对不同的人有效、知道哪些指标是噪声。这种积累不可能靠十几次交互就验证出来。
如果一个框架声称"装上就比别人好用",那大概率是在骗人。真正有意义的差异化需要时间、需要积累、需要每一次使用中的反馈慢慢塑造。
这也恰恰是这件事最有意思的地方:如果真的有效,那它的价值会随时间指数增长——用得越久,Agent 越不可替代。但前提是要有足够多的人,在足够真实的场景下,用足够长的时间来验证。
所以我们决定把它开源。
· · ·
你可以怎么参与
Anima 现在是 Alpha 阶段。你可以通过两种方式使用它:
作为插件: 给 Claude Code 装上记忆能力。安装不到五分钟,不喜欢可以随时卸载,完全不影响 Claude Code 的原有功能。所有 Agent 数据存在本地,卸载后没有任何残留。
独立使用: 一个命令启动一个有记忆的 AI 助手。支持通义千问、DeepSeek、GPT 等所有 OpenAI 兼容 API。
GitHub:https://github.com/guoy0701/AnimaAgent
有想法、有反馈、或者只是想聊聊 AI Agent 的未来,欢迎加我微信,我们也有一个专门学习AI的小群,“真搞AI学习群”,加我拉你进群,目前还是免费开放中。
我特别想知道的是:在你的实际工作场景中,一个"有经验"的 AI 和一个"有记忆"的 AI,你觉得差别会有多大?